静态收缩绕过Transformer Softmax:一种注意力优化新思路
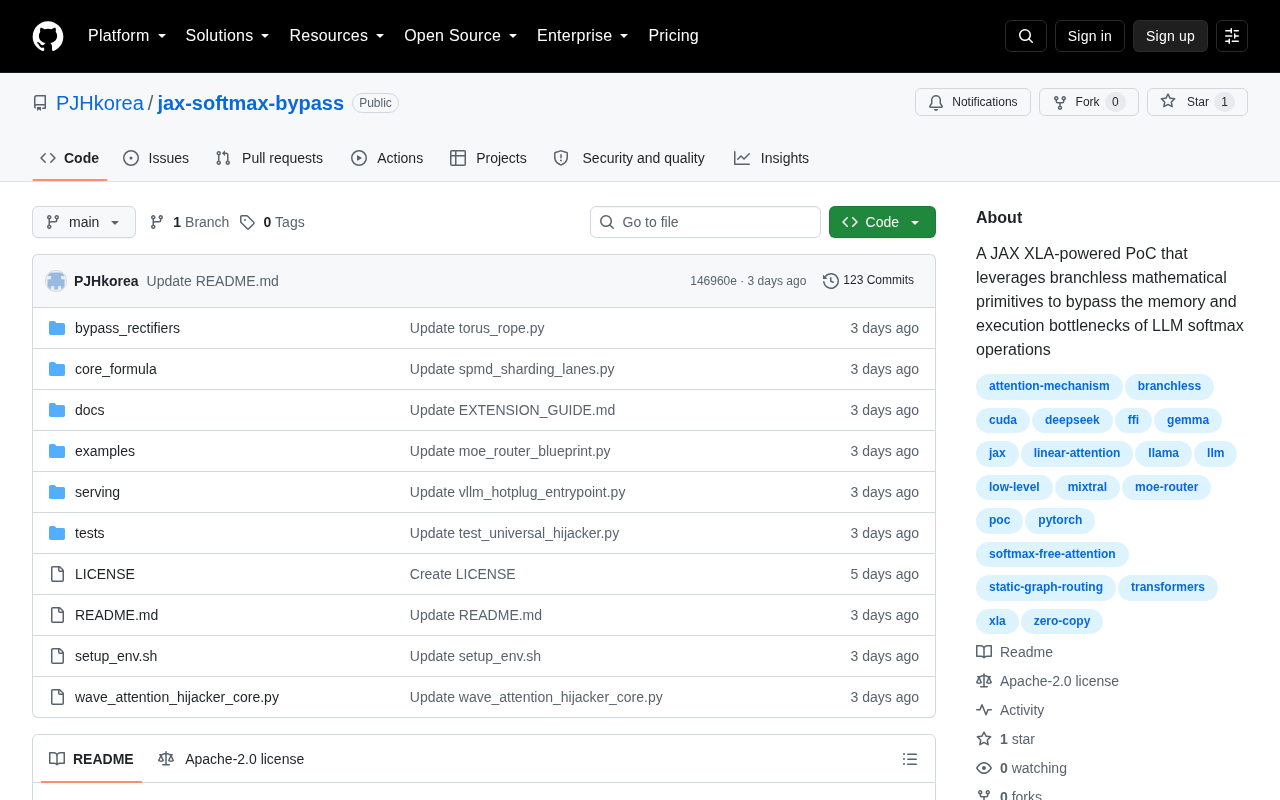
一个探索用静态张量收缩替代Transformer中Softmax的开源项目,方向有价值但尚缺实证支撑。
本文围绕一个在Hacker News发布的早期项目展开分析——该项目声称可通过"静态收缩"(Static Contraction)绕过Transformer中的Softmax操作。Softmax是自注意力机制的核心组件,负责归一化注意力权重,但其指数运算、逐行归一化特性使其成为低精度部署和长序列场景下的性能瓶颈。静态收缩的思路延续了学界对线性注意力的长期探索,潜在优势包括消除指数运算、提升编译期可优化性以及降低量化难度。然而,核心挑战在于Softmax的"竞争性"注意力分配赋予了模型强大的表达能力,历史上线性化方案普遍在精细语义任务上有所妥协。由于该项目目前缺乏技术文档和基准数据,作者建议保持审慎关注,待完整实验结果出现后再做判断。
背景:Transformer中的Softmax瓶颈
在标准的Transformer架构中,注意力机制(Attention)的核心计算之一就是Softmax操作。它负责将注意力分数归一化为概率分布,决定每个token对其他token的关注程度。然而,Softmax同时也是整个自注意力计算中一个不可忽视的性能瓶颈——它涉及指数运算、逐行归一化以及全局依赖,难以并行化和量化,在长序列场景下尤其消耗资源。
近期一则在 Hacker News 上以 "Show HN" 形式发布的项目提出了一个有趣的方向:通过静态收缩(Static Contraction)绕过 Transformer 中的 Softmax。虽然目前该帖子的公开信息有限(发布时仅有 4 个点赞、暂无评论),但这一命题本身触及了当前大模型效率优化的关键议题,值得展开讨论。
什么是"静态收缩绕过Softmax"
从标题所传达的技术意图来看,"静态收缩"(Static Contraction)指的是用某种预先确定的、结构化的张量收缩(tensor contraction)操作来替代或规避运行时的动态 Softmax 归一化。
张量收缩是线性代数中对多维张量沿指定维度求和的通用操作,矩阵乘法本质上就是一种张量收缩。如果能将注意力权重的计算重构为一系列静态的、可预先编排的收缩操作,理论上可以带来几点好处:
- 消除指数运算:Softmax 依赖
exp()计算,数值上敏感且难以低精度量化。移除它有助于简化数值路径。 - 提升可并行性:静态收缩的计算图在编译期即可确定,更利于硬件调度与算子融合。
- 降低内存与带宽压力:避免逐行归一化时的中间状态存储。
需要强调的是,这类思路在学术界并非孤例。近年来已有多项研究探索"线性注意力"(Linear Attention)、"无 Softmax 注意力"以及各种核方法(kernel methods)近似,试图用线性复杂度替代标准注意力的二次复杂度。该 Show HN 项目可以看作这一大方向下的一次工程实践尝试。
潜在价值与技术意义
效率与部署友好性
Softmax 的移除或替代,对于推理效率优化具有直接意义。在边缘设备和低精度推理(如 INT8/INT4 量化)场景下,指数运算往往是量化误差和计算开销的集中来源。若静态收缩能在保持模型表达能力的前提下绕过这一环节,将对模型部署的成本结构产生实质影响。
表达能力的权衡
任何绕过 Softmax 的方案都必须回答一个核心问题:是否会损失模型的表达能力? Softmax 提供的非线性归一化和"竞争性"注意力分配(即让少数 token 获得更高权重)是 Transformer 表现优异的重要原因之一。静态或线性化的替代方案历史上常常在长距离依赖建模和精细语义区分上有所妥协。这一项目能否在实证上跨越这道坎,是判断其价值的关键。
保持审慎:信息尚不充分
必须客观指出,截至目前这条 Show HN 帖子的公开信息非常有限——没有配套的技术说明摘要、基准测试数据,也没有社区讨论(0 条评论),点赞数也仅为个位数。这意味着:
- 我们无法验证"静态收缩"方案在真实模型上的精度表现;
- 无法确认其相对标准注意力或现有线性注意力方案的具体加速比;
- 也无法判断它是通用方法还是仅适用于特定任务/架构。
对于任何声称"绕过"核心组件的方案,社区通常会要求在标准基准(如语言建模困惑度、长序列任务)上给出对照实验。在这些数据出现之前,最理性的态度是保持关注但不下定论。
对从业者的启示
即便这个具体项目的最终效果尚待验证,它所代表的思考路径对 AI 工程师和研究者仍有启发意义:
- 重新审视"默认组件":Transformer 的许多设计已被视为理所当然,但 Softmax、位置编码、LayerNorm 等每一个环节都可能存在优化空间。
- 编译期静态化的趋势:将运行时动态计算尽可能前移到编译期,是提升硬件利用率的重要工程方向,这与近年来算子融合、图优化的整体趋势一致。
- 效率与精度的持续博弈:大模型的落地始终在"更快"与"更准"之间寻找平衡点,此类探索正是这一博弈的具体缩影。
结语
"通过静态收缩绕过 Transformer Softmax" 是一个方向正确但尚需实证支撑的探索。它触及了大模型效率优化中最本质的问题之一,也延续了学界对无 Softmax 注意力的长期兴趣。建议关注该项目后续是否会释出完整的技术文档与基准测试——那才是评判其真正价值的依据。在此之前,不妨将其视为一个提醒:即使是最成熟的架构,也仍有被重新想象的余地。
相关推荐
RTX 5090断货危机:第三方售价飙至9500美元的背后
英伟达RTX 5090从美国线上零售消失,第三方售价飙至9500美元。本文解析AI算力需求如何推高GPU价格,以及用户转向AMD的替代选择与市场启示。
苹果Siri将支持替换为Claude、ChatGPT,代码已现端倪
曝光代码显示,苹果正开发Siri AI的第三方模型集成方案,未来或可将Siri底层模型替换为Claude或ChatGPT。这一变化背后是欧盟《数字市场法》的监管压力。
EPA拟废除电厂温室气体排放标准,AI用电激增下的环境隐忧
美国EPA宣布计划废除电厂温室气体排放标准,而AI、电动汽车与制造业正推高电力需求。本文分析这一政策如何在AI用电激增背景下加剧电力碳排放隐忧。