拒绝幻觉引用:一个更诚实的科研Agent实践

开发者受够研究Agent的过度自信,做了一个分阶段、可溯源、带校准置信度的透明研究Agent。
Reddit 开发者 u/spidervirus 因不满研究型 Agent 要么编造引用、要么失败时无从定位,构建了 ResearchAgent。它把研究流程显式拆为规划、搜索/验证、综合三个阶段,使错误可被定位到具体环节;只引用实际抓取到的真实来源,并给出带理由的校准置信度评分及按严重程度排列的局限性说明。工程上支持可选的人类审批门,可完全本地运行(Ollama + DuckDuckGo),并附带渐进式示例与教程。开发者主动向社区求证两个开放问题:置信度评分是否可信、显式阶段是助力还是负担。文章认为,对需要溯源与可信度判断的研究任务,这种把不确定性摆上台面的做法值得参考。
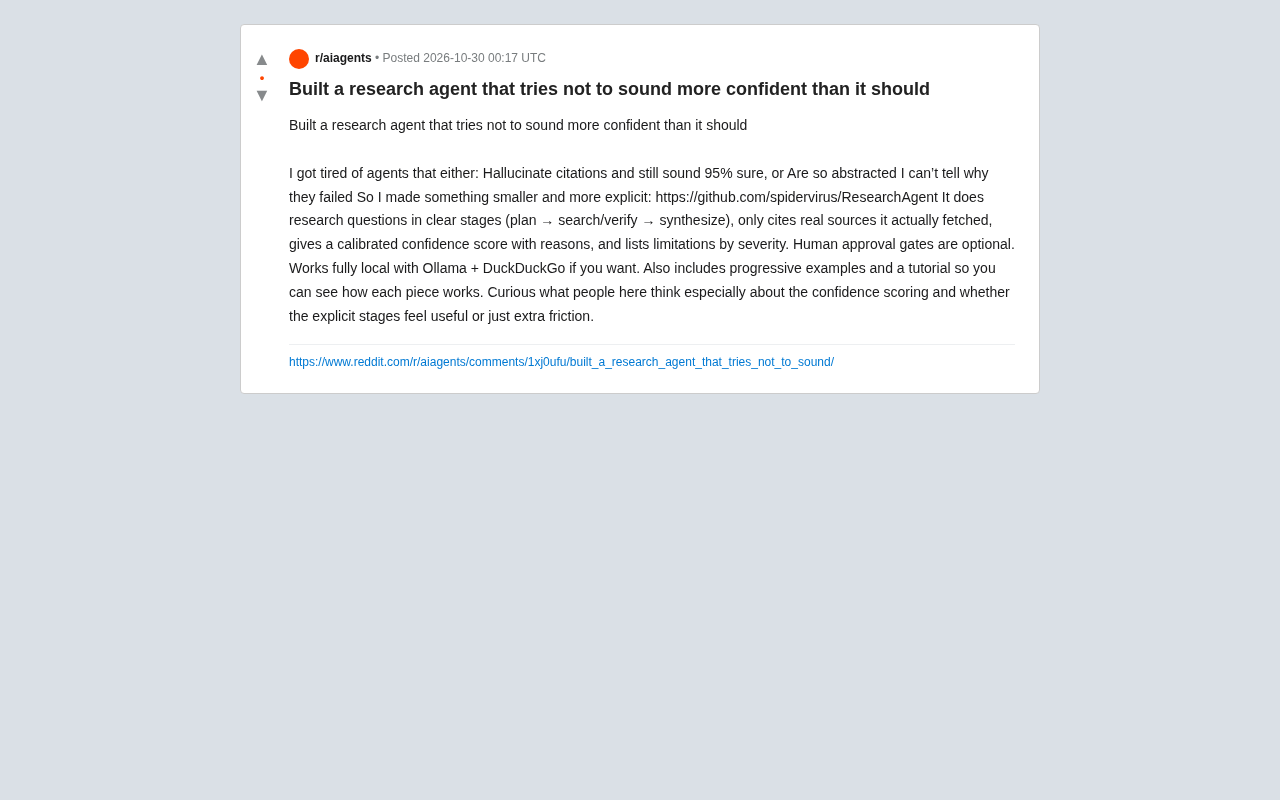
研究型Agent最让人头疼的问题,往往不是能力不足,而是过度自信。编造引用却依然言之凿凿,或者抽象到出错时你根本不知道它错在哪一步。Reddit上一位开发者(u/spidervirus)因为受够了这两种极端,动手做了一个更小、更透明的研究Agent——ResearchAgent,核心理念很简单:只说自己真正做过的事,只引用真正抓取到的来源。
从“黑箱输出”到“显式分阶段”
这个项目最直接的设计选择,是把研究流程拆成清晰可见的阶段:规划(plan)→ 搜索与验证(search/verify)→ 综合(synthesize)。每个阶段都有明确的输入输出,而不是把一切塞进一次模型调用里。开发者坦言,这样做是为了让失败变得可诊断——当结果不对时,你能定位到是规划跑偏、检索没抓到关键信息,还是综合阶段产生了偏差。
这种“显式阶段”是否值得,是他在帖子里主动抛出的疑问之一。额外的步骤确实会带来一些流程上的摩擦感,尤其当问题简单时,分阶段显得有点重。但对于需要可信度的研究任务,可解释性本身就是价值的一部分。
置信度评分:给“不确定”一个说法
Agent的另一个核心设计是带理由的校准置信度评分,并且会按严重程度列出局限性。换句话说,它不只给一个数字,还要说明为什么是这个置信度、哪些方面证据薄弱。这直接回应了开头提到的痛点:一个95%确信的幻觉引用,比一个60%确信但标注了不确定来源的回答危险得多。
据开发者描述,Agent只会引用它实际抓取到的真实来源。这一点看似基础,却是很多研究型Agent的软肋——生成看起来合理但并未真实存在的引用。至于置信度评分本身的校准质量如何,开发者也在征求社区意见,说明这仍是一个开放问题,而不是已经验证的结论。
校准(calibration) 在概率预测与机器学习中,指的是模型输出的置信度与实际正确率之间的一致性。一个“校准良好”的系统,在它声称有 80% 把握的判断中,长期应有约 80% 确实正确;若它频繁以 95% 的把握给出错误答案,就属于“过度自信”的失准状态。校准与准确率是两个不同维度:模型可以很准但校准很差(例如总是报 99% 确信),也可以准确率一般但校准良好(敢于承认不确定)。常见的评估手段包括可靠性图(reliability diagram)与期望校准误差(ECE),它们把预测按置信度分桶,再对比每桶的实际命中率。对研究型 Agent 而言,校准质量直接决定了用户能否依据置信度分数来判断是否需要人工复核,这也是原文将其列为开放问题的原因。
本地运行与人类审批门
工程实现上,这个项目保持了轻量:可选的人类审批门(human approval gates),以及完全本地的运行方式——搭配Ollama和DuckDuckGo即可跑起来,不强制依赖云端服务。对关注数据隐私或想低成本试验的开发者来说,这是个务实的起点。
项目还附带了渐进式示例和教程,目的是让使用者能看清每个部件是怎么运作的,而不是把它当成一个整体黑箱。这种“可拆解”的思路,和分阶段设计一脉相承。
Ollama 是一个开源的本地大模型运行框架,提供类似 ollama run 的命令行与本地 HTTP API,可一键下载并运行 Llama、Mistral、Qwen 等权重开放的模型,无需自建推理服务或依赖云端 API。DuckDuckGo 在这里充当检索来源,其提供无需 API Key 的搜索结果接口(如 Instant Answer API 或 HTML 端点),适合低成本、注重隐私的原型验证;相比 Google/Bing 官方搜索 API,它在结果丰富度、速率限制和稳定性上有所取舍。二者组合意味着整个“搜索—推理—综合”链路可以完全跑在本地机器上,数据不出设备,但代价是受限于本地算力与消费级模型的推理能力,长上下文处理和质量上限通常低于云端大模型。
这类Agent适合谁
如果你追求的是极致流畅的一键式体验,分阶段的显式流程可能会让你觉得啰嗦。但如果你在做需要溯源、需要判断可信度的研究任务,或者正在自己搭建Agent并想搞清楚每一步发生了什么,这种把不确定性摆到台面上的做法值得参考。开发者自己在帖末提出的两个问题——置信度评分是否可信、显式阶段是助力还是负担——也正是这类工具接下来需要社区共同验证的方向。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。