开源本地AI平台亮相Show HN:数据自主的新选择
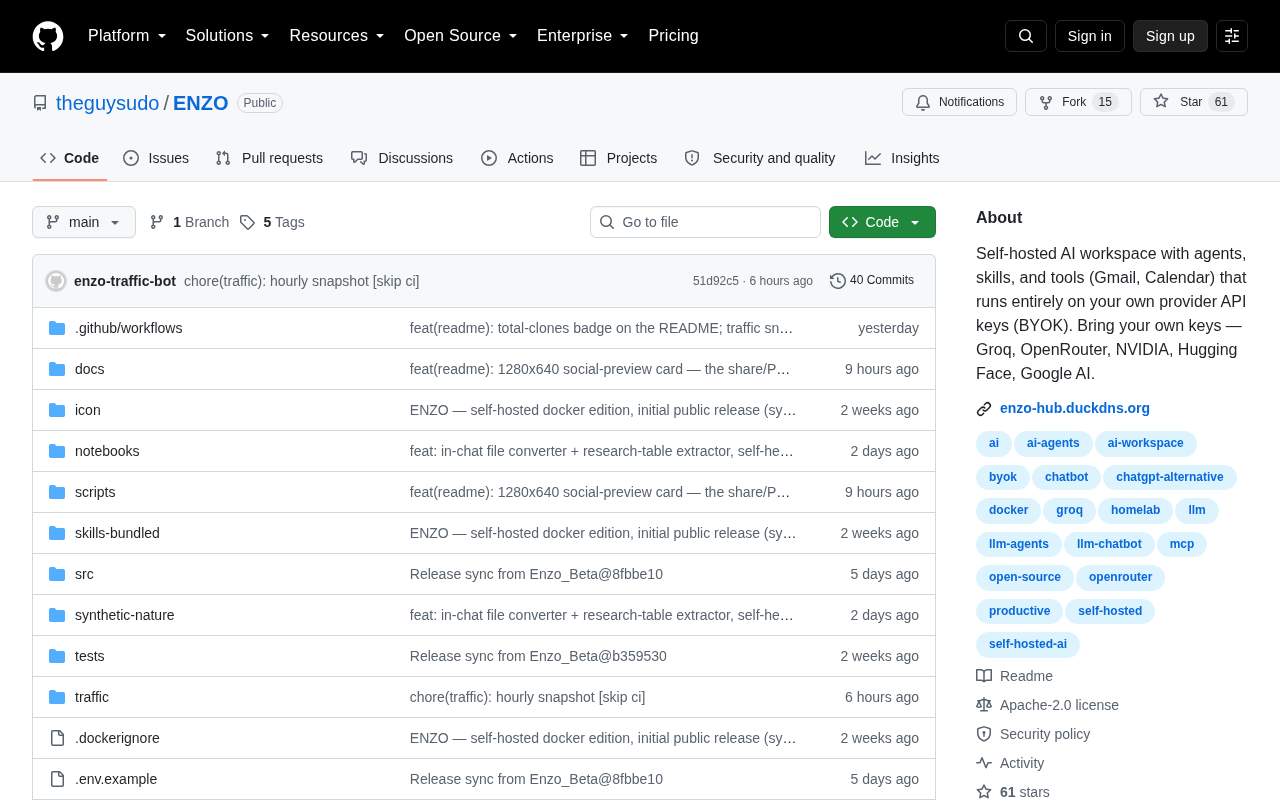
一个开源、可本地运行的完整AI平台登陆Hacker News,契合数据隐私与成本可控的本地AI趋势,但仍处早期阶段待验证。
一位开发者在Hacker News发布了一个开源、可本地运行的完整AI平台,目标是将模型推理、对话界面、知识库管理等模块整合为一体,让用户无需拼凑多个工具即可搭建AI工作流。本地部署的核心价值在于数据主权与隐私保护——敏感行业可规避云端API的合规风险——以及长期成本可控、不受服务商限流或政策变动影响。该项目契合Ollama、LM Studio等工具推动的本地AI生态成熟趋势,量化技术的进步也让消费级硬件运行大模型成为现实。然而项目目前仍处极早期阶段,Hacker News上互动寥寥,技术架构、支持模型及硬件门槛等关键信息尚不透明,需更多社区验证才能判断其可持续性。
一个面向本地部署的开源AI平台
近日,一位开发者在 Hacker News 的 Show HN 板块发布了自己的作品:一个开源、可本地运行的完整AI平台(full fledged AI platform)。虽然帖子本身信息有限(发布时仅有 3 个点赞和 1 条评论),但它折射出当前AI工具生态中一个越来越受关注的方向——把AI能力从云端搬回到用户自己的机器上。
所谓「full fledged」,意味着作者的目标并非做一个单一功能的脚本或demo,而是一个功能相对完整的平台。结合当下同类项目的普遍形态,这类平台通常会整合模型推理、对话界面、知识库管理、插件或工具调用等模块,让用户无需拼凑多个工具就能搭建起自己的AI工作流。
为什么「本地可用」是关键词
这个项目最值得关注的标签是「locally usable」(可本地使用)与「open source」(开源)。这两点组合在一起,直接回应了许多开发者和企业对云端AI服务的顾虑。
数据主权与隐私
把模型和数据留在本地,最直接的好处是隐私和数据主权。对于处理敏感信息的团队——例如法律、医疗、金融行业——将数据发送到第三方API始终存在合规风险。本地部署意味着数据不出内网,从根本上规避了这类问题。
「数据主权」在合规语境下有具体的法律含义。欧盟《通用数据保护条例》(GDPR)要求个人数据在处理和传输时须满足严格条件,向境外第三方服务商发送数据可能触发跨境传输合规要求。中国《数据安全法》和《个人信息保护法》同样对数据出境设有限制。对于医疗行业,美国HIPAA法规明确要求受保护健康信息(PHI)的处理须签署业务伙伴协议(BAA),而许多云AI服务提供商并不默认提供此类协议。本地部署从架构层面消除了数据外传的可能,使合规举证更为简洁——无需审查第三方的安全资质,数据链路完全在自有基础设施内闭环。
成本与可控性
云端大模型API按调用量计费,在高频使用场景下成本可能快速累积。本地方案虽然前期需要硬件投入,但长期运行的边际成本更低,且不受服务商限流、涨价或政策变动的影响。开源许可则进一步保证了用户可以自由修改、审计和二次开发,避免被单一厂商锁定。
开源本地AI的生态背景
这个 Show HN 项目并非孤立现象。近年来,从 Ollama、LM Studio 到各类基于开源大模型(如 Llama、Mistral、Qwen 系列)构建的前端与编排工具,本地AI生态正在快速成熟。硬件层面,消费级GPU显存的提升与量化技术的发展,让个人电脑运行数十亿参数的模型成为可能。
在这样的背景下,一个「完整平台」型的开源项目如果能把模型管理、界面交互和扩展能力打包好,就能显著降低普通用户的上手门槛。这也是它相较于零散命令行工具的潜在价值所在。
量化技术(Quantization)是让大模型得以在消费级硬件上运行的关键推手。其核心思路是将模型权重从高精度浮点数(如FP32、FP16)压缩为更低位宽的整数格式(如INT8、INT4),从而大幅缩减显存占用和计算量,代价是轻微的精度损失。以主流的GGUF格式为例,一个70亿参数的模型经过4-bit量化后,显存需求可从约14GB压缩至约4GB,普通消费级显卡乃至纯CPU环境都能运行。llama.cpp项目是这一技术普及的重要推手,Ollama和LM Studio等工具均以其为推理后端。正是量化技术的成熟,才使得"本地运行百亿参数级大模型"从实验室设定变成了普通开发者的日常选项。
谨慎看待:早期项目的现实
需要坦诚指出的是,这个项目目前处于非常早期的阶段。Hacker News 上的低互动量(3 分、1 条评论)说明它尚未获得社区的广泛验证。原始帖子也没有提供技术架构、支持的模型、性能表现或具体使用场景等关键细节。
对于有意尝试的用户,建议关注几个核心问题:它支持哪些底层模型和推理后端?部署的硬件门槛有多高?是否有活跃的维护和文档?开源许可证的具体类型是什么?这些因素将直接决定它是一个可持续的工具,还是又一个短命的周末项目。
小结
这个开源本地AI平台代表了一个正确的方向:让AI能力更私密、更可控、更少依赖大厂云服务。在数据隐私意识增强和开源模型能力提升的双重推动下,本地优先(local-first)的AI工具值得持续关注。不过就当前公开信息而言,它仍需更多社区反馈和实际测试来证明自身价值。感兴趣的开发者不妨亲自试用,并把使用体验反馈给作者,这正是Show HN文化的意义所在。
相关推荐
OpenAI Jalapeño 推理芯片首测拆解:胜负写在每瓦 Token 上
OpenAI 自研推理芯片 Jalapeño 首批测试成绩拆解:在 gpt-oss、DeepSeek R1、Kimi K2 三组跑分中,对标 NVIDIA GB200/GB300 实现约 1.5-1.9 倍每瓦吞吐与更低延迟。本文冷静剖析测试边界、Prefill/Decode 架构设计与推理芯片竞争格局。
OpenAI自研AI芯片深度解析:软件栈、架构与英伟达威胁
OpenAI自研AI芯片(Jalapeño等辣椒代号)技术细节曝光:Codex驱动内核开发、Gluon编程语言与线性布局、2048 XPU扩展网络架构,以及为何放弃PD分离。深度解析其对英伟达Blackwell的潜在威胁。
FLAWED研究的缺陷:行业研究方法论反思
针对Hacker News上关于FLAWED研究缺陷的讨论,本文探讨行业研究常见的方法论问题,包括样本偏差、利益冲突与可复现性不足,并为从业者提供批判性评估研究报告的建议。