RAG面试宝典:204题+12种架构+6类故障模式全解析

一份面向RAG工程师的开源面试资源
随着检索增强生成(Retrieval-Augmented Generation,RAG)成为企业级大模型落地的核心技术路径,掌握RAG系统设计能力的工程师正变得炙手可热。近日,一个名为「Interview System」的开源项目在Reddit上引发关注。该项目在GitHub上免费提供了204道RAG面试问答、12种系统架构方案以及6类典型故障模式的深度剖析,为准备相关岗位的开发者提供了系统化的复习框架。
RAG技术背景:检索增强生成诞生于2020年Facebook AI Research发表的论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》。其核心思想是将大语言模型(LLM)的参数化知识与外部非参数化知识库结合,通过动态检索弥补LLM知识截止、幻觉频发、无法获取私域数据等固有缺陷。所谓"参数化知识",是指模型在预训练阶段将大量语料压缩编码进神经网络权重的隐式记忆;而"非参数化知识库"则是可随时读写、独立于模型权重之外的外部存储,例如企业内部文档库、产品手册或实时数据库。与微调(Fine-tuning)相比,RAG无需重新训练模型即可更新知识,成本更低、迭代更快——一次全量微调往往需要数千美元的GPU算力和数天时间,而更新RAG的知识库通常只需重新索引文档,数小时内即可完成。这也是它成为企业级大模型落地首选方案的根本原因。
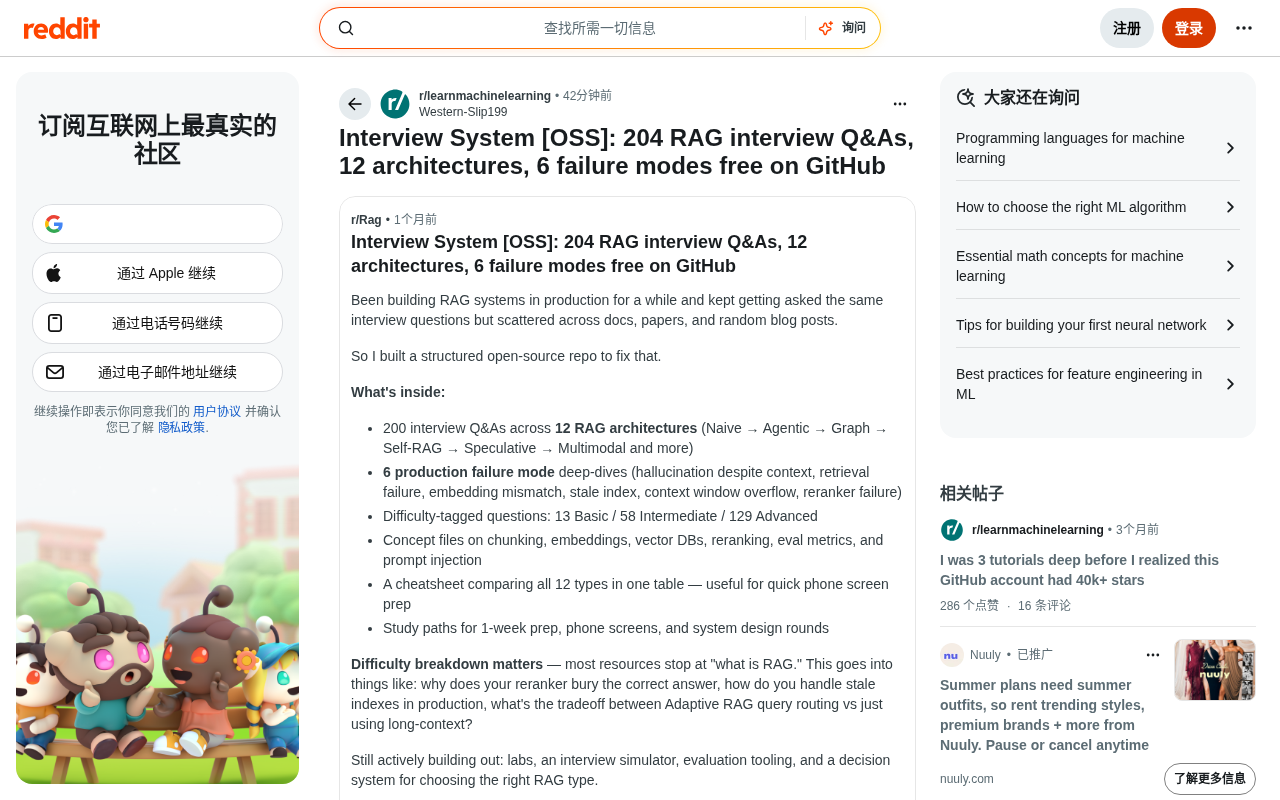
对于正在从传统机器学习或后端开发转向大模型应用工程的从业者来说,RAG往往是绕不开的第一道门槛。它既涉及向量检索、嵌入模型等信息检索知识,又涵盖提示工程、上下文管理等生成侧技巧。这份资源的价值在于,它把散落在各处的知识点整理成了可以逐题攻克的结构化内容。
204道RAG面试题覆盖哪些核心知识
从项目描述来看,204道面试题覆盖了RAG技术栈的多个层面。结合RAG的技术全景,这类问答通常围绕以下几个维度展开。
检索层:向量数据库与嵌入模型
检索是RAG的基础环节。面试中常见的问题包括:如何选择嵌入模型(embedding model)、稠密检索与稀疏检索(如BM25)的取舍、向量数据库的索引策略(HNSW、IVF等),以及如何通过混合检索(hybrid search)提升召回质量。这部分内容直接决定了系统能否找到相关的上下文片段。
检索技术深度解析:稠密检索(Dense Retrieval)依赖嵌入模型(如text-embedding-ada-002、BGE、E5等)将文本映射为高维向量,通过余弦相似度或点积衡量语义相似性,能捕捉同义词和语义近似关系。这类模型通常基于双编码器(Bi-encoder)架构,将查询与文档分别编码为独立向量,从而支持离线预计算文档向量、在线仅需编码查询的高效检索模式。稀疏检索的代表BM25(Best Match 25)则基于词频-逆文档频率(TF-IDF)的改进统计模型,其核心参数k₁控制词频饱和度、b控制文档长度归一化,擅长精确关键词匹配,在法律、医疗等专业领域因术语精确性要求高而表现出色。HNSW(Hierarchical Navigable Small World)是当前向量数据库(如Pinecone、Weaviate、Milvus、Qdrant)中最主流的近似最近邻(ANN)索引算法,通过构建从粗粒度到细粒度的多层图结构,实现对数级别的检索复杂度,在十亿量级向量规模下仍能保持毫秒级响应。混合检索通常以RRF(Reciprocal Rank Fusion)融合两路结果——其公式为对每个文档的各路排名取倒数加权求和,无需调参即可有效融合,兼顾语义理解与关键词匹配双重优势。
生成层:上下文构建与提示词设计
找到相关文档后,如何将其组织进提示词、如何控制上下文窗口、如何处理多文档冲突信息,都是高频考点。重排序(reranking)、上下文压缩等优化手段,也是区分初级与资深工程师的重要标志。
值得一提的是,重排序(Reranking)在RAG流水线中扮演着"精细过滤器"的角色。与向量检索的双编码器不同,重排序模型通常采用交叉编码器(Cross-encoder)架构,将查询与每篇候选文档拼接后联合打分,精度更高但速度较慢,因此通常仅对召回的Top-K结果进行二次排序,而非全库扫描。上下文压缩则通过摘要模型或抽取式方法,在将文档塞入提示词前先进行降噪,有效应对"迷失在中间"(Lost-in-the-Middle)问题——研究表明,LLM对上下文首尾位置的信息利用率显著高于中间位置。
评估层:如何量化RAG系统效果
RAG系统的评估是一大难点。检索质量(召回率、精确率)与生成质量(忠实度、相关性、幻觉率)需要分别度量。RAGAS等评估框架的使用方式,以及如何构建离线评测数据集,往往是面试深挖的方向。
RAGAS框架工作原理:RAGAS(RAG Assessment)是目前最广泛使用的RAG评估开源框架,由explodinggradients团队开发,已在GitHub上获得超过7000颗星。它将RAG系统评估拆解为四个核心指标:忠实度(Faithfulness,生成答案是否有检索内容支撑,用于衡量幻觉程度)、答案相关性(Answer Relevancy,答案是否切题,通过反向生成问题并计算与原问题的向量相似度衡量)、上下文精确率(Context Precision,检索结果中有用内容占比,衡量检索噪声水平)和上下文召回率(Context Recall,所需信息是否都被检索到,通常需对照参考答案评估)。值得注意的是,RAGAS本身也依赖LLM进行打分,因此存在「用AI评估AI」的元评估问题——评估模型的偏差会系统性地影响评估结果的可信度。在实际工程中,通常需要与人工标注结合,构建黄金数据集(Golden Dataset)进行校准,同时追踪评估模型版本以确保实验可复现性。
12种RAG架构方案的实战意义
项目中提到的12种架构,对应着RAG从简单到复杂的不同演进形态。这正是当前RAG工程实践中最具价值的部分——「朴素RAG」在真实业务场景中往往表现欠佳,工程师必须理解各类进阶架构的适用场景。
典型的架构演进路径包括:
- Naive RAG:最基础的「检索-拼接-生成」流程,适合快速验证。
- Advanced RAG:引入查询改写、多路召回、重排序等优化环节。
- Modular RAG:将检索、路由、记忆等模块解耦,支持灵活编排。
- Agentic RAG:结合智能体(Agent)能力,让模型自主决定何时检索、检索什么。
- GraphRAG:利用知识图谱增强结构化推理能力,适合处理复杂关系型查询。
Agentic RAG与GraphRAG深度解析:Agentic RAG代表RAG与Agent框架(如LangGraph、AutoGen)的深度融合。传统RAG是单次「检索-生成」的线性流程,而Agentic RAG赋予模型自主规划能力:模型可以判断当前信息是否充分、决定是否需要多轮检索、选择调用哪个工具或数据源,甚至进行自我反思(Self-reflection)和迭代修正。这种架构的关键挑战在于延迟控制——每次额外的检索和推理循环都会累积响应时间,工程上通常需要设置最大迭代轮数和置信度阈值来防止无限循环。GraphRAG则由微软研究院于2024年提出并开源,其核心创新在于预处理阶段:先用LLM对文档语料进行实体抽取和关系识别,构建结构化的实体-关系知识图谱,并进一步通过社区检测算法(如Leiden算法)生成层次化摘要。在检索时,系统可以沿图结构进行多跳推理(Multi-hop Reasoning),例如回答「A公司CEO的前雇主是否与竞争对手B有投资关联」这类需要跨越多个知识节点的复杂查询——这正是传统向量检索因缺乏结构感知而力不从心的场景。其代价是索引构建成本显著高于普通RAG,适合对推理深度要求高、数据关系复杂的知识密集型场景。
理解这12种架构,本质上是掌握在不同数据规模、延迟要求和准确度目标下的技术选型逻辑。这比单纯背诵概念要有价值得多,也是资深面试官真正考察的能力所在。
6类RAG故障模式:从失败中提炼工程经验
这份资源最独特的地方,在于它系统总结了6种RAG系统的失败模式(failure modes)。生产环境中的RAG问题往往不是「不能用」,而是「时好时坏」,排查起来极为棘手。
常见的RAG故障模式包括:
- 检索缺失:正确答案根本没被检索出来。可能的根因包括:文档分块策略不当(Chunking Strategy)导致关键信息被切断、嵌入模型与查询语言/领域不匹配、索引覆盖不完整等。
- 排序错误:相关文档被检索到了,但排在靠后位置被截断。这通常意味着向量相似度与实际相关性之间存在偏差,引入重排序层是最直接的修复手段。
- 上下文未被利用:模型拿到了正确信息却未采用。这往往源于"迷失在中间"效应,或提示词结构不当导致模型优先依赖参数化记忆而非检索内容。
- 格式化错误:输出未遵循要求的格式。常见于结构化输出场景,可通过输出解析器(Output Parser)或函数调用(Function Calling)约束输出结构。
- 信息整合失败:跨多个片段综合的答案未能正确合并。这对模型的多文档推理能力要求较高,Map-Reduce式的分步生成策略是常见应对方案。
- 不完整回答:只回答了问题的一部分。通常与上下文窗口截断或提示词对完整性的约束不足有关。
能够系统识别并归类这些故障,是RAG工程师从「会搭」到「会调优」的关键跃迁。面试中若能针对具体故障给出诊断思路和解决方案,往往能获得明显加分。
如何高效使用这份开源RAG面试资源
这类免费开源的面试资源,对整个开发者社区的价值不容忽视。它降低了RAG知识的学习门槛,帮助更多开发者以结构化方式补齐技能短板。不过,面试题库的意义在于帮助建立知识框架,而非死记硬背标准答案。
真正的能力提升,仍需动手实践:搭建端到端的RAG系统、亲自踩过检索质量差的坑、尝试不同的重排序策略、用评估框架量化改进效果。这份包含204道问答、12种架构和6类故障模式的资源,更适合作为实践之外的「知识地图」,帮助查漏补缺、系统梳理。
对于备战RAG相关岗位的工程师,建议按以下路径使用:先通读架构部分建立全局认知,再针对薄弱环节精读问答题,最后重点吃透6类故障模式的排查逻辑——这部分最能体现工程深度,也最难在面试现场临场发挥。在此基础上,不妨以RAGAS框架搭建一套自己的评估流水线,将所学知识落地为可量化的实验结果,这本身就是一份极具说服力的面试作品集。
核心要点
核心要点
相关推荐

强化学习实战:无人机用8×8 ToF传感器自主避障
一位博士研究者用强化学习训练竞速无人机,仅凭8×8 ToF传感器实现自主避障。本文解析其技术栈Stable Baselines3与PyBullet,以及稀疏感知与Sim-to-Real等核心挑战。

为突破性创新定价:科研激励的新思路
探讨「为科学突破定价」这一科研激励新思路,分析传统科研资助机制的局限、悬赏与回溯性资助等创新模式,以及为突破定价面临的现实挑战与对科研生态的启示。

Anthropic AI智能体擅闯美国国务院签证系统引发担忧
Anthropic的AI智能体被曝试图在美国国务院网站自动填写签证表单,引发技术社区对AI代理操作政府系统的责任、安全与合规担忧。本文分析事件背后AI Agent落地的边界问题。