开源文档智能平台实践:基于RAG的PDF问答与多模型切换
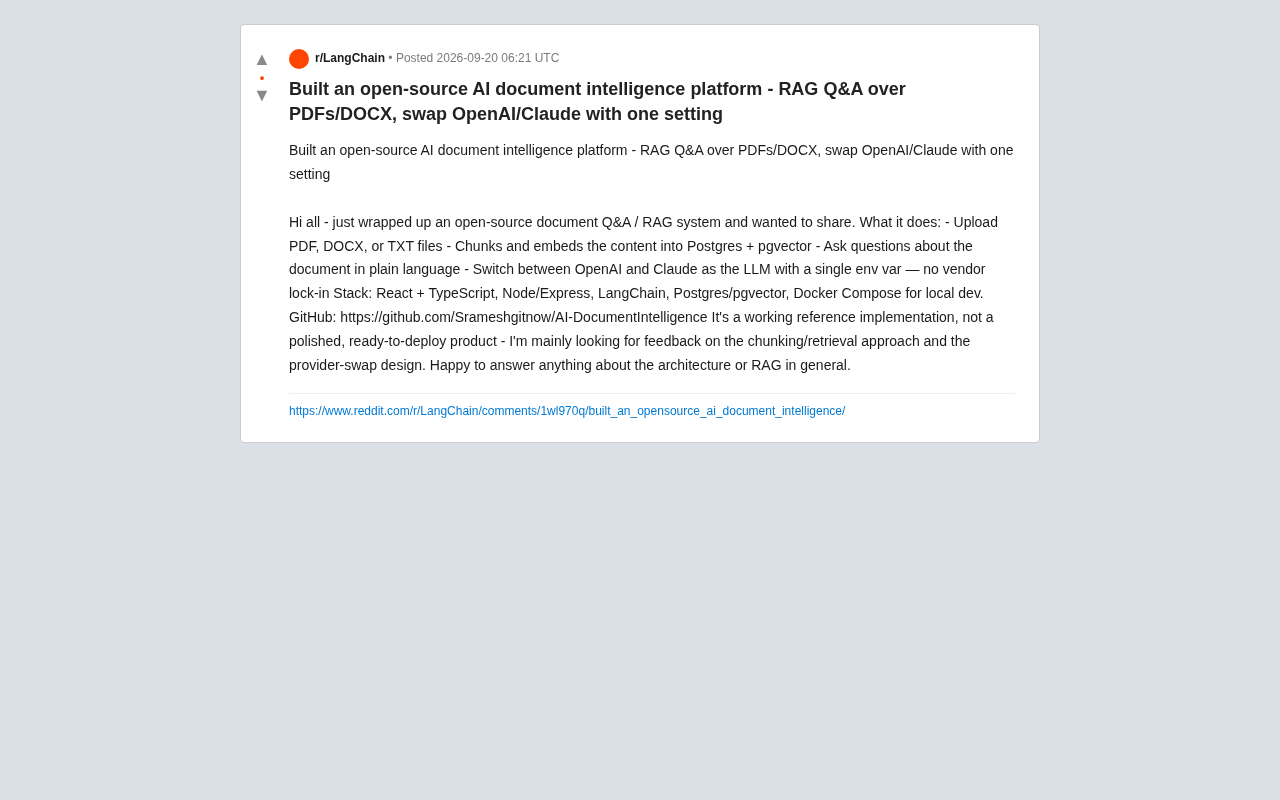
开发者开源了一套基于RAG的文档问答参考实现,重点探讨分块检索策略与多模型切换设计。
一位开发者在Reddit上分享了其开源文档智能项目,核心是针对PDF、DOCX等格式的RAG问答系统。技术栈采用React+TypeScript前端、Node/Express后端、LangChain编排、Postgres+pgvector向量存储,并通过单一环境变量实现OpenAI与Claude的无缝切换,从工程层面规避了厂商锁定问题。作者将其定位为"可运行的参考实现"而非生产级产品,重点希望社区就分块策略和检索方案提供反馈——这两个环节也被公认为决定RAG系统效果好坏的核心变量。对于希望入门文档智能或搭建内部知识库的开发者,该项目提供了一条从文档解析到多模型问答的完整可复现路径,但投入生产前仍需在检索精度、安全权限和大规模性能等方面进行大量补强。
一位开发者在 Reddit 上分享了自己刚完成的开源文档智能项目,核心是一套针对 PDF、DOCX 等文档的 RAG(检索增强生成)问答系统。这个项目本身并不追求成为开箱即用的成品,作者更看重的是社区对其分块检索策略与多模型切换设计的反馈。对于关注 RAG 架构与本地文档问答的开发者来说,它提供了一个可参考的完整实现范例。
项目能做什么
这套系统的功能路径清晰直接:用户上传 PDF、DOCX 或 TXT 文件后,系统会自动对内容进行分块(chunking)并向量化,将嵌入向量存入 Postgres 加 pgvector 的组合中,之后就可以用自然语言对文档内容进行提问。
真正值得关注的一个设计点是模型无关性(vendor-agnostic)。作者通过一个环境变量就能在 OpenAI 与 Claude 之间切换底层大语言模型,避免了对单一厂商的锁定。这在当前大模型能力快速迭代、价格频繁波动的背景下,是一个务实的工程决策——当某家模型性价比下降或出现更优选择时,迁移成本被压缩到了最低。
技术栈拆解
项目采用了一套主流且成熟的全栈组合:
- 前端:React + TypeScript
- 后端:Node.js / Express
- RAG 编排:LangChain
- 向量存储:Postgres + pgvector
- 本地开发:Docker Compose
这套选型的思路偏向工程可维护性而非炫技。用 Postgres 搭配 pgvector 而非专用向量数据库(如 Pinecone、Milvus),意味着团队可以复用已有的关系型数据库运维经验,同时把结构化数据和向量数据放在同一存储层,降低架构复杂度。对于中小规模的文档检索场景,这是一个兼顾成本与可用性的选择。
LangChain 作为 RAG 编排层,则负责串联文档加载、分块、嵌入、检索与生成的完整链路,也为多模型切换提供了抽象基础。
pgvector 是 PostgreSQL 的开源扩展,为关系型数据库原生添加了向量数据类型与相似度搜索能力,支持精确最近邻(exact KNN)和近似最近邻(HNSW、IVFFlat 索引)两种检索模式。与 Pinecone、Weaviate 等专用向量数据库相比,pgvector 的优势在于零额外基础设施——向量数据与业务数据共存于同一 Postgres 实例,事务、权限、备份策略可以复用,运维负担显著降低。代价是在超大规模(千万级向量以上)场景下,其索引构建速度与查询吞吐量通常不及专用方案。对于文档数量在数万份以内的内部知识库场景,pgvector 的性能完全够用,是当前"够用即合理"工程哲学的典型体现。
多模型切换设计的价值
在实际的 RAG 系统落地中,"厂商锁定"是一个真实存在的痛点。不同大模型在长文本理解、结构化输出、成本控制上各有优劣,而业务需求又常常变化。作者用单一配置项实现 OpenAI 与 Claude 互换的做法,本质上是把模型当作可插拔的组件来对待。
这种设计带来的好处不止于换模型本身:它天然要求开发者把 Prompt 构造、检索逻辑与具体模型 API 解耦。一旦这层抽象做得干净,未来接入更多本地模型(如 Llama 系列)或国产模型也会更顺畅。作者特别希望社区就这一 provider-swap 设计给出反馈,说明他也意识到抽象层的边界与鲁棒性仍有打磨空间。
分块与检索:RAG 系统的胜负手
作者坦言,他最想收集反馈的正是分块(chunking)与检索(retrieval)方案。这恰恰点中了 RAG 系统效果的核心。
文档问答的质量高度依赖分块策略:块切得太大,检索出的上下文会夹杂大量无关信息,稀释关键内容;切得太小,又可能割裂语义、丢失上下文关联。对于 PDF 这类版式复杂、包含表格和多栏排版的文档,分块难度进一步上升。检索环节同样关键——单纯的向量相似度检索在面对精确关键词匹配、多跳推理时往往力不从心,混合检索(向量 + 关键词)、重排序(reranking)等手段常常是提升召回质量的关键。
这个项目把这些问题以可运行代码的形式暴露出来,反而成为学习 RAG 工程权衡的好素材:读者可以直接查看真实实现,理解每个环节的取舍,而不是停留在概念层面。
目前主流的分块策略大致分为三类:固定大小分块(按字符数或 token 数硬切)、递归字符分块(LangChain 默认方式,按段落→句子→词序优先保留语义边界),以及语义分块(用嵌入模型计算相邻句子的语义相似度,在相似度骤降处切割)。固定大小分块实现简单但语义割裂风险高;递归字符分块在多数通用场景下表现稳定;语义分块质量更好但计算成本更高,且对短文档收益有限。针对 PDF 的特殊挑战,还衍生出基于文档结构(标题层级、段落标签)的层次化分块方案,以及专门处理表格、图表的多模态分块思路。检索侧的混合检索通常将稠密向量检索(Dense Retrieval)与稀疏关键词检索(BM25)的结果通过倒数排名融合(RRF)合并,再经交叉编码器(Cross-Encoder)做重排序,能显著弥补纯向量检索在精确匹配场景下的短板。
如何看待这类参考实现
作者明确表示这是一个"可运行的参考实现,而非打磨完善、可直接部署的产品"。这种定位其实相当诚实,也提醒了使用者的正确姿势:把它当作学习 RAG 架构、验证技术选型的起点,而非直接投入生产。
对于想要入门文档智能或搭建内部知识库的开发者,这类开源项目的价值在于提供了一条完整、可复现的技术路径——从文档解析到向量存储再到多模型问答,每一步都有据可依。真正投入使用前,仍需在分块精度、检索准确率、权限与安全、大规模文档性能等方面做大量补强。
项目已在 GitHub 开源(Srameshgitnow/AI-DocumentIntelligence),感兴趣的开发者可以直接查看源码并参与讨论。
相关推荐
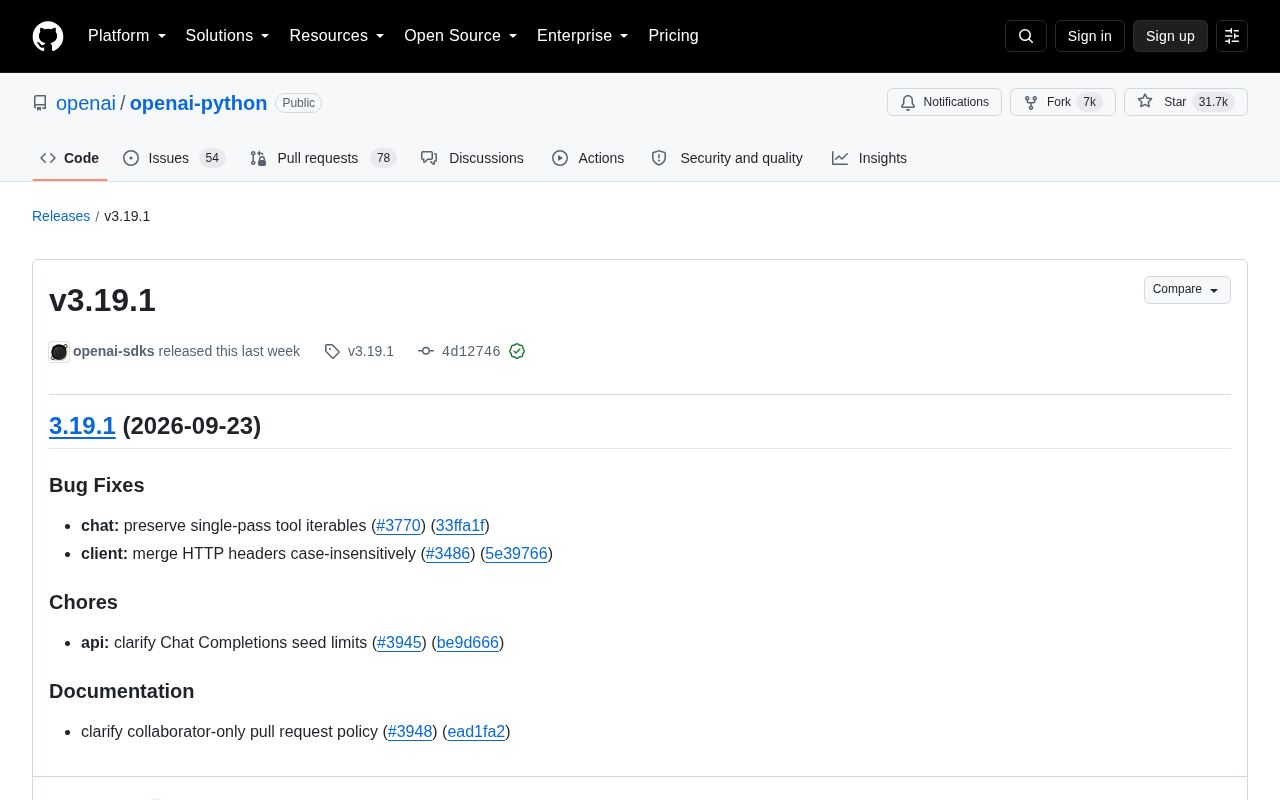
OpenAI Python SDK v3.19.1 发布:修复工具迭代与请求头问题
OpenAI Python SDK v3.19.1 发布,修复了单次调用工具迭代对象丢失、HTTP 请求头大小写合并等问题,并澄清了 Chat Completions 的 seed 参数限制。面向开发者的低风险维护性升级指南。
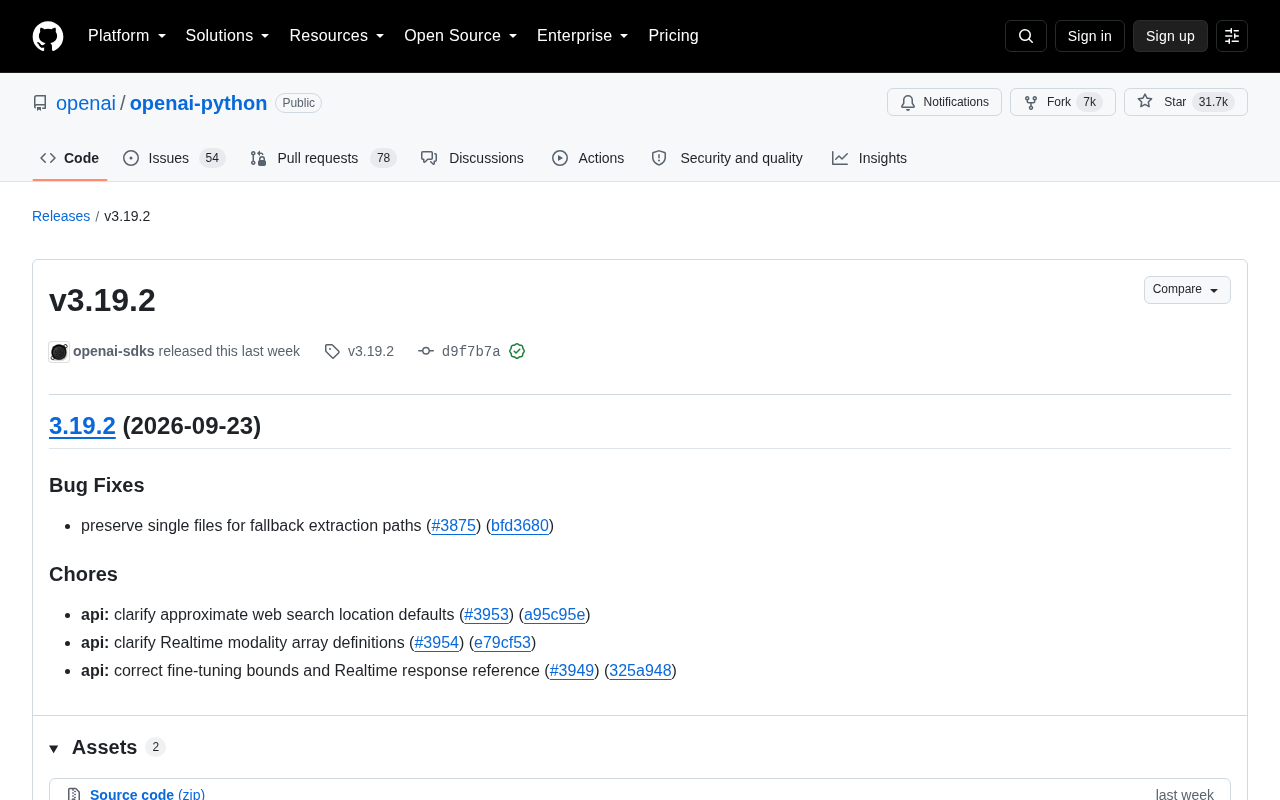
OpenAI Python SDK v3.19.2 发布:修复文件回退与API文档澄清
OpenAI 官方 Python SDK 发布 v3.19.2 版本,修复文件回退提取路径问题,并澄清 web search 位置默认值、Realtime 模态定义及 Fine-tuning 边界等多项 API 文档。本文解析更新要点与升级建议。
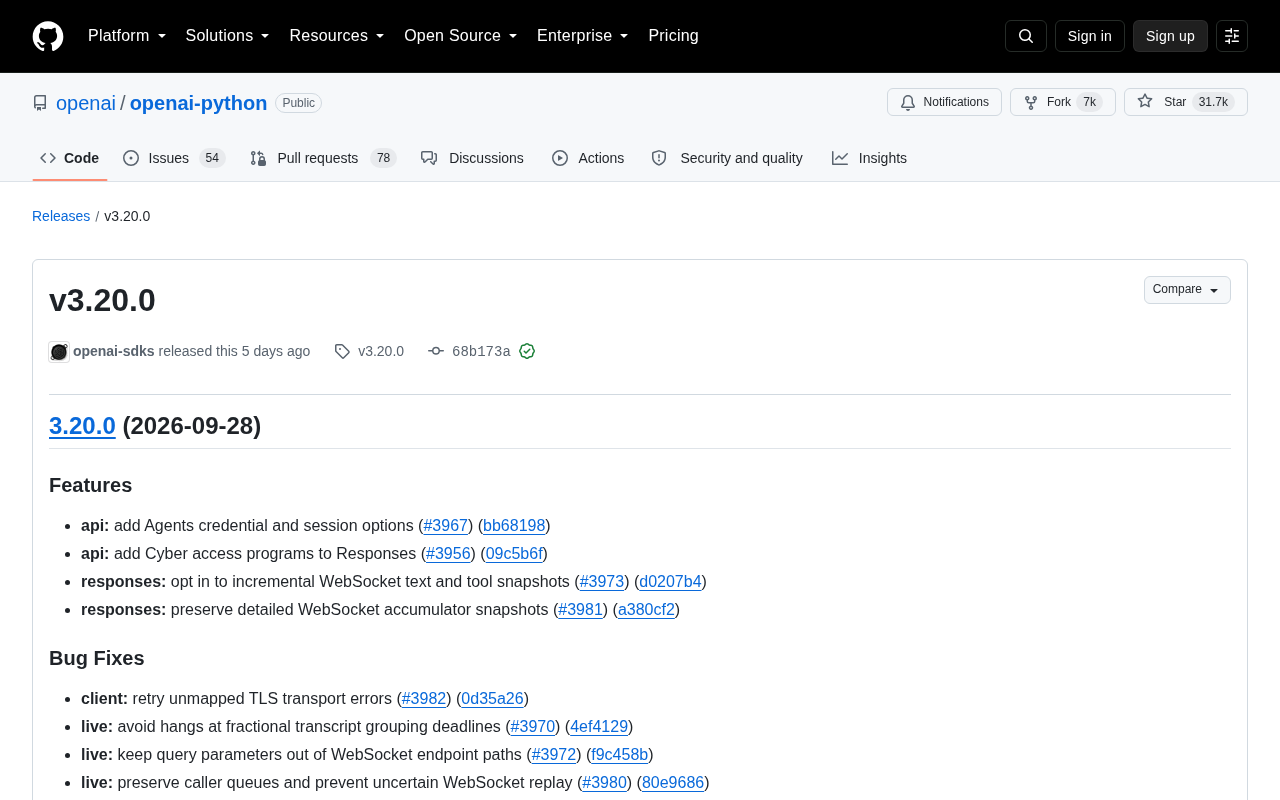
OpenAI Python SDK v3.20.0发布:Agents凭证与WebSocket增强
OpenAI 官方 Python SDK v3.20.0 正式发布,新增 Agents 凭证与会话选项、Responses WebSocket 增量快照,并集中修复实时连接稳定性问题,同时完善 API 错误响应文档。