Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro 跑分出炉,编程终端逼近 Opus,幻觉率降至 8.3%
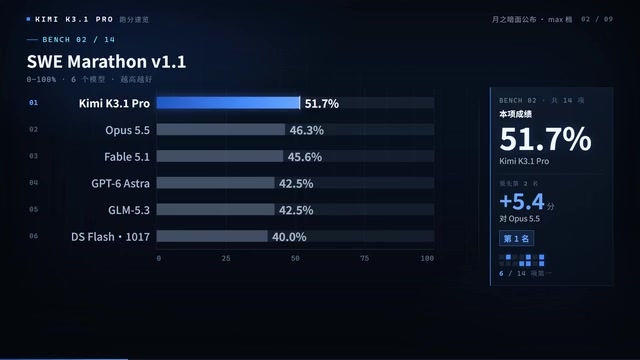
月之暗面深夜公布 Kimi K3.1 Pro 完整跑分,模型已可直接使用。14 项测试中 6 项第一:场任务编程 51.7 分超过 Claude Opus 的 46.3 分,终端实战 65.7 分仅差 Opus 0.7 分;带工具的人类终极考试 70 分、办公问答 64.4 分均为表内第一,三维建模 92.7 分进入第一梯队。但科学终端题仅 38.1 分,远落后 Astra 的 68.1 分,能力分布并不均衡。更受关注的是内部高难题幻觉率从 K3 的 23.4% 降至 8.3%。官方同时公布高速版,速度快 2-3 倍、支持百万上下文,完整权重计划 11 月 4 日前放出。
月之暗面在深夜放出了 Kimi K3.1 Pro 的完整跑分成绩,并且模型已经可直接使用,不是预热。14 项测试中 6 项排第一,编程和终端任务表现尤其抢眼,与 Claude Opus 的差距被压缩到个位数甚至不到 1 分。
编程与终端:追到 Opus 眼前
最受关注的场任务编程得分 51.7,超过 Opus 的 46.3,领先 5.4 分。终端实战得分 65.7,距离 Opus 仅差 0.7 分,同时反超 Astra。对于一个以长文本起家的模型来说,这个进步幅度说明月之暗面在代码生成和终端交互上做了针对性优化。
从实际使用角度看,编程和终端是智能体落地最核心的两类能力。K3.1 Pro 在这两项上逼近第一梯队,意味着它在自动化脚本、代码补全、命令行任务等场景中的可用性明显提升。不过 0.7 分的差距也提醒我们,头部模型之间的竞争已经进入小数点级别的拉锯。
知识与办公:带工具考试拿第一
知识与办公场景同样有亮点。带工具的人类终极考试拿到 70 分,办公问答 64.4 分,两项均为表内第一。这说明 K3.1 Pro 在调用外部工具完成复杂问答时的综合能力已经具备竞争力,而不只是单点刷分。
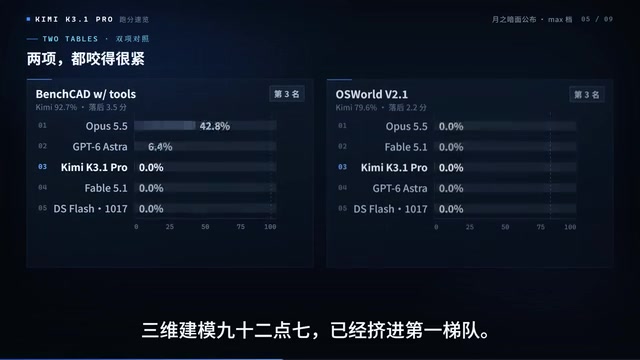
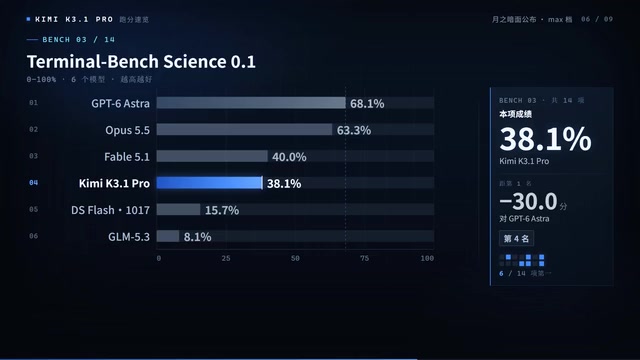
三维建模得分 92.7,挤进第一梯队;电脑操作 79.6,与头部咬得很紧。但月之暗面并没有包圆所有榜单——科学终端题得分 38.1,而 Astra 为 68.1,差距依然明显。这也说明 K3.1 Pro 的能力分布并不均衡,在需要深度科学推理的终端任务上还有明显短板。
文中提到的"人类终极考试"指的是一类高难度知识问答基准(如 Humanity's Last Exam 一类),由领域专家出题、覆盖数学、自然科学、人文等学科,题目设计上刻意避免搜索引擎可直接命中的答案,因此成为检验模型真实知识深度与推理能力的"天花板"测试。"带工具"意味着模型在答题时可以调用检索、代码执行、计算器等外部能力,而非纯靠参数记忆作答。这类设置更贴近真实智能体工作流,但也让分数受工具编排策略影响,比较时需要与其他模型的同等配置对齐来看。
幻觉率大幅下降:从23.4%到8.3%
比跑分更值得关注的是幻觉率的改善。内部高难题测试中,K3.1 Pro 的幻觉率从 K3 的 23.4% 降到 8.3%,降幅超过 15 个百分点。模型一本正经瞎编的情况明显减少,这对实际业务场景的价值可能高于任何单项跑分。
幻觉率是模型可信度的基础指标。在编程、办公、知识问答这些需要准确输出的场景里,更低的幻觉率意味着更少的人工复核成本。月之暗面把这一项单独拿出来讲,也说明团队清楚企业用户真正在意什么。
幻觉率通常指模型在输出中生成了看似合理但与事实不符、或缺乏依据的内容的比例。常见评测方式有两种:一是让模型在明知信息不足时仍作答应被判定为幻觉,考察其"拒答/承认不知道"的能力;二是由裁判模型或人工对输出做事实核查。文中"内部高难题测试"属于自建评测集,因此这一数字不宜与其他厂商公布的幻觉率直接横向对比,但同一套题目下 K3 到 K3.1 Pro 的纵向对比仍有参考价值。降低幻觉往往伴随拒答率上升或回答保守化,实际落地时还需在准确率与覆盖率之间做权衡。
高速版与开源计划
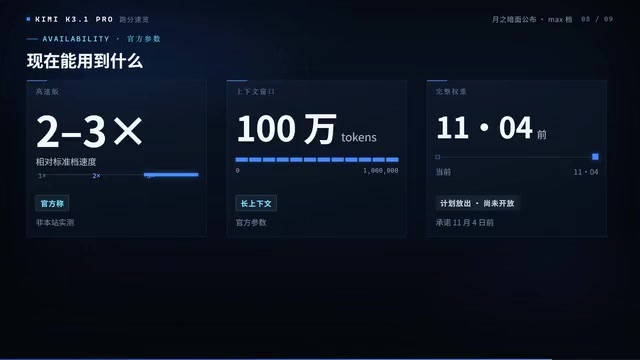
除了标准版,官方还公布了高速版,称速度快 2-3 倍,支持百万上下文,并计划放出完整权重。按照官方说法,权重将在 11 月 4 日前发布。百万上下文延续了 Kimi 系列的长文本传统,高速版则瞄准对延迟敏感的生产环境。
完整权重的开放计划值得留意。如果按计划落地,开发者可以在本地部署和微调,这对生态建设的作用比单纯刷榜更大。不过权重放出的具体许可条款和硬件门槛,目前还没有更多细节。
百万上下文(1M tokens)指模型单次可处理的输入长度上限,约相当于数十万汉字或数百页文档,长上下文能力的关键不只是"能塞进去",更在于长文本中段信息的召回准确率,业内常用"大海捞针"类测试衡量。高速版通常通过蒸馏小模型、投机解码、MoE 稀疏激活或专用推理加速等手段换取 2-3 倍吞吐与更低延迟,代价往往是复杂推理任务上的分数小幅下降。至于"放出完整权重",业界所谓开源多指权重可下载,是否允许商用、是否附带训练数据与许可限制,需以最终发布的许可证为准。
能力不均衡,但方向明确
综合来看,K3.1 Pro 是一份有取舍的成绩单:编程和终端追到 Opus 眼前,知识与办公拿下第一,三维建模进入第一梯队,但科学终端题与 Astra 差距明显。它不是全面碾压,而是在关键场景上集中突破。
对开发者来说,最实际的问题是拿它写代码还是做三维。从跑分看,编程和终端任务已经具备替代部分头部模型的实力,而三维建模虽然分数不低,生态和工具链的成熟度还需要时间验证。模型已经可用,答案最终要由实际项目来给。
相关推荐
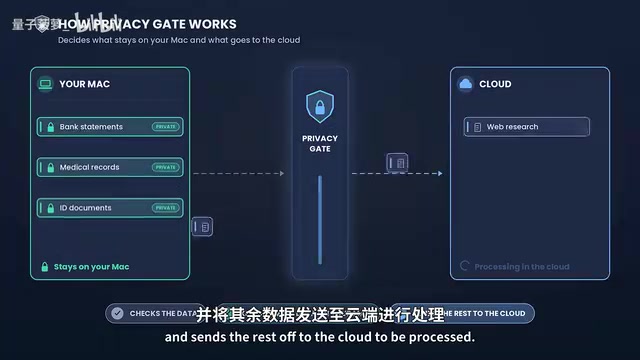
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
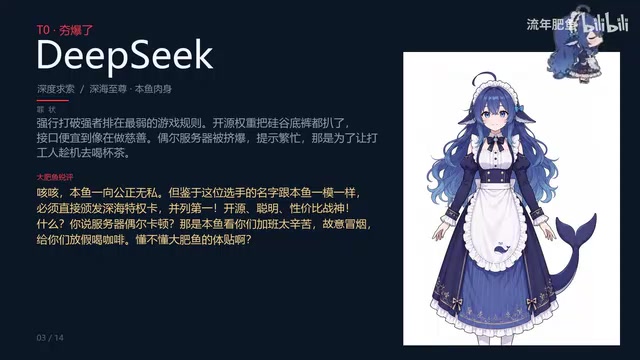
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。