跨模态ML技术通用模式:寻找文本、图像、音频的统一分类法

跨模态ML技术存在大量重复模式,可按底层范式而非模态构建统一分类法。
文章从Reddit讨论出发,指出同一底层技术在文本、图像、音频中被赋予不同名称(如tokenisation与patch embedding、MLM与MAE、下一词与下一帧预测),本质相通。这种重复源于数据特性的相似性——各模态均可视为序列或网格数据。由于学术界尚无统一的跨模态分类法,文章提出从数据表示与预处理、学习目标、架构范式、任务类型四个维度构建多维分类体系,并建议研究者使用模式标签而非模态标签组织文献,以促进跨领域知识迁移与创新。
引言:当技术名称模糊了本质
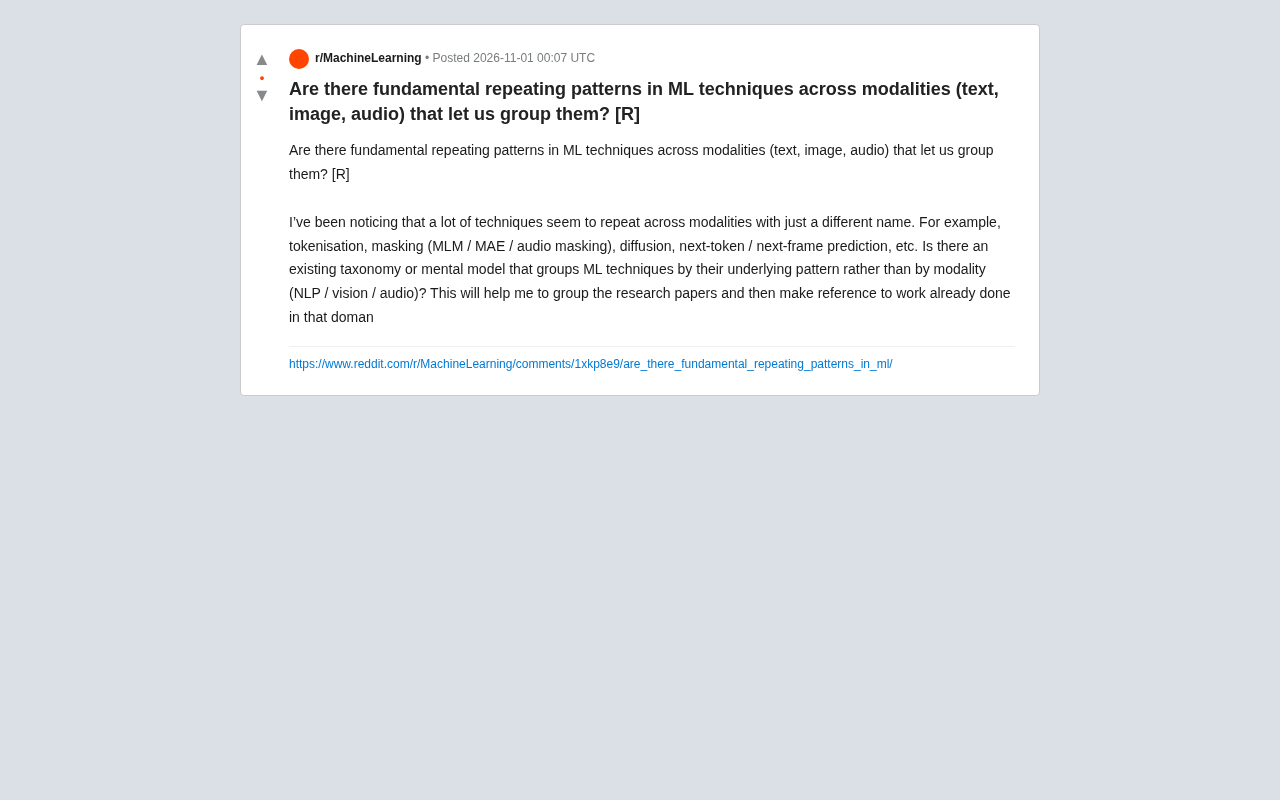
在机器学习研究中,一个有趣的现象反复出现:同一种底层技术在不同模态(如文本、图像、音频)中往往被赋予不同的名称。例如,文本中的“tokenisation”对应图像中的“patch embedding”,音频中的“frame-level feature extraction”;文本的“掩码语言建模(MLM)”与图像的“掩码自编码器(MAE)”共享同一思想;扩散模型最初在图像生成中兴起,如今也用于音频合成。这些重复模式引发了一个核心问题:是否存在一种跨模态的分类法,能按底层模式而非模态来组织ML技术?
近日,Reddit上的一篇讨论帖提出了这个疑问。发帖者观察到,许多技术只是名称不同,本质相通。他希望找到一种基于模式的分类体系,以便更高效地归类研究论文并参考已有工作。本文将从这一观察出发,结合社区讨论与现有研究,探讨跨模态模式分类的可能性。
常见的跨模态重复模式
1. 离散化与编码:Tokenisation的普遍性
在NLP中,文本被切分为token;在视觉中,图像被划分为patch(如ViT);在音频中,波形被分帧或转换为频谱图。尽管形式不同,它们都服务于同一目的:将连续或高维数据转化为离散或低维表示。这种模式可称为“离散化编码”。
ViT(Vision Transformer) 是这一模式的典型代表。它将图像切分为固定大小的非重叠patch(如16×16像素),每个patch经线性投影后作为序列中的"token"输入Transformer。这一设计使图像数据在形式上与文本序列同构,从而可以直接复用为NLP设计的Transformer架构,无需卷积归纳偏置。ViT的成功表明,模态间的差异可以通过统一的离散化-嵌入管线被消解,这也是"patch embedding"常被视为视觉领域tokenisation等价物的原因。
2. 掩码与重建:自监督学习的核心
掩码语言建模(MLM)通过预测被掩码的token来学习表示;掩码自编码器(MAE)则重建被遮挡的图像块;音频领域同样存在掩码建模(如音频掩码自编码器)。这些技术共享“掩码-预测”范式,属于自监督学习的一种通用策略。
MAE(Masked Autoencoder) 由He等人于2021年提出,其做法是将图像划分为patch后随机遮蔽较高比例(如75%),仅将可见patch送入编码器,再由轻量解码器重建被遮蔽的像素。这与BERT的MLM在思想上同源:都是通过"遮挡部分输入-预测缺失部分"构造自监督信号。两者的关键差异在于掩码比例与重建目标——MLM预测离散token,MAE重建连续像素,但共享的核心假设是:完成重建任务迫使模型学习到数据的语义表示。音频领域的掩码建模(如Audio-MAE)进一步将这一范式迁移到频谱图上。
3. 生成与预测:从下一词到下一帧
自回归生成在文本中表现为“下一词预测”,在视频或图像序列中表现为“下一帧预测”,在音频中则为“下一采样点预测”。扩散模型则另辟蹊径,通过逐步去噪生成数据,但同样跨越了模态界限。
扩散模型(Diffusion Models) 的核心思想是定义一个前向加噪过程,将数据逐步破坏为纯噪声,再训练神经网络学习逆向去噪过程,从而从噪声中逐步恢复数据。与自回归模型按序列顺序逐项生成不同,扩散模型在连续空间中对整体数据进行迭代精炼,天然适用于图像、音频等连续信号。DDPM(Denoising Diffusion Probabilistic Models)奠定了这一框架,后续的潜在扩散模型(LDM)将扩散过程移至压缩的潜空间以降低计算成本。这一范式跨越模态的通用性,正是"按模式而非模态分类"理念的有力佐证。
现有分类框架与社区观点
学术界的尝试
目前,学术界并未形成统一的跨模态分类法。常见分类仍以模态或任务为导向(如NLP、CV、语音)。然而,一些综述开始关注跨模态通用技术,例如自监督学习、生成模型等。有研究者提出按“学习范式”分类(监督、自监督、强化学习),或按“数据结构”分类(序列、网格、图)。
自监督学习(SSL) 是指不依赖人工标注、从数据自身构造监督信号的学习范式,是跨模态通用技术中最具代表性的类别。其主流方法可归为两类:一是生成式/重建式(如MLM、MAE),通过预测被遮蔽部分学习表示;二是对比式(如SimCLR、MoCo),通过拉近正样本对、推远负样本对学习不变表示。SSL之所以成为跨模态分类的重要维度,是因为其方法论在文本、图像、音频、图数据中高度同构,研究者可以据此在模态间迁移设计思路,而不必受限于任务标签。
社区讨论的洞察
在Reddit讨论中,有用户指出,模式重复源于数据特性的相似性:文本、图像、音频均可视为序列或网格数据,因此相似的技术自然适用。也有用户提到,Transformer架构的成功正体现了这种统一性:它最初用于文本,后扩展至图像(ViT)、音频(AST)和多模态。
构建统一分类法的可能性
维度一:数据表示与预处理
- 离散化:tokenisation(文本)、patchification(图像)、frameization(音频)
- 嵌入:词嵌入、图像块嵌入、音频频谱嵌入
维度二:学习目标
- 自监督:掩码预测、对比学习、下一词/帧预测
- 生成:自回归、扩散、GAN
维度三:架构范式
- 序列模型:RNN、Transformer
- 卷积模型:CNN(图像、音频)
- 图模型:GNN(适用于关系数据)
维度四:任务类型
- 分类:情感分析、图像分类、语音识别
- 生成:文本生成、图像生成、音频合成
这种多维分类法可以帮助研究者快速定位跨模态的相似工作。例如,若研究文本掩码建模,可同时参考视觉MAE和音频掩码自编码器,促进知识迁移。
实践建议:如何利用模式分类组织研究
- 建立模式标签:为每篇论文标注其底层模式(如“掩码自监督”“扩散生成”),而不仅是模态标签。
- 跨模态检索:使用模式标签搜索,发现不同模态中的类似方法。
- 关注通用架构:Transformer、扩散模型等已证明跨模态有效性,可优先跟踪。
- 参与社区讨论:如Reddit的MachineLearning板块,常有跨模态模式的深入探讨。
结语
跨模态的重复模式确实存在,且源于数据与学习任务的本质共性。尽管目前尚无公认的统一分类法,但通过多维度(表示、目标、架构、任务)的梳理,研究者可以构建自己的心智模型,更高效地组织文献并激发跨领域创新。未来,随着多模态学习的兴起,这种按模式分类的视角将愈发重要。
本文基于Reddit讨论及公开研究整理,旨在提供跨模态技术分类的思考框架。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。