LangChain实战入门:大模型调用到Agent开发全指南

为什么需要LangChain这样的框架
在深入LangChain之前,我们先来理解大语言模型(LLM)本身的局限性。大模型基于Transformer架构,通过在海量文本数据上进行自监督预训练而获得语言能力——其核心机制是下一个Token预测:给定上下文,模型计算词汇表中每个Token出现的概率分布,并采样生成输出。
Transformer架构由Google在2017年论文《Attention Is All You Need》中提出,核心创新是自注意力机制(Self-Attention),允许模型在处理序列时同时关注所有位置的上下文,彻底取代了此前RNN/LSTM依赖顺序计算的范式。自注意力的计算通过Query、Key、Value三个矩阵的点积运算实现全局上下文建模:每个位置的输出是对全序列Value向量的加权求和,权重由该位置Query与所有位置Key的相似度决定。这一全对全的计算模式赋予了模型强大的长程依赖捕捉能力,但也带来了O(n²)的计算与显存复杂度——这正是长上下文处理的根本瓶颈所在。Flash Attention通过分块计算(Tiling)和IO感知优化,将显存访问复杂度从O(n²)降至O(n),已成为当前主流推理框架的标配优化;GQA(Grouped Query Attention)则通过让多个Query头共享同一组Key/Value头,在保持模型质量的同时大幅压缩KV Cache的显存占用,是Llama 3、Mistral等新一代模型的主流架构选择。
Token是模型处理文本的基本单位,通常介于字符和单词之间——对中文而言,一个汉字约等于1-2个Token;英文单词平均约0.75个Token。GPT系列模型的词汇表通常包含5万左右的Token,每次生成时模型对整个词汇表计算Softmax概率分布,再通过温度参数(Temperature)和Top-P采样策略共同决定输出的多样性与确定性。值得注意的是,这一自回归生成过程的计算成本随序列长度呈平方级增长(源于注意力机制的全对全计算),这也是推理速度和上下文长度(Context Length)成为当前LLM核心技术挑战的根本原因——Flash Attention、GQA(Grouped Query Attention)等优化技术均针对此问题而来。
这种概率本质决定了模型的知识被"冻结"在训练数据截止时间点。对于开发者而言,重点不在于研究算法原理,而在于如何把大模型的现成能力接入实际业务,构建落地的AI应用。
大模型有三个天然的"短板":
- 知识截止时间:模型只掌握训练截止前的互联网知识,之后发生的事件和新知识无法感知。
- 没有记忆能力:标准Transformer在推理时没有持久化状态——每次调用都是无状态的前向计算。你告诉它"我叫张三",下一轮对话它并不会记得。我们平时感受到的"记忆",其实都是外部系统在维护上下文。
- 无法获取业务数据:模型默认无法读取私有业务数据,需要通过绑定工具的方式让它调用外部知识。目前解决这一问题的主流技术路径是检索增强生成(Retrieval-Augmented Generation,RAG):将私有文档切片后,通过嵌入模型(Embedding Model)转换为高维向量,存入向量数据库(如Chroma、Pinecone、Milvus);用户提问时先检索语义相近的文档片段,再将其作为上下文注入提示词,让模型基于真实文档回答。这种方式既避免了昂贵的模型微调(Fine-tuning),又能实时更新知识库,是企业知识库、客服机器人等场景的首选方案。
向量检索的工作原理值得深入理解:嵌入模型(如OpenAI text-embedding系列、国产BGE系列)将文本映射到高维语义空间(通常为768至4096维),语义相近的文本在该空间中欧氏距离或余弦距离较近。向量数据库在存储时会预先建立近似最近邻索引(ANN Index),常见算法包括HNSW(Hierarchical Navigable Small World,基于图的层级导航结构)和IVF(Inverted File Index,倒排文件索引)。其中HNSW在构建时通过多层图结构实现从粗粒度到细粒度的层级导航——查询时从顶层稀疏图快速定位候选区域,再在底层稠密图精确搜索,兼顾了召回率与查询速度的平衡,是目前生产环境中使用最广泛的ANN算法。检索时无需对全库进行暴力枚举,而是通过图遍历或倒排列表快速定位Top-K相似向量,典型百万级文档的检索延迟可控制在毫秒级。这一机制使RAG系统在知识库规模扩大时仍能保持较低的查询延迟,是其能够落地企业生产环境的关键工程保障。
文档切片(Chunking)策略同样重要——过长的切片会引入噪声,过短则丢失上下文。常见策略包括固定窗口切片、递归字符切片(RecursiveCharacterTextSplitter)和基于语义边界的切片。其中递归字符切片按段落、句子、字符的优先级逐级切分,在保留语义完整性方面表现最为均衡,是LangChain官方推荐的默认策略;而基于语义边界的切片则借助嵌入模型检测相邻句子的语义距离突变点,能更准确地保留逻辑完整的知识单元,但计算成本更高。不同切片策略直接影响最终回答的准确率,是RAG工程调优的重要环节。
开发者常见的误解是把模型当作"全知"的黑盒,而实际上它更像一个博学但与世隔绝的图书馆员:知识丰富却无法访问图书馆外的信息。
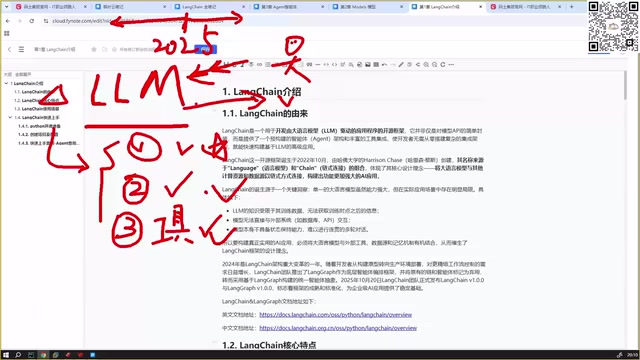
正是为了系统性地解决这些问题,AI应用开发框架应运而生。LangChain(以及配套的LangGraph)帮开发者统一管理记忆、工具调用、上下文与状态,让这些能力无需从零实现即可直接使用。
LangChain的定位与核心特点
LangChain由Harrison Chase于2022年10月创立,是最早将LLM应用开发系统化的开源框架之一。它的核心贡献在于将原本碎片化的LLM集成工作抽象为统一接口,并提供链式调用(Chain)、智能体(Agent)、记忆(Memory)等高层抽象。在竞争格局上,同类框架还有微软的Semantic Kernel(主打.NET/C#生态)、LlamaIndex(专注于RAG和数据索引)以及新兴的CrewAI、AutoGen等多智能体框架。LangChain的最大优势是社区生态和集成数量——截至2024年已集成超过70家模型提供商和数百种外部工具。
LangGraph是LangChain团队推出的有状态多智能体编排框架,通过有向图(DAG)描述智能体的执行流程,弥补了原始LangChain在复杂工作流控制上的不足。与早期Agent容易陷入无限循环的问题相比,LangGraph通过节点(Node)和显式定义的边(Edge)精确控制执行流转,开发者可以清晰设定循环终止条件,让复杂多步任务的编排更加可靠。
LangGraph的图调度机制值得详细展开:其核心数据结构是带状态的有向图(Stateful Directed Graph)。每个节点(Node)是一个可执行的Python函数,接收当前图状态(State)作为输入并返回状态更新;边(Edge)分为普通边(无条件流转)和条件边(根据状态动态决定下一节点),后者是实现分支判断和循环控制的关键。图的全局状态通过TypedDict定义,所有节点共享并修改同一份状态对象,这使得跨节点的信息传递无需显式参数传递,也便于在任意**检查点(Checkpoint)**保存和恢复执行状态——这对于需要人工介入审核的场景(Human-in-the-loop)尤为重要。Checkpoint机制底层支持多种持久化后端(如SQLite、PostgreSQL、Redis),使得长时间运行的Agent工作流可以在中断后从任意检查点恢复,这对于需要数小时乃至数天才能完成的复杂任务编排具有重要的工程价值。这种设计借鉴了函数式编程中的Reducer思想,每个节点的输出是对状态的"补丁"而非全量替换,从而支持并行节点的状态合并。相比原始LangChain的线性链式调用,图结构能够自然表达循环、并行分支等复杂控制流,是构建生产级Agent工作流的重要基础设施。
LangChain本质上是一个开发AI应用的框架,与OpenAI SDK、Claude SDK属于同一类工具。但在实际市场中,LangChain的使用率最高,生态也最为成熟。
为什么选择Python
Python在AI开发中占据主导地位(90%以上公司采用),原因主要有两点:
- 私有化部署的必需品:大模型本地部署几乎必须依赖Python生态。以vLLM为例——这是UC Berkeley开发的高性能LLM推理引擎,其核心创新PagedAttention技术借鉴操作系统虚拟内存分页思想管理KV Cache。传统LLM推理框架在处理并发请求时面临严重的显存碎片化问题——每个请求的KV Cache(键值缓存,用于存储注意力机制的中间结果)需要预先分配连续显存,导致大量显存因无法复用而浪费,GPU利用率通常低于40%。PagedAttention将KV Cache拆分为固定大小的物理块(Block),通过块表(Block Table)进行逻辑到物理地址的映射,近乎消除了显存碎片,GPU利用率可提升至90%以上。结合**连续批处理(Continuous Batching)**策略——动态将新请求插入正在执行的批次而无需等待整批完成——vLLM在相同硬件上的吞吐量较Hugging Face原生实现提升可达24倍,是目前开源社区最主流的LLM推理引擎。典型私有化部署栈为:vLLM推理引擎 + FastAPI封装OpenAI兼容接口 + Python业务逻辑层。Java生态虽有Langchain4j等社区项目,但在模型量化、GPU调度、Tensor并行等底层能力上缺乏成熟工具链。
- 生态优先:LangChain/LangGraph是最早出现的AI应用框架之一,几乎所有新模型的API首发都会优先适配其生态。此外,向量数据库客户端、嵌入模型库(如sentence-transformers、BGE系列)、数据处理工具(如LangChain的DocumentLoader体系)均以Python为一等公民,生态协同效应显著。
两大核心特点
统一的模型接口是LangChain最实用的价值所在。过去调用不同厂商的大模型需要面对各自独立、格式各异的接口,每换一个模型就要改一遍代码。有了统一框架,开发者只需替换模型名称,底层兼容工作交由框架处理。
模块化架构则把复杂应用拆分为独立模块——状态、上下文、历史消息、工具调用、提示词、中间件等各司其职。智能体(Agent)、记忆管理、RAG检索都在这套模块化体系之下,让复杂应用的构建变得清晰可控。

环境准备与模型配置
开发环境方面,课程使用PyCharm(Python 3.13)作为IDE,LangChain版本为1.3.2,LangGraph为1.2.x。安装PyCharm只需下载最新版双击安装,配置好Python环境即可。
配置API密钥
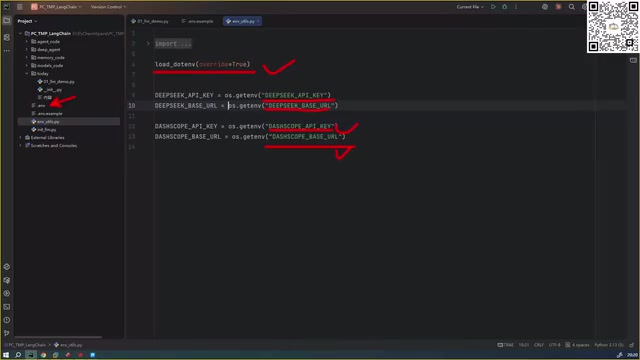
项目通过.env文件管理密钥,核心只需配置两项:
DEEPSEEK_API_KEY=你的密钥
DEEPSEEK_BASE_URL=接口地址
密钥在DeepSeek广告官网的API Keys页面创建,BaseURL在接口文档中查找。代码通过dotenv库加载.env文件,将配置读取为环境变量供后续使用。当然,DeepSeek只是示例,开发者也可以选择OpenAI、Anthropic、腾讯混元、阿里千问、智谱等厂商的模型。
大模型调用:init_chat_model
LangChain提供了通用的模型初始化方法init_chat_model,这是连接大模型最推荐的方式:
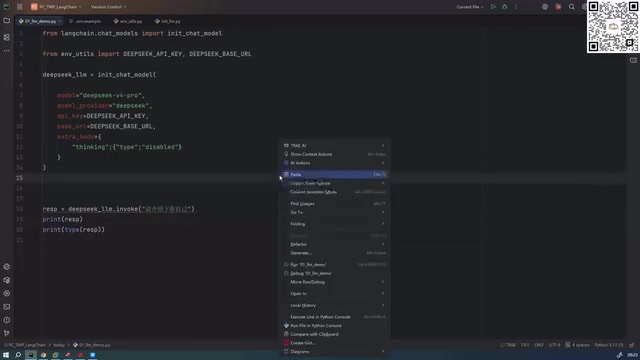
from langchain.chat_models import init_chat_model

deepseek_llm = init_chat_model(
    model="deepseek-v4-pro",
    model_provider="deepseek",
    api_key=api_key,
    base_url=base_url,
    extra_body={"thinking": {"type": "disable"}}
)
关于Thinking模式的取舍
thinking参数的设置值得特别关注。DeepSeek的"思考模式"对应的是链式思维(Chain-of-Thought,CoT)推理能力的显式激活。
CoT由Google Research在2022年提出,核心发现是:在提示词中加入"让我们一步步思考"这类引导语,能显著提升模型在数学推理、逻辑推断等复杂任务上的准确率。推理模型(如DeepSeek-R1、OpenAI o1/o3系列)将这一思想内化到训练阶段——通过强化学习让模型学会在回答前自主展开内部推理过程,这段内部思考以特殊标签(如<think>...</think>)包裹,不直接呈现给用户但会消耗Token配额。
值得关注的是,DeepSeek-R1在训练时采用了**GRPO(Group Relative Policy Optimization)**算法替代传统PPO。两者的核心区别在于奖励基线的计算方式:PPO依赖单独训练的价值网络(Critic Network)来估算每个状态的期望价值,而GRPO通过对同一问题采样多个回答并计算组内相对得分作为基线,省去了价值网络的训练开销,参数量和显存占用大幅降低。这一创新在数学竞赛、代码生成等基准测试上取得了与OpenAI o1接近的成绩,但训练成本据称仅为其约1/20,也使得开源社区能够以相对可控的计算资源复现R1的训练流程,是其在社区引发广泛关注的核心原因。
推理模型在生成最终答案前会先输出一段内部"思考过程",这一机制显著提升了数学、逻辑推断等复杂推理任务的准确率,代价是延迟大幅增加(思考Token会消耗额外的生成时间和计费Token数)。
DeepSeek新模型分为思考模式(对应旧的Reasoner,如Flash版本)和非思考模式(对应旧的Chat,如Pro版本)。这里建议关闭思考模式,原因有两点:
- 构建智能体和常规大模型应用通常不需要深度推理,开启后响应速度明显变慢;
- LangChain框架目前对思考模式的兼容性尚不完善——框架默认按标准格式解析模型输出,而思考Token会干扰消息结构的正常解析,可能引发异常问题。
对大多数场景而言,Flash版本已经足够;即便使用推理能力更强的Pro版本,也没有必要开启思考模式。
发起对话
调用大模型使用invoke方法:
response = deepseek_llm.invoke("请介绍一下自己")
print(response)
print(type(response))
返回结果为Markdown格式文本,直接打印可读性一般,但经Markdown渲染后展示效果很好——这也是后续项目页面呈现的关键所在。
理解Message消息类型
调用返回的对象类型是AIMessage,这是理解LangChain消息体系的入口。LangChain的消息类型体系脱胎于OpenAI Chat Completions API的角色设计(system/user/assistant),并加以扩展。在langchain_core.messages模块下,主要有四类消息:
-
SystemMessage:系统提示词,用于设定模型的角色和行为边界。这是提示词工程(Prompt Engineering)中设定模型"人设"和行为约束的关键手段,通常包含角色定义、输出格式要求、安全边界等指令。系统提示词的内容对模型行为影响极大,优秀的系统提示词设计可以让同一个基础模型表现出截然不同的风格和能力边界。在多轮对话中,SystemMessage始终位于消息列表的首位,其权重在模型注意力机制中通常高于普通用户消息——部分研究将此现象称为"系统提示词优先级",这也是越狱攻击(Jailbreak)往往需要绕过系统提示词约束的原因。从注意力机制的角度来看,系统提示词位于序列首部,在自注意力计算中与后续所有Token存在直接的注意力连接,这从架构层面保障了其对全局生成行为的持续影响力。
-
HumanMessage:用户输入的消息。当你传入"请介绍你自己"时,框架底层会自动将其包装成HumanMessage。
-
AIMessage:模型返回的回复消息。当模型决定调用某个工具时,AIMessage还会携带
tool_calls字段,包含工具名称和参数的结构化信息——这是大模型**工具调用(Function Calling)**能力的核心体现。OpenAI于2023年6月正式引入Function Calling,其本质是在模型的监督微调(SFT)阶段注入大量"工具调用示例",使模型学会识别何种用户意图需要调用外部工具,并能输出符合JSON Schema规范的结构化参数。2024年进一步推出Parallel Function Calling(并行工具调用),允许模型在单次响应中声明多个工具调用——模型会自动识别任务间的依赖关系,对彼此独立的子任务并行发出调用指令,将多步串行Agent的执行延迟降低50%以上。各大模型厂商(包括Anthropic Claude、Google Gemini、百度文心、阿里千问)随后相继跟进,形成了以JSON Schema描述工具参数为核心的事实行业标准。LangChain通过统一的bind_tools接口封装了各厂商的差异,底层自动将Python函数的类型注解和docstring转换为对应厂商所需的JSON Schema格式,使同一套Agent代码可以无缝切换底层模型。 -
ToolMessage:工具调用产生的消息,是构建Agent时的核心概念之一。工具执行后的结果以ToolMessage形式回传给模型,形成完整的工具调用闭环。这一循环正是ReAct(Reasoning + Acting)框架的实现基础——模型交替进行推理(Thought)和行动(Action),直到任务完成。具体而言,一次完整的工具调用包含三个阶段:①模型输出带
tool_calls的AIMessage,声明要调用的工具和参数;②框架在外部执行对应工具(如搜索API、数据库查询、代码执行器);③将执行结果封装为ToolMessage回传模型,模型综合所有上下文生成最终回复。这一机制让模型从"只会说话"变为"能够行动",是LLM与现实世界交互的关键桥梁。
这套消息类型本质上是多轮对话历史的结构化表示——Agent的"记忆"就是将这些消息列表序列化存储,并在每次调用时作为上下文注入模型。理解它们之间的关系,是从简单的大模型调用迈向Agent智能体开发的重要认知跃迁。
模型类调用方式的补充
除了通用的init_chat_model,新版LangChain还支持以模型类方式创建实例,比如ChatDeepSeek、ChatOpenAI等专用类。但建议优先使用通用方式,因为它天然兼容各厂商模型,切换成本低。只有在使用自定义模型或通用方式不支持的特殊模型时,才需要考虑专用模型类。
小结:从LLM到Agent的第一步
本文为LangChain实战奠定了基础:理解了大模型的三大局限(知识截止、无记忆、无法获取业务数据),明确了LangChain作为AI应用框架的定位与价值,掌握了统一模型接口的配置与调用方式,并熟悉了核心的Message消息类型体系。
这些看似基础的内容,实际上是构建Agent智能体和RAG项目的地基。大模型(LLM)解决的是"会说话",而Agent要解决的是"会做事"——两者的区别在于:LLM只是静态的概率预测引擎,而Agent通过工具调用、记忆管理和多步推理,让模型具备了与外部世界交互、完成复杂任务的能力。掌握了模型调用与消息体系,接下来便可进入工具调用、记忆管理与智能体编排的进阶开发阶段。
核心要点
核心要点
相关推荐

扎克伯格新片口碑两极,微软Surface全押AI开发
扎克伯格新片《The Social Reckoning》口碑两极,烂番茄68分难复刻《社交网络》。微软发布全押AI开发的Surface Laptop Ultra,起售价2600美元;苹果或携手LG进军智能家居。

Nano Banana 2.1 使用教程:在 Google AI Studio 中快速找到并体验
想在 Google AI Studio 里体验超写实图像模型 Nano Banana 2.1,却找不到入口?本教程详解查找路径:进入 Playground,打开右侧模型选择器,点击 Images 标签即可选中这个付费模型,并附人像生成实测效果分析。

Claude Haiku 5.5发布:最便宜最快的小模型来了
Anthropic发布Claude Haiku 5.5,号称最便宜最快最强的小模型。价格比上一代降约75%,输入每百万token仅10美分,计算机使用能力从16%提升至72%,并首次引入effort成本调节设置。