LangChain4j实战:企业级RAG资料库项目三种编写方式解析
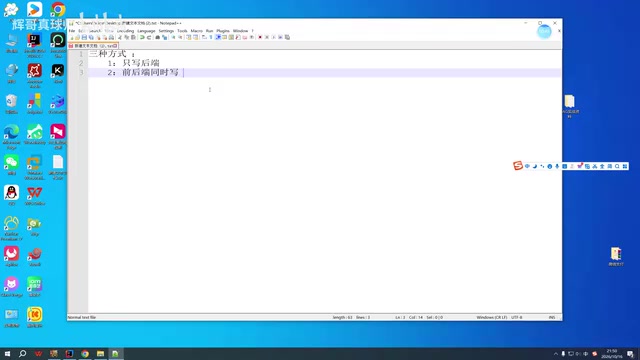
B站辉哥启动LangChain4j企业级RAG实战项目,采用主后端辅前端方式降低学习门槛。
本文介绍了B站UP主辉哥发起的基于LangChain4j的企业级RAG资料库实战项目。文章分析了三种项目实现方式的利弊,最终选定“主写后端+辅助前端”的折中方案,以聚焦RAG核心逻辑并降低前端门槛。同时列出了学习该项目所需的前置知识,包括Spring/SSM工程能力、数据库经验、Redis基础以及熟练的LangChain4j掌握。文章指出该项目适合有Java后端基础、希望系统学习RAG落地的开发者,但当前视频刚开篇,实际代码细节尚待后续更新。
为什么选择LangChain4j做RAG实战?
B站UP主辉哥在最新系列视频中,启动了一个基于LangChain4j的企业级RAG资料库实战项目。他开篇就点明了一个现实:编程无技术,全靠三方库。对于后端开发者而言,LangChain4j提供了一套完整的Java生态RAG解决方案,但真正落地到企业项目时,如何组织代码结构、如何平衡前后端工作量,才是更棘手的问题。
这个实战项目并非简单的API调用演示,而是从零构建一个可运行、可扩展的资料库系统。辉哥在视频中明确表示,项目会持续更新,并且会覆盖从工程搭建到业务闭环的全流程。
LangChain4j 是 LangChain 的 Java 实现版本,专为 Java 生态系统设计,用于构建基于大语言模型的应用。它提供了对主流大模型(如 OpenAI、通义千问广告、Ollama 等)的统一 API 封装,并内置了 RAG 流程所需的组件:文档加载器、文本分割器、向量化模型接口、向量数据库集成、检索器以及提示词模板等。与 Python 版的 LangChain 相比,LangChain4j 更贴合企业级 Java 项目的依赖管理和分层架构,让后端开发者能在熟悉的 Spring 生态中直接集成 AI 能力,减少跨语言带来的额外成本。
三种项目编写方式的权衡
辉哥规划了三种实现方式,并做了明确的取舍分析。
方式一:纯后端开发
这是最贴近后端程序员日常工作场景的方式——只写后端接口,不碰前端页面。对于专注服务端逻辑的开发者来说,这种方式能最大程度聚焦在LangChain4j的集成、RAG流程的实现以及数据库交互上。但缺点也很明显:缺少可视化的交互验证,调试和演示不够直观。
方式二:前后端全写
这种方式最完整,但辉哥直言“比较耗时”。很多后端程序员对前端技术栈并不熟悉,强行全栈开发容易带来不必要的困扰,甚至拖慢核心RAG功能的学习进度。
方式三:主写后端,辅助前端
这是最终选定的方案。后端从打开IDEA开始,涵盖建库建表、基础工程搭建、代码编写、业务闭环到运行测试的完整链条;前端则直接提供一个现成页面,学习者只需关注交互逻辑,不需要从零写页面展示。
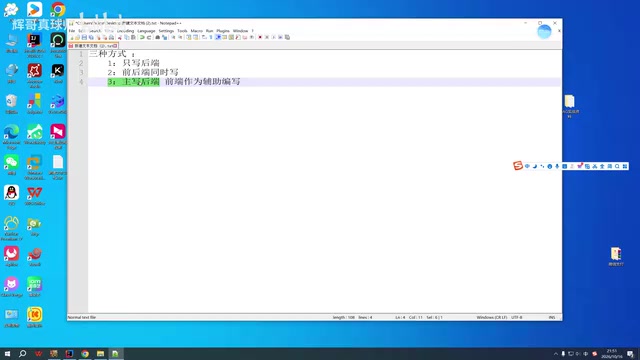
这种折中方案既保证了后端核心能力的完整训练,又降低了前端门槛,让学习者能把精力集中在LangChain4j和RAG的核心机制上。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合检索与生成的技术范式。它的核心流程是:先将企业资料库中的文档切分并向量化后存入向量数据库;当用户提问时,系统先从向量库中检索出与问题最相关的文档片段,再将这些片段作为上下文注入到提示词中,最后交由大语言模型生成答案。这种方式能显著缓解大模型幻觉问题,并让模型回答基于私有资料,是企业知识库场景的主流落地方案。
学习这个项目需要哪些前置知识?
辉哥列出了几个必备的基础能力,这些不是“了解即可”,而是需要达到熟练运用的程度。
1. Spring/SSM工程能力
需要具备基本的项目结构认知,包括依赖管理、分层架构、配置方式等。这是后续搭建LangChain4j集成环境的基础。
2. 数据库使用经验
项目以MySQL为例,但辉哥强调“你会哪个数据库就用哪个”——国产的达梦、MySQL、PostgreSQL都可以。重点在于理解数据表设计、SQL操作以及后续向量存储的对接逻辑。
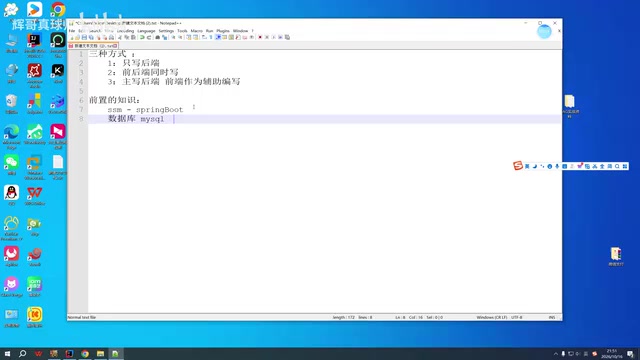
3. Redis相关知识
RAG项目中缓存、会话管理或中间结果存储可能涉及Redis,需要了解基本的数据结构和使用场景。
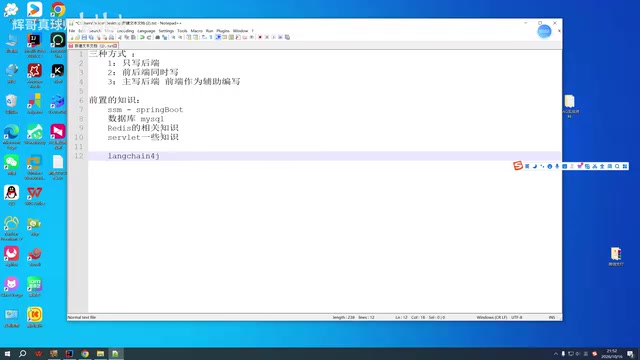
4. 熟练的LangChain4j掌握
这是最核心的前置要求。辉哥特别指出,不是“了解”就行,需要很熟练地练习。他建议先观看他已有的LangChain4j基础课程,该课程基本覆盖了官方文档上的知识点,学完后再进入实战项目会顺畅很多。
向量存储是 RAG 流程中的关键基础设施,常见选择包括 Pinecone、Milvus、Qdrant、Weaviate 等专用向量数据库,以及 Redis、PostgreSQL(配合 pgvector 扩展)、Elasticsearch 等支持向量检索的传统数据库。LangChain4j 为这些存储提供了统一的 EmbeddingStore 接口,开发者可以按需切换。对于初学者,从 Redis 或 PostgreSQL 入手成本较低;企业级场景则更倾向于 Milvus 等专用向量库以获得更好的检索性能与扩展性。
这个实战项目的价值与局限
从已发布的内容来看,这个系列更适合有Java后端基础、希望系统学习RAG落地的开发者。它的优势在于:
- 提供完整的工程视角,而不只是片段代码
- 明确区分核心与辅助,降低学习负担
- 持续更新,能跟随项目进度逐步深入
需要注意的局限是:视频目前刚开篇,实际的LangChain4j代码尚未展开,真正的技术细节(如文档解析、向量化、检索链构建、提示词模板设计)还需要等待后续更新。对于想立刻动手的开发者,建议先补完LangChain4j基础课程,再跟进这个实战系列。
项目采用“主后端+辅前端”的方式,后端从零搭建到业务闭环,前端提供现成页面只写交互。
如果你正在寻找一个Java生态下的RAG入门到实战路径,这个系列值得持续关注。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。