LangChain代理接入结构化外部数据:三种模式与核心挑战

LangChain代理接结构化数据:三种模式、三维决策与分层解耦。
文章围绕LangChain代理接入SEC filings、人口普查、科研出版物和Wikipedia等结构化外部数据集展开讨论。社区实践归纳出三种主流模式:自定义工具封装、MCP服务器中间层和检索管道预处理,各有适用边界。实时查询与向量入库的取舍取决于数据变更频率、查询精度要求和延迟预算三个维度。开发者普遍认为,真正的痛点不是API集成,而是数据规范化与新鲜度管理。最终共识倾向于分层解耦架构——接入层、规范化层、缓存层与编排层各司其职,而非追求大一统方案。
为什么结构化数据成了LangChain代理的短板
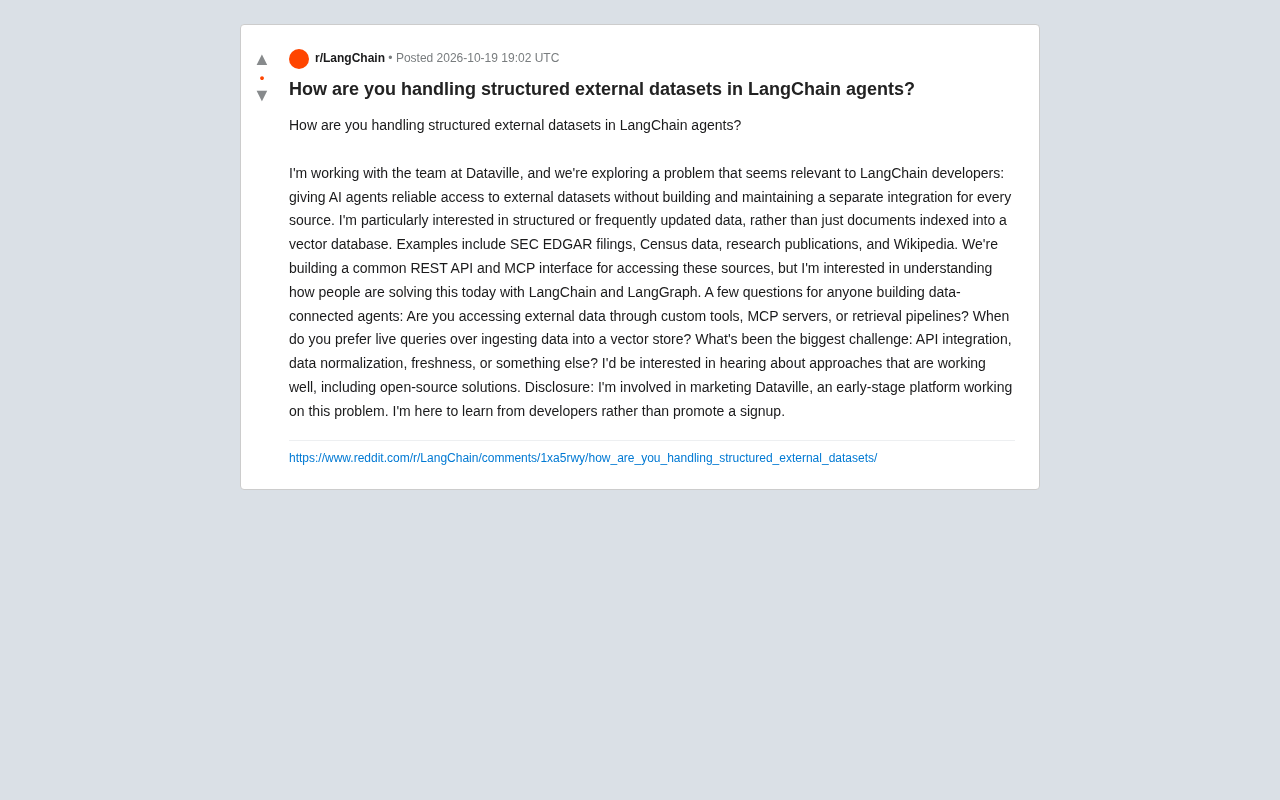
在LangChain生态中,将文档灌入向量数据库做RAG已是成熟路径。但当代理需要访问SEC EDGAR filings、人口普查数据、科研出版物或Wikipedia这类结构化且高频更新的外部数据集时,开发者往往陷入两难:为每个数据源单独构建集成,还是寻找更通用的接入层?
Reddit上一位来自Dataville团队的开发者抛出了这个问题,并坦承正在构建统一的REST API与MCP接口来接入这些数据源。帖子迅速引发讨论,核心分歧不在于"要不要接",而在于"怎么接才不把自己埋进维护泥潭"。
三种主流接入模式:自定义工具、MCP服务器与检索管道
从社区反馈看,当前LangChain开发者处理外部结构化数据主要走三条路,各有适用边界。
自定义工具封装
最直接的方式是为每个数据源编写@tool装饰的函数,内部处理API调用、分页与错误重试。优势是控制粒度细,能针对特定数据源做字段裁剪和缓存策略。缺点也明显:N个数据源意味着N套认证、限流和schema解析逻辑,代理的tool列表会迅速膨胀,LLM在工具选择上的准确率随之下降。
MCP服务器作为中间层
Model Context Protocol的兴起让一部分开发者转向MCP服务器统一暴露数据源。一位回复者提到,MCP的价值在于把"数据接入"从代理逻辑中解耦——LangGraph节点只负责编排,具体取数交给MCP。Dataville团队正在做的正是这件事,但社区对其成熟度仍有疑虑,尤其是MCP在复杂查询参数和事务性场景下的表达能力。
检索管道预处理
对于更新频率低、查询模式固定的数据(如已归档的监管文件),不少团队仍选择离线摄入向量库或SQL表,代理通过retriever或SQL工具访问。这种方式延迟低、成本可控,但牺牲了数据新鲜度。
Model Context Protocol(MCP) 是由 Anthropic 提出并开源的开放协议,用于标准化 LLM 应用与外部数据源、工具之间的通信。它采用客户端-服务器架构:代理侧作为 MCP 客户端,通过 JSON-RPC 与一个或多个 MCP 服务器交互,服务器负责封装具体的数据源或工具能力,并对外暴露统一的资源、提示和工具接口。对 LangChain 开发者而言,MCP 的意义在于把“如何连数据”与“代理如何推理”解耦,使同一套接入层可以复用于不同框架和不同模型,减少为每个数据源重复编写认证、分页和 schema 解析代码。目前 MCP 生态仍处于早期,在复杂查询参数、事务语义和大规模并发下的表达能力与生产成熟度,是社区评估其是否可依赖时的关键观察点。
实时查询 vs 向量入库:判断标准是什么
原帖中"何时偏好实时查询而非摄入向量库"的提问引发了最具体的经验分享。综合多位开发者的判断,决策通常取决于三个维度:
数据变更频率是首要因素。SEC filings按季度更新、Census数据按年发布,这类低频数据完全适合预摄入;而Wikipedia条目可能每小时被编辑,实时查询更合理。
查询精度要求决定架构。向量检索本质是语义近似,当代理需要精确的数值比较(如"营收大于10亿美元的公司")或结构化过滤时,实时查询原始API几乎是唯一可靠选择。
延迟预算则是工程约束。实时API调用引入的网络延迟和限流风险,在交互式代理中可能不可接受;批处理或异步场景则宽容得多。
一位开发者总结得直白:"如果答案依赖精确字段,别用embedding去猜。"
判断某类数据适合实时查询还是预摄入,通常可以先做一次数据画像:记录该数据集的更新周期、单次查询的字段依赖程度,以及代理调用该数据的频率与并发量。若更新周期远长于使用窗口(如按年发布的人口普查数据),预摄入加定期增量同步的收益最高;若字段依赖强、需要精确过滤或聚合,则实时查询原始 API 更可靠;若查询频繁且结果可容忍一定陈旧,检索管道配合较短 TTL 的缓存是折中方案。实践中还可采用混合模式:对高频访问的子集做热缓存,对低频或历史数据走预摄入,对需要强一致性的查询回源实时 API,从而在成本、延迟与新鲜度之间取得平衡。
最大痛点不是集成,而是规范化与新鲜度
当被问及最大挑战时,社区的回答出奇一致——API集成只是体力活,数据规范化和新鲜度才是真正的坑。
不同数据源的schema差异巨大:日期格式、货币单位、缺失值表示、嵌套层级各不相同。代理在工具调用链中拿到原始JSON后,往往需要额外的LLM步骤做字段映射,这既增加token成本又引入不确定性。有开发者建议在MCP或工具层就完成规范化,让代理看到统一的抽象schema。
新鲜度管理同样棘手。缓存策略需要在成本和时效间权衡,而失效检测(如何知道上游数据变了)往往缺乏标准机制。Dataville提出的统一接口思路正是针对这一点,但社区反馈显示,早期平台在数据覆盖深度和SLA上仍需观望。
说个细节,多位开发者提到开源方案在这个领域已有积累,如基于dbt的模式转换层、Airbyte的增量同步,以及各类API网关的缓存插件,这些可以与LangGraph编排层组合使用,而非从零造轮子。
数据规范化指将不同来源的原始字段映射为统一、可预期的抽象 schema,包括统一日期与时间格式(如 ISO 8601)、货币单位与精度、缺失值与空字符串的表示、布尔与枚举取值,以及嵌套结构的扁平化规则。对 LLM 代理而言,规范化不仅减少字段映射所需的额外推理步骤和 token 消耗,也降低工具调用链中的不确定性。常见做法是在接入层之后、进入代理上下文之前,用声明式映射或轻量转换层完成对齐,并用 schema 校验在异常数据进入代理前拦截。新鲜度管理则依赖可观测的失效检测机制,例如上游提供的 ETag、Last-Modified 或变更日志,配合按数据变更频率分级的缓存 TTL 与增量同步策略;缺乏标准失效信号时,可用采样比对或校验和轮询作为兜底。
实践建议:分层解耦而非大一统
从讨论的共识来看,与其追求一个包打天下的数据接入方案,不如在架构上分层:
- 接入层用MCP或轻量API网关统一认证与限流
- 规范化层在进入代理上下文前完成schema对齐
- 缓存层按数据变更频率分级设置TTL
- 编排层由LangGraph根据查询类型路由到实时查询或检索管道
这种分层让每个环节可以独立演进,也避免了把数据源细节泄漏到代理的prompt和工具定义中。对正在构建数据连接代理的团队而言,这或许是比等待某个"标准答案"更务实的路径。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。