LangChain企业级Agent开发实战:从框架搭建到私有化部署

LangChain通过Components、Chains、Agents三大抽象,将大模型安全接入企业业务流,实现私有化Agent开发。
文章系统梳理了LangChain框架的定位与核心概念。大模型裸API存在三大局限:无法访问企业私有数据、无法执行实际动作、无法动态获取外部信息,LangChain正是为弥合此gap而生。其三大核心抽象为Components(类似JDBC Driver的统一模型接口,换模型时代码几乎不变)、Chains(组件编排层,串联模型、数据库、Embedding等)、Agents(与外部环境交互的执行者,是AI从对话工具到生产力工具的关键)。文章还给出私有知识库问答、动态文档学习、业务流程自动化等典型落地场景,并从模型层解耦、数据层选型、工具权限审计、数据不出域四个层面分析企业私有化部署的工程考量,最后建议按Components→Chains→Agents的路径学习。
LangChain企业级Agent开发实战:从框架搭建到私有化部署
如果你已经能调用大模型API写一个聊天机器人,但想让它接入公司内部数据库、自动发邮件、甚至先上网搜索再回答问题——只靠裸调API做不到。LangChain正是为此而生的开源框架。本文基于B站教程内容,系统梳理LangChain的核心概念与企业级Agent开发路径。
为什么需要LangChain:大模型API的三大局限
大语言模型的数据全部来自训练时投喂的互联网公开语料。这意味着公司内部的数据库、私有文件、未公开的业务文档,模型一概接触不到。据B站UP主在教程中的分析,即便你基于OpenAI或国内GLM的API搭建了聊天机器人,它也无法回答基于企业内部数据的问题。
第二个局限是"动手能力"缺失。你可以让模型帮你写一封邮件的正文,但它无法真正调用邮件服务把邮件发出去。第三个局限是缺乏动态信息获取能力——你希望模型先搜索Django官方文档、再基于搜索结果回答问题,裸调API同样无法实现。
LangChain的定位就是弥合这个 gap:它是一个用于开发由语言模型驱动的应用程序的框架,允许开发者将GPT-4等大模型与外部计算和数据源结合起来。需要强调的是,这里的模型不限于OpenAI——谷歌、微软以及国内百度的模型均可接入。教程中提到,LangChain自0.2版本升级后兼容性进一步扩大,国内外主流大模型基本都覆盖了。
核心抽象:Components、Chains、Agents
LangChain通过三个核心概念实现能力增强,理解它们是掌握框架的关键。
Components:大模型的"JDBC驱动"
Components为各类大模型提供统一的接口封装。教程中用一个精妙的类比来解释:它类似于JDBC的Driver——你基于一套抽象接口写代码,底层换用不同的大模型(OpenAI、谷歌、GLM),业务代码几乎不需要改动。
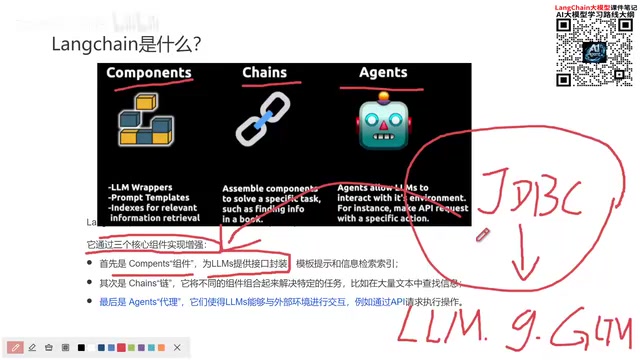
这个设计对企业开发意义重大。模型选型不再绑定代码架构,国内模型好用就用国内,国外模型效果更好就切换国外,迁移成本被压到极低。
JDBC(Java Database Connectivity)是Java语言中用于执行SQL语句的API规范,它定义了一套标准接口,而由各数据库厂商提供对应的驱动实现(Driver)。开发者针对JDBC接口编程,更换数据库(如从MySQL换到Oracle)时只需替换驱动和连接串,业务代码无需改动。LangChain的Components借鉴了这一设计模式:它为大模型定义了统一抽象基类(BaseLLM/BaseChatModel),各厂商的模型通过适配器实现该接口,因此切换模型只需更换配置,极大降低了代码耦合度与迁移成本。
Chains:组件的编排层
Chain将不同组件串联起来完成特定任务。一个企业级AI产品往往同时需要大模型、关系型数据库、向量数据库、Embedding服务——Chain负责把这些组件按业务逻辑连接成一条可执行的流水线。
Embedding是将文本映射为高维稠密向量的过程,语义相近的文本在向量空间中距离更近,是私有知识库检索增强(RAG)的基础环节。向量数据库(如Milvus、Pinecone、Chromadb)专为海量向量相似度搜索设计,与传统关系型数据库按字段精确匹配不同,它通过近似最近邻(ANN)算法实现毫秒级语义检索。在LangChain链路中,用户问题先经Embedding模型向量化,再到向量库中检索相关文档片段,最后与大模型结合生成答案。
Agents:与外部环境交互的执行者
Agents让大模型具备与外部环境交互的能力。教程举了一个典型场景:让模型分析Django官方文档,Agent先调用工具抓取文档内容,再把数据交给大模型处理。这里的"外部"可以是官网、企业数据库、商品信息库。
落到业务上,这意味着智能客服可以基于京东的商品数据做精准应答,销售代理可以自动检索内部资料完成客户跟进。Agent是LangChain从"对话工具"跃迁到"生产力工具"的核心。
工具调用(Tool Calling)指模型在推理过程中,根据自然语言指令自主判断是否需要调用外部函数,并输出结构化参数交由框架执行、再将结果回传给模型继续推理的机制。LangChain中的Tool通常是一个带有名称、描述和参数Schema的Python函数,Agent通过提示词让模型理解可用工具及适用场景。这种循环式决策(ReAct模式:推理—行动—观察)使Agent能完成多步骤任务,但也带来不可控性,因此企业环境需要设置最大迭代次数、工具白名单及调用日志审计。
企业级Agent的典型落地场景
教程中给出了几个有代表性的需求链路,值得在企业开发中参考:
私有知识库问答:向模型投喂100篇行业论文,针对论文内容连续提问,最后指令模型将问答历史整理成邮件发送到指定地址。这条链路同时用到了数据注入、多轮对话、工具调用三种能力。
动态文档学习:将Django官方文档地址交给Agent,让它先抓取并索引文档,后续所有提问都基于该文档范围回答。这解决的是模型知识截止和领域深度不足的问题。
业务流程自动化:通过工具调用完成搜索、发邮件、查询数据库等动作,让AI从"给建议"变成"执行任务"。
教程中有一个判断值得关注:美国AI发展虽快,但真正落地的AI产品并不多,大部分头部公司集中在模型调参和优化上。基于大模型结合企业自身数据完成人性化任务,才是企业级Agent的价值所在。
私有化部署的工程考量
虽然教程侧重概念讲解,但从企业落地视角看,私有化部署LangChain应用需要关注几个层面:
模型层:通过Components的统一接口接入私有化部署的开源模型或企业采购的商用模型API,避免代码与特定厂商绑定。
数据层:向量数据库与关系型数据库的选型需匹配企业现有技术栈,Chain的编排能力让多数据源协同成为可能。
工具层:Agent调用的工具(搜索、邮件、内部API)需要做权限隔离和调用审计,这是企业环境与个人项目的关键差异。
安全边界:私有数据不出域是私有化部署的核心诉求,模型推理服务、向量库、业务数据库都应部署在企业可控的基础设施内。
数据不出域是指企业敏感数据在整个AI处理链路中始终不离开企业自建或私有云环境,避免因调用公有云API而导致数据泄露的合规要求。实现这一目标需要全栈私有化:大模型需部署在本地GPU服务器(如开源Llama、Qwen系列),向量库和业务数据库部署在内网,工具调用及日志也应在企业防火墙内闭环。同时需配合网络隔离、访问鉴权与链路加密,对于金融、医疗等强监管行业,这是LangChain应用能否上线的硬性前提。
学习路径建议
对于零基础入门者,建议按Components → Chains → Agents的顺序推进:先跑通单一模型的调用封装,再尝试两三个组件的串联,最后引入工具调用构建完整Agent。教程强调这三个概念是LangChain未来重点,实际开发中会反复用到。
从框架搭建到落地应用,LangChain的价值不在于替代大模型,而在于把大模型的能力安全、可控地接入企业业务流。理解了这一点,Agent开发就有了清晰的方向。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
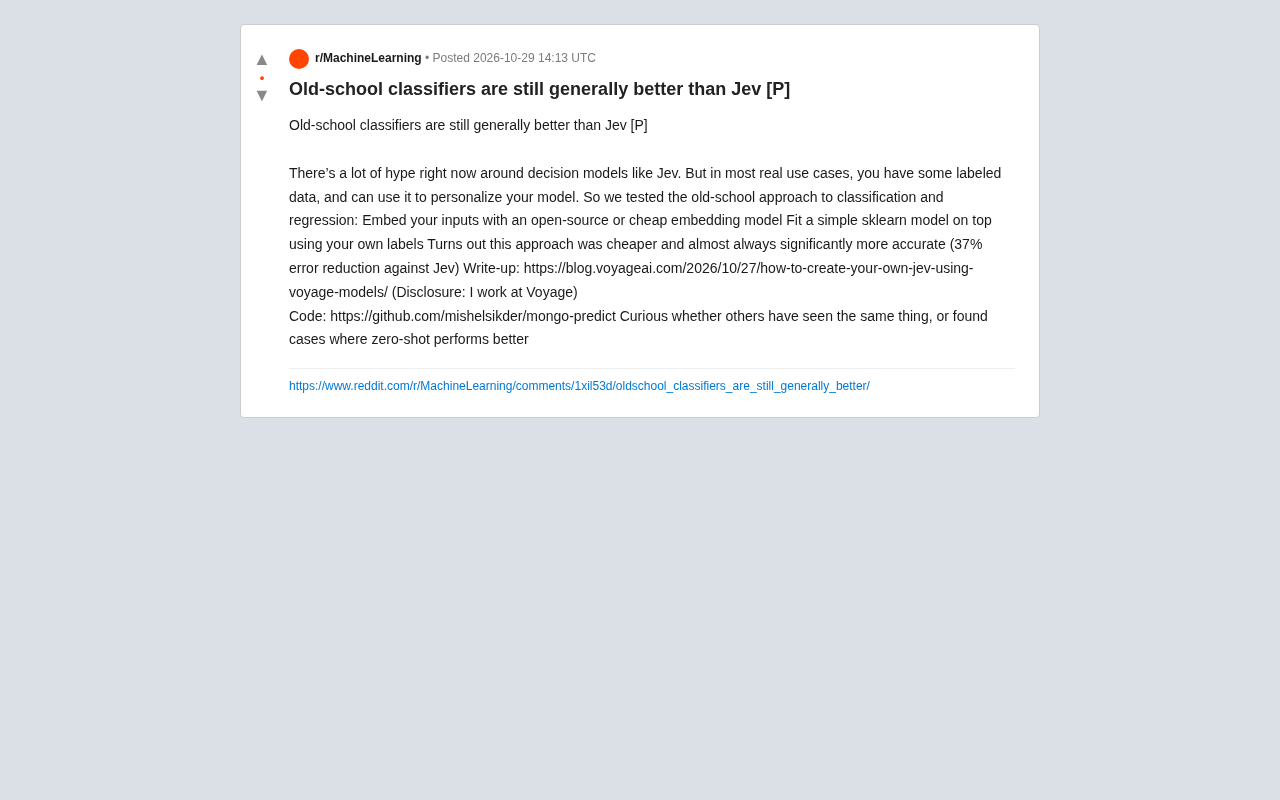
老派分类器仍胜Jev:嵌入+sklearn误差降37%
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。