LangChain入门:为什么大模型应用离不开它
LangChain是为大模型应用开发而生的框架,通过统一抽象补齐知识时效、外部交互和上下文记忆三大短板。
LangChain是2022年10月前后由开源社区推出的AI应用开发框架,核心定位是基于大语言模型构建可落地的智能应用。文章从软件演进的宏观视角切入,指出我们正处于从传统应用向AI智能体时代迈进的关键节点,LangChain正是这一浪潮下的产物。原生大模型存在三大固有局限:训练数据有时间截点、无法与外部系统交互、缺乏跨会话的状态记忆。LangChain通过类似JDBC的统一接口抽象,实现对DeepSeek、OpenAI等多种模型的灵活切换,并在模型外部搭建"感知-记忆-行动"增强层,补齐实时数据查询、企业知识库读取、输出规范化和多轮对话记忆等能力,为RAG和Agent等工业级应用落地提供了完整的底座支撑。
LangChain是什么:一句话讲清框架定位
在AI应用开发领域,LangChain几乎是绕不开的名字。它由开源社区在2022年10月前后推出(原视频提及发起者为Harrison Chase),核心定位可以用一句话概括:它是基于大语言模型(大模型)来开发应用程序的框架。
很多初学者容易被各种碎片化的Demo带偏,学了一堆零散代码却不理解框架本身。真正要用好LangChain,关键不在于记住多少API,而在于理解它为什么会出现、解决了哪些痛点、适用于哪些场景。只有把这些想明白了,才能在实际工作中做技术选型时游刃有余。
和Spring AI、LangChain4j等框架一样,LangChain本质上是围绕AI能力构建的一层开发抽象。当你需要基于大模型去搭建一个真正能落地的应用时,它提供了一整套开箱即用的能力支撑。
从传统应用到智能体时代:LangChain的时代背景
软件形态一直在演进。从早期的单机软件(比如机房里的单机游戏、Photoshop、Office 2000),到互联网应用(淘宝、QQ),再到移动互联网时代(抖音、手机淘宝、微信),每一次演进背后都有对应的技术框架在支撑。
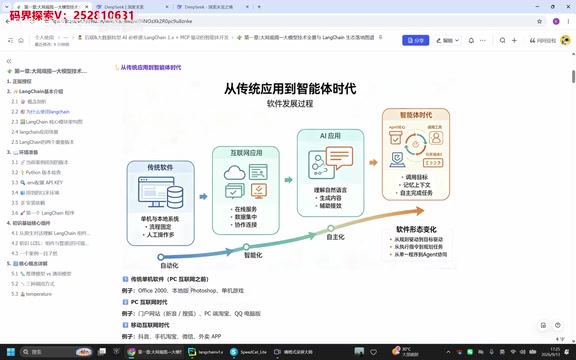
如今我们正处在AI智能化时代,智能客服、自动报表Agent这类应用层出不穷。如果你想开发面向智能体时代的AI应用,LangChain正是这一波技术浪潮下应运而生的开发框架。 它不是凭空出现的工具,而是软件演进到智能体阶段的自然产物。
为什么需要它:单一大模型的三大局限
每个人几乎都用过大模型——打开对话框输入一句话,它就能给出回答。但直接使用原生大模型,存在明显的能力边界。原视频归纳了三个核心局限:
知识有截止时间
大模型的训练数据存在时间截点。去年训练出来的模型,自然不知道当下发生的最新信息。你问它实时资讯,它无从回答。
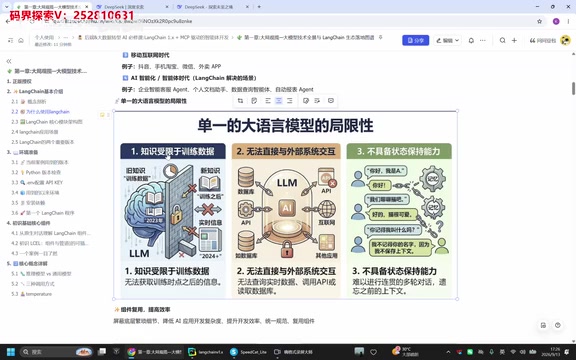
无法与外部系统交互
原生大模型是一个封闭的"大脑"。你让它查询公司的报销制度、查询内部订单数据、调用第三方天气接口或订票服务,它都做不到。它只能基于训练时"记住"的知识作答。
不具备状态保持能力
对话缺乏持续记忆。你告诉它"我是A",关掉窗口再打开,它就不记得你是谁了。没有上下文记忆,就无法支撑真正的多轮对话应用。
这三点合在一起,正是单一大模型在生产落地中最典型的痛点。
值得注意的是,这三大局限并非大模型设计缺陷,而是其技术架构的固有特性。大模型本质上是一个经过海量文本训练的静态参数集合,推理阶段不会主动更新权重、也没有联网或访问文件系统的能力。这意味着即便是最强大的模型,在部署后也是"冻结"的——它拥有截止训练日期前的广博知识,却对之后发生的一切一无所知。正是这种"博学但封闭"的特性,催生了以LangChain为代表的编排框架:框架本身不改变模型权重,而是在模型外部搭建一套"感知-记忆-行动"的增强层,将实时信息、外部工具和会话上下文注入到与模型的每次交互中,从而在不重新训练模型的前提下大幅扩展其实用边界。
LangChain如何补齐能力:统一抽象与复用
LangChain的价值,在于它把上述缺陷一一补齐,同时通过统一抽象大幅提升开发效率。
组件复用,统一接口
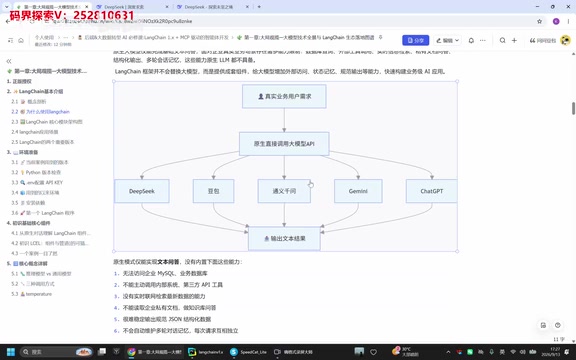
这一点和Java里的JDBC思路如出一辙。用JDBC连接数据库时,无论底层是MySQL、PostgreSQL还是Oracle,你只需面向统一接口编程即可。LangChain对大模型也做了同样的事——不管你接入的是DeepSeek广告、OpenAI、通义千问广告还是豆包、Gemini,都可以通过统一的组件调用,实现"一次开发,灵活切换"。
突破原生大模型的能力限制
如果不用框架、纯手写代码:用户发起需求,代码直接调用大模型,内部封装各家模型输出结果。这条链路看似简单,但无法查询MySQL、读不到公司规章制度、拿不到实时数据、调不了第三方接口。
而引入LangChain之后,这些能力都能被补齐:
- 实时查询数据库(如MySQL最新数据)
- 读取内部文档(企业知识库、规章制度)
- 输出规范化结果
- 多轮对话记忆
换句话说,LangChain把"孤立的大模型"改造成了"能感知外部世界、能记住上下文、能协同多种数据源"的完整应用底座。这也正是RAG(检索增强生成)和Agent这类工业级应用得以落地的基础。
RAG(Retrieval-Augmented Generation,检索增强生成)是LangChain最典型的落地范式之一。其核心思路是:在用户提问时,先从外部知识库(如企业文档、数据库)中检索出相关片段,再将这些片段连同原始问题一起拼入提示词(Prompt),交由大模型生成最终答案。这样一来,模型输出的内容就不再局限于训练时的静态知识,而是能实时"参考"最新文档。Agent则更进一步——它赋予模型"工具调用"能力,让模型自主决定何时查询数据库、何时调用API、何时需要多步推理,整个过程形成一个动态的规划-执行循环。LangChain为这两种模式都提供了开箱即用的抽象组件,这也是它在工业落地场景中被广泛采用的根本原因。
小结:理解框架产生的意义
这一章几乎不涉及代码,但重要性不容低估。理解LangChain"从哪里来、解决什么问题",比急着敲代码更关键。
记住三个核心结论:LangChain是基于大模型开发应用的框架;它诞生于从传统应用向智能体时代演进的浪潮中;它通过统一组件抽象和外部能力集成,补齐了单一大模型在知识时效、外部交互和状态记忆上的三大短板。掌握了这个认知框架,后续深入核心模块、RAG与Agent实战时才能事半功倍。
相关推荐
421M参数Laya模型玩转Flappy Bird:CPU上的OpenVINO INT8推理实践
一位开发者用OpenVINO将421M参数的Laya模型量化到INT8,成功在英特尔i7 CPU上运行Flappy Bird游戏。本文拆解OpenVINO转换、INT8量化的技术要点,以及消费级CPU运行数亿参数模型对端侧AI部署的意义。
本地27B AI Agent自主完成亚马逊购物:一次跑通全流程
一位开发者用本地运行的Qwen3 27B模型加TensorSharp运行时,让AI Agent自主完成亚马逊购买A4纸的全流程。推理、决策、代码生成全部本地化,仅登录和付款人工干预。本文拆解其技术栈与本地浏览器Agent的价值和局限。
蚂蚁AntLing开源Ming-Image-0.1-Design:6B设计图像模型登顶UI/UX榜首
蚂蚁AntLing(inclusionAI)开源Ming-Image-0.1-Design系列6B图像模型,登顶Artificial Analysis开放权重UI/UX设计榜首,附带分层模型及UI设计、图转可编辑PPT两项Agent技能。