LangChain入门指南:核心概念与工具实战

LangChain 是智能体的封装框架,公式为智能体 = 模型 + Harness。
文章基于一节实战课程,系统梳理了 LangChain 的定位、核心价值与入门路径。作者首先给出心智模型:智能体 = 模型 + 封装框架(Harness),LangChain 就是这样一套通用脚手架,类比 Java 生态中的 Spring。它主要解决三类问题:突破模型训练时间节点限制以访问外网、连接外部数据与内部系统(如 RAG 与向量数据库)、管理多轮对话的上下文状态。文章特别提醒一个常见误区——DeepSeek、ChatGPT 等对话框产品已是封装好的智能体,不等于通过 API 调用的裸模型,后者缺失的能力正需 LangChain 补齐。入门建议是先过官方文档、跑通基础 demo,再深入工具调用与记忆机制。
LangChain 已经成为大模型应用开发的事实入门框架。如果你已经具备 Python 基础,想快速搭建智能体、接入外部数据或实现多轮对话,它几乎是绕不开的第一站。本文基于一节实战课程的内容,梳理 LangChain 的定位、核心特点、典型场景,并给出快速上手的路径。
LangChain 是什么:智能体 = 模型 + 封装框架
课程开篇给了一个清晰的公式:智能体 = 模型 + 封装框架。模型指的是 DeepSeek广告、Claude、GPT 这类大语言模型,而封装框架就是 LangChain 这套生态。官方文档的英文表述更直接——Agent 就是模型加上 Harness(脚手架),LangChain 本质上是一套 Harness 解决方案。
据 B 站该课程讲师介绍,市面上 OpenAI、DeepSeek 都推出了类似套路,方向大同小异,有的走差价维度,有的走自有生态,而 LangChain 走的是比较通用的路线。它的官方文档健全,入门 demo 和代码示例齐全,因此前期搞大模型应用建议直接从 LangChain 入手。
LangChain 是一个用于开发大语言模型驱动应用的开源框架。类比 Java 开发中的 Spring——Spring 帮你快速驱动 Web 应用,LangChain 帮你快速驱动模型。但它不只是对模型调用 API 做封装,工具调用、上下文管理这些看似简单的词,背后关乎的东西很多,LangChain 生态内部已经帮你集成好了,不需要从零搭建复杂架构。
理解"智能体"需要区分它与单纯调用的差别。裸模型只能根据输入文本生成输出文本,无法主动采取行动;智能体则是在模型之外加了一层循环控制:模型先判断是否需要调用工具(搜索、计算器、数据库查询、代码执行等),框架解析模型给出的调用意图、实际执行工具、把结果回填给模型,再由模型决定下一步,如此往复直到任务完成。这套"思考—行动—观察"的循环就是 Harness(脚手架)承担的职责。Harness 一词源自测试与工程领域,指包裹被测对象、为其提供运行支撑的外壳;在这里它指围绕模型搭建的编排层,负责提示词组装、工具注册与调度、输出解析、错误重试和状态管理。正因如此,同一个模型配上不同的 Harness,实际表现可以相差很大。
LangChain 解决的三个核心问题
课程把 LangChain 的核心价值归纳为三个维度,虽然不止这三点,但这三个最能体现它的不可替代性。
突破模型训练时间节点的限制
大模型并非无所不知,它只知道训练时间点之前的事情。比如模型是六月份训练的,你问八月份的事它不知道。模型本身没有能力直接调用工具或访问外网,但它知道"自己不知道",却无法自己去查。LangChain 生态提供了访问外网的工具,帮模型完成查询。
这里有个容易混淆的点:你在 DeepSeek 对话框里发消息,并不是直接跟裸模型交互,那个产品本身已经是类似知识库或智能体的形态,内部提供了访问外网的能力。纯粹的模型没有关联外网的能力。
连接外部数据与内部系统
做 RAG、搞知识库,需要走向量数据库、做溯源,模型本身依然没有这个能力。LangChain 可以帮你访问公司内部的数据库,把外部数据接入模型的工作流。
RAG(Retrieval-Augmented Generation,检索增强生成)是当前大模型落地最常见的工程范式:用户提问时,系统先在外部知识库(文档、数据库、网页等)中检索出与问题相关的片段,再把这些片段作为上下文拼进提示词,让模型基于真实资料作答。它绕开了两个原生难题——模型训练数据有截止时间、且无法覆盖企业内部私有信息。实现 RAG 通常需要文档切分、向量化(Embedding)、存入向量数据库、相似度检索、重排序等环节,向量数据库负责存储文本的稠密向量并支持近似最近邻搜索;"溯源"则指在返回答案时附带引用出处,便于用户核实、降低幻觉风险。LangChain 的价值在于把这一整条链路抽象成可组合的组件(文档加载器、文本分割器、向量存储、检索器),开发者只需按需拼装,而不必自己实现每层协议与接口适配。
管理多轮对话的上下文状态
正常来说模型是一问一答,你再问它完全基于当前问题回答,不会参考之前的说法。多轮上下文沟通的效果很好,但裸模型没有记忆能力。LangChain 提供了上下文管理机制,当然你自己也能做,只是 LangChain 把这些事情变得很容易处理。
大模型 API 本身是"无状态"的:每次请求都是一次独立的推理,服务端不会记住你上一句说了什么。所谓多轮对话,本质上是客户端在每次请求时把历史消息(用户与助手的往返内容)一并塞进上下文窗口重新发送。这带来两个现实约束:一是上下文窗口长度有限,历史越长 token 消耗越大、成本越高、响应越慢,且过长的上下文可能稀释关键信息;二是超出窗口后必须做截断或摘要压缩。LangChain 的 Memory 组件正是对这一过程的封装,提供按轮次保留、按 token 数裁剪、对历史做滚动摘要等多种策略,并可与会话存储后端结合,实现跨请求的状态持久化。理解"记忆靠重发历史实现"这一点,才能合理设计多轮对话的成本与效果平衡。
快速入门路径与学习建议
课程的实操部分覆盖了消息传递方式、模型调用方式、结构化输出、工具调用以及短期上下文记忆等内容。入门代码非常 easy,官方文档提供了完整示例。
讲师给出的学习路径是:先过一遍官方文档,把基本小功能跑通,再通过代码实践。英文文档描述最清晰,英文水平有限可以结合翻译软件或直接看中文文档。
需要留意的是,LangChain 细节很多,一节课只能覆盖基础功能。工具调用、记忆机制这些进阶内容需要后续专题深入。对于刚接触大模型应用的开发者,建议先把"模型+封装框架"的心智模型建立起来,理解 LangChain 在智能体架构中的位置,再动手写代码,会比直接抄 demo 更有收获。
常见误区提醒
不要把模型产品等同于裸模型。你在对话框里用的 DeepSeek、ChatGPT 已经是封装好的智能体产品,它们内置了联网、知识库等能力。而通过 API 调用的裸模型,这些能力都需要 LangChain 这类框架来补齐。理解这个区别,才能想清楚什么时候需要 LangChain,什么时候直接用现成产品就够了。
相关推荐
AI新物种FDE落地实战:核心职责与就业指南
深入解析AI新物种FDE(前沿部署工程师)的三大核心职责、与算法后端产品的角色分工,以及面试就业准备指南,结合学习平台智能体改造实战案例,帮助开发者理解AI落地最后一公里的关键角色。
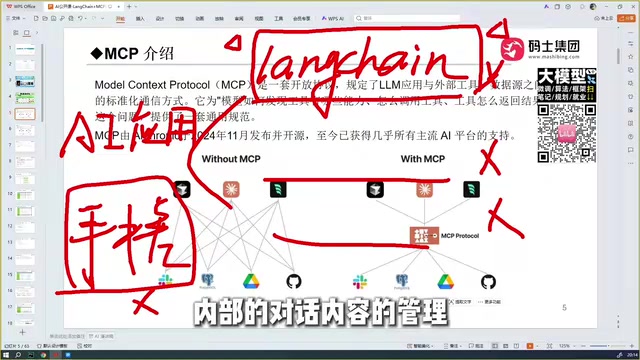
LangChain + MCP 实战:架构协议与 Agent 工具集成
从 LangChain 框架与 Agent 封装讲起,解析 MCP 协议如何解决工具跨模型、跨框架复用的难题,对比 MCP 与 Function Calling 的关系,梳理 LangChain 技术栈层次与 Agent 开发要点。
Codex 实战全流程:环境安装到 Skills 与 MCP 调用
Codex 是 OpenAI 推出的 AI 编程助手,本文梳理其定位、与 Claude Code 的对比、环境安装中的模型配置坑,以及 Skills 与 MCP 调用的实战思路,适合零基础开发者快速上手。