LangChain深度进阶指南:从会用到底层原理

LangChain进阶学习应从API使用转向源码与设计模式,理解抽象层背后的取舍。
文章针对开发者掌握LangChain基础用法后遇到的瓶颈,提出一条从“会用”到“懂原理”的进阶路径。作者指出官方文档和视频教程多停留在基础操作,而真正被考察的是Chain调用链路、Agent执行循环、记忆存储与检索、工具调用序列化等内部机制。进阶策略分两步:一是从核心抽象入手,吃透Runnable、BaseLanguageModel、BaseTool、AgentExecutor等基类,重点理解Runnable管道协议与LCEL的关系;二是追踪AgentExecutor源码以掌握ReAct循环、工具调用解析和错误处理,并深入VectorStore与Retriever的接口设计。实战上建议用LangChain重构已有的Strands Agent,通过跨框架对比加速理解,同时参与开源社区讨论。
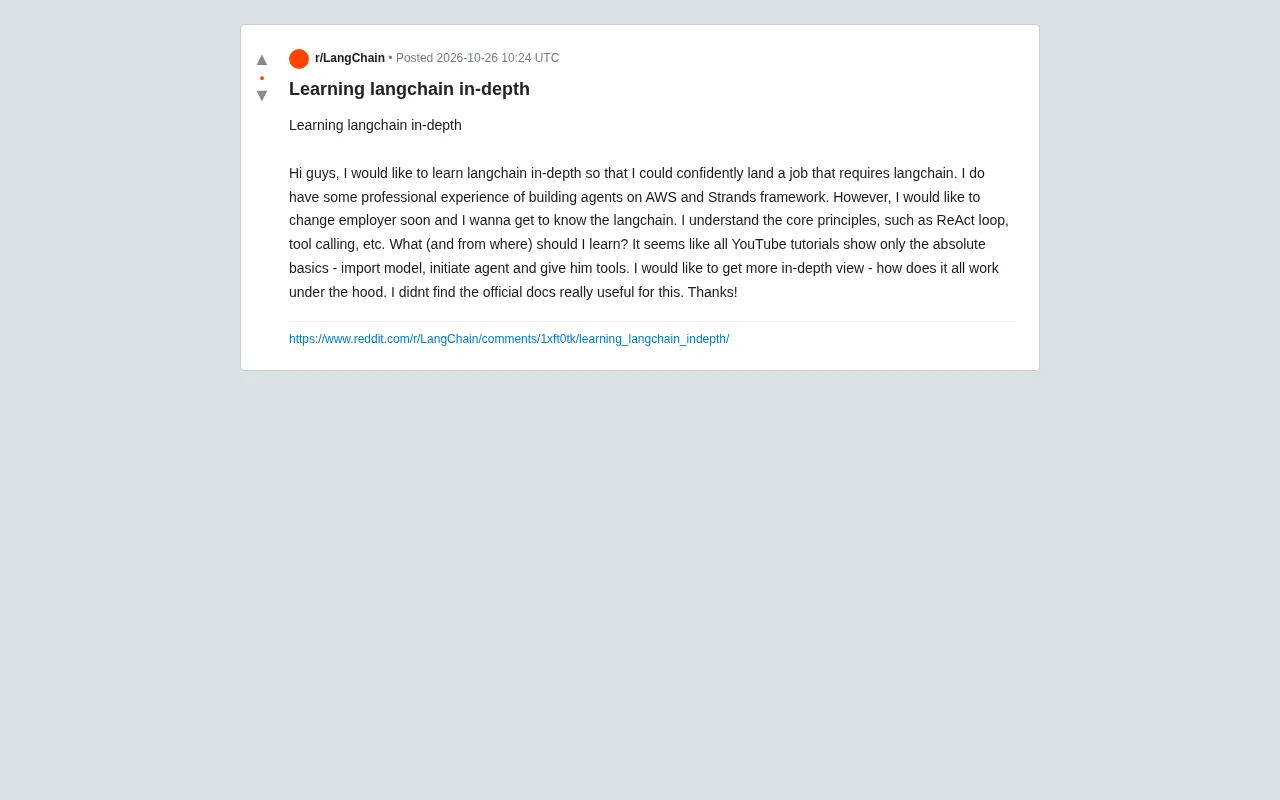
在AI应用开发领域,LangChain已经成为构建智能体、RAG系统和复杂工作流的首选框架之一。但许多开发者在掌握基础用法后,都会遇到同一个瓶颈:如何真正深入理解它的运行机制,而不是停留在"导入模型、创建Agent、绑定工具"的入门阶段。最近Reddit上一位开发者的提问引发了广泛共鸣——他已有使用AWS Strands框架构建Agent的经验,但对LangChain的底层实现感到困惑,希望获得一份进阶学习路线。
为什么官方文档和视频教程不够用
这位开发者坦言,YouTube上的教程几乎千篇一律地演示基础操作,官方文档在解释内部机制方面也差强人意。这并非个例。LangChain的抽象层设计虽然降低了使用门槛,但也隐藏了大量细节——Chain的调用链路、Agent的执行循环、记忆的存储与检索、工具调用的序列化过程,这些才是面试和实际项目中真正考察的内容。
要突破这一层,学习路径需要从"使用API"转向"阅读源码与设计模式"。
从核心抽象入手
建议优先吃透几个关键基类:Runnable、BaseLanguageModel、BaseTool、AgentExecutor。理解Runnable的管道协议是理解整个框架的钥匙——LCEL(LangChain Expression Language)的链式调用本质上是对Runnable接口的组合。当你弄明白invoke、batch、stream背后如何统一处理输入输出时,很多"黑盒"行为就变得透明了。
LCEL(LangChain Expression Language) 是 LangChain 在 0.1 版本后主推的声明式编排语法,用管道符 | 把多个 Runnable 对象串联成链,例如 prompt | model | parser。它的核心约定是:任何实现了 Runnable 协议的对象都可以被组合,管道左侧的输出自动成为右侧的输入。LCEL 在底层通过 RunnableSequence 把链式调用转换为嵌套的 invoke 调用,并自动继承 batch、stream、ainvoke 等能力,无需为每条链单独实现。理解 LCEL 的关键在于认识到它并非语法糖,而是一套基于 Runnable 接口的组合契约,这正是原文强调“弄明白 Runnable 的管道协议是理解整个框架的钥匙”的原因。
AgentExecutor的执行循环
你已理解ReAct循环和工具调用,下一步是追踪AgentExecutor的源码:它如何解析LLM输出中的工具调用意图、如何构造中间步骤、如何处理工具返回结果并决定是否继续循环。重点关注超时控制、错误处理和最大迭代次数的实现,这些是生产环境稳定性的关键。
ReAct(Reasoning + Acting) 是一种让 LLM 交替进行推理与行动的提示范式:模型先输出一段思考(Thought),再决定调用哪个工具(Action)并给出输入(Action Input),框架执行工具后把结果(Observation)回填给模型,如此循环直到模型给出最终答案(Final Answer)。LangChain 的 AgentExecutor 本质上就是这一循环的运行时实现——它负责解析 LLM 输出中的 Action 与 Action Input、调用对应工具、把 Observation 拼回提示词,并依据 max_iterations、early_stopping_method 等参数决定何时终止。原文提到的“解析 LLM 输出中的工具调用意图”正是 ReAct 文本解析环节,而现代 LangChain 也支持模型原生 function calling 来替代文本解析,两者在 AgentExecutor 中走不同的输出解析器分支。
记忆与检索的底层实现
对于RAG场景,深入VectorStore和Retriever的接口设计,理解嵌入模型、相似度搜索和文档分割器之间的协作关系。不要只调用asRetriever(),而是尝试自己实现一个简单的Retriever,这能帮你理解LangChain的抽象边界在哪里。
VectorStore 与 Retriever 是两个不同层次的抽象:VectorStore 负责向量的存储与相似度检索(如 similarity_search),是偏底层的存储接口;Retriever 则是更通用的检索接口,只暴露 get_relevant_documents(新版为 invoke),任何能根据查询返回文档的对象都可以是 Retriever,不一定是向量库。asRetriever() 只是把 VectorStore 包装成 Retriever 的适配器,中间还可以插入 MMR、相似度阈值、多查询改写等策略。原文建议“自己实现一个简单的 Retriever”,正是因为这一层抽象边界最容易被 asRetriever() 掩盖——自己实现时你会被迫面对查询构造、文档打分与返回格式这三个关键决策点。
实战驱动的进阶策略
单纯阅读源码容易迷失,更有效的方式是带着问题去实践:尝试用LangChain重构你之前用Strands框架构建的Agent,对比两者在工具调用、状态管理和错误恢复上的设计差异。这种迁移式学习能让你快速识别LangChain的设计哲学。
积极参与开源社区也是重要途径——LangChain的GitHub Issues和Discussions中有大量关于内部机制的讨论,许多设计决策的背景能在其中找到答案。
AWS Strands Agents 是 AWS 于 2025 年开源的智能体框架,采用“模型驱动”的设计思路:开发者只需定义工具函数和系统提示,由模型自主规划调用顺序,框架本身不强制 ReAct 式的显式循环。这与 LangChain 的 AgentExecutor 形成对照——后者把循环、解析、终止条件都显式暴露为可配置组件,控制力更强但样板代码更多。原文建议用 LangChain 重构 Strands 构建的 Agent,其价值在于:当你发现 Strands 中“隐式”完成的事情在 LangChain 中需要显式配置哪些组件时,两套框架的设计取舍就会变得非常具体,这比单纯读源码更容易建立起对抽象层次的直觉。
总结
掌握LangChain的深度不在于记住更多API,而在于理解其抽象层背后的设计取舍。从Runnable协议出发,追踪AgentExecutor的执行链路,深入记忆与检索的底层实现,再通过跨框架迁移实践巩固理解——这条路径能帮你从"会用"走向"懂原理",在面试和复杂项目中建立真正的竞争力。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。