LangSmith实战指南:用Python做好LLMOps全流程
LangSmith是LangChain生态的LLMOps平台,提供追踪、评估、监控与Prompt管理,帮助AI应用从原型走向可观测的生产环境。
LangSmith是专注于AI应用运维的可观测性平台,覆盖追踪、调试、评估与监控全流程,但自身不提供模型能力。接入方式极轻量,配置环境变量后即可自动记录LangChain调用;通过`@traceable`装饰器,任意Python函数都能作为节点出现在调用链追踪树中,帮助定位耗时瓶颈和错误。评估体系支持精确匹配与LLM裁判两种范式,实验对比功能可横向量化不同Prompt或模型的优劣,且评估标准的措辞直接影响结果,需谨慎设计。Playground与版本化Prompt管理加速调试迭代,在线评估器与告警机制保障生产稳定,标注队列引入人工把关。所有核心功能均在免费层可用,是将智能体应用推向生产的关键工具链。
LangSmith是LangChain生态中专注于LLMOps的工具组件。如果说LangChain负责构建智能体、LangGraph负责编排复杂的有状态工作流,那么LangSmith承担的就是追踪、调试、评估和监控这一整套可观测性工作。本文基于一期约一小时的实战教程,梳理LangSmith的核心能力与实际用法,帮助你把智能体应用的运维环节真正落地。
LangSmith是什么:定位与接入
LangSmith本质上是一个面向AI应用的MLOps/AIOps平台,覆盖监控、可观测性、评估、追踪等环节。它本身不提供模型能力——你依然需要OpenAI、Anthropic、Google或本地Ollama等推理提供方,LangSmith只负责记录和分析这些调用发生了什么。
接入方式很轻量:注册账号后在设置中创建API Key,然后在项目的.env文件里配置三类变量——LangSmith的API Key、项目名称、以及LANGSMITH_TRACING=true开关,再加上你所用模型提供方的密钥(如OpenAI API Key)。教程中使用uv作为包管理器,安装langsmith、openai和python-dotenv三个基础包即可开工。值得强调的是,本文覆盖的全部功能都在免费层可用,付费托管计划并非入门必需。
追踪(Tracing):定位瓶颈的核心武器
追踪是LangSmith最重要的功能。最简单的用法是用wrap_openai包装OpenAI客户端,这样每一次chat.completions.create调用都会被自动记录到LangSmith,包括输入、输出、token数和成本。
但单次问答的追踪价值有限。真正的威力体现在调用链变复杂之后。教程演示了一个describe函数,内部先用count_words统计词数再交给模型判断文本长短。只要在这些函数上加@traceable装饰器,它们就会作为嵌套的链路节点出现在追踪树中。你能清楚看到:count_words执行只花了0.00秒不是瓶颈,真正耗时的是对OpenAI的调用。当代码出错(比如误用choice而非choices)时,错误也会被完整记录下来,方便排查。
更进一步,当接入真正的智能体时追踪才最有意思。教程用langchain.agents的create_agent构建了一个带get_favorite_food工具的智能体。由于LangChain与LangSmith同属一个生态,此时连import langsmith都不需要,环境变量会被自动识别并完成追踪。在LangGraph类型的追踪记录里,可以逐层看到模型决定调用哪个工具、工具返回了什么、以及每一段的耗时和成本。教程还顺带展示了MCP服务器的工具同样可被追踪——对LangSmith而言,无论工具定义在代码里还是来自MCP,看到的都是"智能体调用了一个工具"。
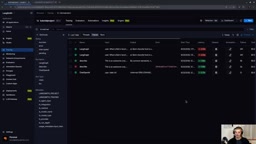
追踪界面还支持按条件过滤,比如只看延迟大于2秒的trace,快速锁定慢请求。这里需要区分两个术语:run指单次调用,trace指更高层级的完整链路。
@traceable 装饰器是 LangSmith Python SDK 提供的核心机制。它本质上是一个函数包装器,在函数执行前后自动向 LangSmith 后端上报元数据:函数名、输入参数、返回值、执行耗时、异常信息等。被装饰的函数会成为追踪树中的一个独立节点(称为 span),多层嵌套调用则自然形成父子关系的树状结构。这与分布式系统中的 OpenTelemetry 追踪模型非常相似——LangSmith 实际上也支持通过 OpenTelemetry 协议接入,这意味着非 Python 技术栈(如 Node.js、Java)同样可以将追踪数据推送至 LangSmith。wrap_openai 则是更上层的快捷封装,专门针对 OpenAI SDK 的客户端对象做猴子补丁,无需修改已有调用代码即可启用追踪,适合快速接入既有项目。
数据集与实验:量化评估模型表现
数据集(Dataset)和实验(Experiment)是两个相关概念。数据集是"输入-输出"组合的集合,并带有正确的参考输出;实验则是在数据集上跑模型,把模型输出与参考输出对比,得出评估结果。
教程给出两类评估范式:
精确匹配评估
针对情感分类这类有确定答案的任务,先用client.create_dataset和client.create_examples构建数据集,再写一个推理函数和一个exact_match评估函数(直接比较label是否完全一致,返回布尔值)。最后调用client.evaluate,传入推理函数、数据集名、评估器列表和实验前缀即可。运行后在UI里能实时看到准确率、耗时等指标。
LLM作为裁判(LLM-as-a-judge)
对于"哺乳动物和鸟类有什么共同点"这类开放问答,答案不必逐字相同,只要语义一致即可。此时用另一个模型充当裁判,接收问题、参考输出和实际输出,判断"是否语义正确",返回yes/no。
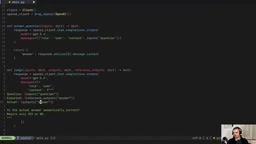
这里有个很有启发的细节:教程通过调整裁判的系统提示词——从"语义是否正确"改为"是否精确聚焦于唯一答案、无多余信息"——让原本100%通过的评估出现了失败案例。这说明评估标准的措辞直接决定了结果。随后通过给推理函数加系统提示词("简洁回答,只给一个答案")又提升了通过率。
LangSmith还支持实验对比:选中两次运行就能并排比较哪个更快、用token更少、更便宜、准确率更高,差异会被高亮标出。这正是用来横向评估不同prompt或不同模型优劣的利器。
此外,还能基于真实的追踪记录反向生成数据集——先用模型跑一批问题,再通过反馈标记(feedback)筛选出需要的run,用client.list_runs配合过滤查询语句(如feedback_key等于某标记、feedback_score等于1)批量导出为数据集。
LLM-as-a-judge(大模型充当裁判)是当前 LLM 评估领域的主流范式之一,其理论依据是:对于语义层面的判断,语言模型本身往往比硬编码的规则或字符串匹配更接近人类评估标准。常见实现是将"问题、参考答案、待评答案"拼入一个结构化提示词,让裁判模型输出 yes/no 或 1-5 分的评分。这一方法的最大缺陷也正是文章所揭示的:裁判的判断高度依赖提示词措辞,不同的评估标准描述可以导致通过率从 100% 骤降至 0%,因此评估的可复现性和标准的稳定性至关重要。实践中通常建议将裁判提示词本身也版本化管理,并定期用人工抽检来校准裁判模型的判断是否仍与业务预期一致。
在线评估、Playground与Prompt管理
除了离线的数据集评估,LangSmith还能配置在线评估器——始终处于激活状态,每当有新调用产生就自动评估。教程创建了一个"简洁度裁判",绑定到追踪项目上。需要注意的是,这会消耗你自己的API Key额度。由于评估需要时间,结果不会即时出现,但请求本身已被记录,稍后刷新即可看到裁判结论。
Playground则是实验场,用来对比不同模型、调试系统提示词和输出结构。教程中对比发现某个模型天然更简洁,而另一个"话痨"模型即便加了"永远极度简洁""不要代码示例"等提示词仍难以约束,最后通过设定JSON输出schema反而拿到了更简洁的结果。满意的配置可以一键保存为Prompt,并带版本历史和提交记录,之后能用client.pull_prompt在Python代码里拉取复用,配合LangChain的管道语法(prompt | model)直接调用。
人工标注、监控与告警
**标注队列(Annotation Queue)**面向需要人工评估的场景。你可以把特定run加入队列,让人类逐条查看模型的回答,从质量、简洁度、工具调用是否必要等维度打分。要注意feedback功能的本意是人工评估run质量,而非单纯做标记(尽管实践中也常被用于筛选高质量样本)。
监控分两个标签页:Dashboard提供延迟、LLM调用、工具使用等量化概览;更实用的是告警(Alerts)。教程演示了设置"过去5分钟平均延迟超过1秒就触发通知"的规则,通知渠道支持Slack、PagerDuty、Datadog或自定义Webhook。用webhook.site做测试后,发送一个请求触发了1.98秒的延迟,随后便收到了包含告警ID和规则的POST通知。
实战案例:文档抽取流水线
教程最后给出一个贴近真实应用的例子:发票PDF抽取。流程是先用Mistral OCR识别扫描件文本(可追踪),再用**Google Gemini(通过Vertex AI)**做结构化输出生成,整个工作流跨越了多个提供方。
一个值得学习的细节是自定义成本核算。LangSmith默认不认识Mistral OCR的价格,而且OCR是按页计费而非按token。教程的变通做法是在设置的模型定价中创建自定义模型,把"每百万页4000美元"填进"每百万token价格"的字段来模拟按页计费——这样每页成本约0.004美分就能在追踪中正确显示。同时要在@traceable中设置metadata标明使用的是mistral-ocr-latest。运行后能清楚看到整条链近6秒的耗时主要来自Gemini Flash的推理,而非OCR。
Mistral OCR 是 Mistral AI 推出的文档理解服务,能够处理扫描版 PDF、图片等非结构化文档,输出结构化文本或 Markdown。与传统基于规则的 OCR 引擎不同,它以视觉语言模型为底层,对复杂版式(如表格、多栏、手写体)的识别容错率更高。计费方式按页数而非 token 数,这正是文章中自定义成本核算的背景——LangSmith 的默认成本模型以 token 为单位,无法直接映射到按页计费的服务,需要借助"用页数换算进 token 字段"的变通方式来保持追踪记录中成本数据的可读性。Vertex AI 则是 Google Cloud 托管的 AI 平台,Gemini 系列模型可通过 Vertex AI 端点调用,适合需要在 GCP 基础设施上部署的企业场景。
小结
LangSmith把AI应用从"能跑"推进到"可观测、可评估、可运维"。追踪帮你定位瓶颈和错误,数据集与实验让模型表现可量化比较,在线评估和告警保障生产稳定,Playground和Prompt管理加速迭代,标注队列引入人工把关。对于正在构建智能体应用的开发者来说,这套工具链是把实验原型推向生产的关键能力。免费层已足够完成入门全流程,建议结合自己的真实用例动手实践,而不是照搬教程——在踩坑中才能真正掌握。
相关推荐

一场与Grok的对话能否影响重大决策?素材不足的警示
一则关于美国因与Grok对话影响委内瑞拉决策的Hacker News标题引发关注,但缺乏正文与信源。本文探讨此类耸动标题的识别方法与AI在决策中的真实边界。

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。