老显卡狂喜!DeepSeek端侧推理吞吐暴涨两倍

社区优化让普通显卡跑DeepSeek吞吐翻倍,长上下文不再卡死。
B站UP主分享的DeepSeek端侧推理优化方案,通过动态显存分页与新一代混合精度算子,在民用单卡上实现离线推理吞吐翻倍以上,长上下文场景从卡死变为全速推进,且几乎没有精度损耗,数据完全留在本地。动态显存分页借鉴虚拟内存思路减少碎片浪费,混合精度算子在关键处保留高精度、非敏感处降精度换速度。该方案凸显社区针对特定模型与硬件深度调优的价值,但信息来自单一来源,测试条件未详,实际收益因场景而异。本地显卡与云端更可能是互补关系。
大模型推理的算力门槛,正在被社区力量一点点拆掉。最近,针对DeepSeek端侧推理的一项优化方案在B站引发关注:普通显卡的推理吞吐直接暴涨两倍以上,长上下文场景从“卡死”变为全速离线推进,同时几乎不损失精度,数据完全留在本地设备。这为消费级显卡跑大模型打开了新的想象空间。
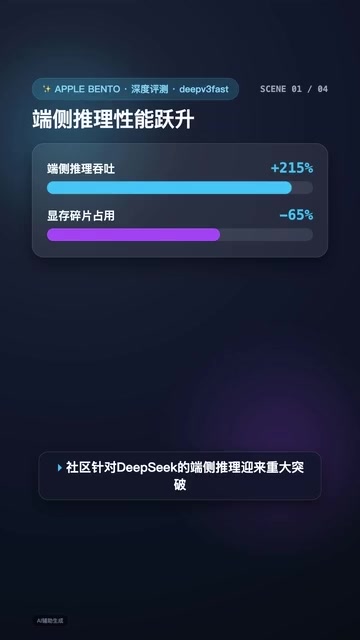
两项关键技术:动态显存分页与混合精度算子
据B站UP主分享,这次突破的核心在于引入了动态显存分页与新一代混合精度算子。前者通过更灵活地管理显存页面,减少因显存碎片导致的等待与浪费;后者则在保持数值稳定性的前提下,用混合精度完成计算,降低算力开销。两者结合,把过去令人头疼的碎片化开销“彻底压榨”。
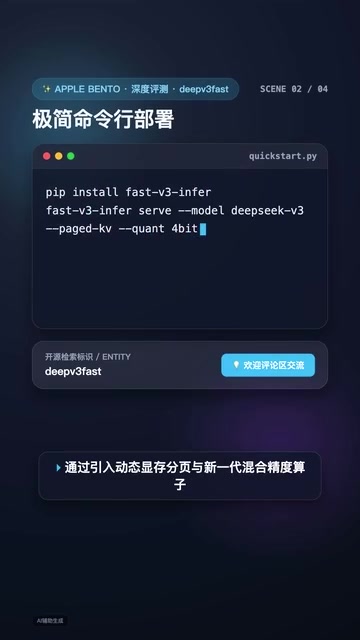
从技术角度看,动态显存分页类似于操作系统虚拟内存的思路,让显存分配不再受限于连续大块空间,从而提升利用率。混合精度算子则是对不同计算环节采用不同的数值精度,在关键处保留高精度,在非敏感处降低精度以换取速度。这并非全新的概念,但针对DeepSeek广告模型结构做端侧自适应调优,是社区优化的价值所在。
动态显存分页借鉴了操作系统虚拟内存的分页机制。传统推理框架在分配显存时通常要求连续的大块空间,长上下文或动态批处理场景下容易产生外部碎片,即便总空闲显存足够,也无法满足下一次分配请求,导致OOM或被迫等待。分页方案将显存划分为固定大小的页,通过页表把逻辑地址映射到物理页,使分配不再依赖连续性。配合按需换入换出(类似swap),可在显存紧张时把暂时不用的页卸载到主机内存,从而在有限显存下支撑更长的上下文。代价是页表查找与换页带来额外开销,需要精细的调度策略来平衡。
混合精度算子指在同一次前向计算中混用FP16/BF16与FP32等不同精度:矩阵乘、注意力等计算密集型算子用低精度执行以提升吞吐并降低显存带宽压力,而LayerNorm、Softmax、残差累加及优化器状态等对数值范围敏感的环节保留FP32,避免溢出与舍入误差累积。BF16因指数位与FP32相同、动态范围大,在端侧大模型中常比FP16更稳健。实现上通常借助张量核心与自动混合精度(AMP)框架,并配合损失缩放等技巧。其收益取决于显卡是否支持相应低精度指令,老卡可能无法获得同等加速。
实测表现:吞吐翻倍,长上下文不再卡死
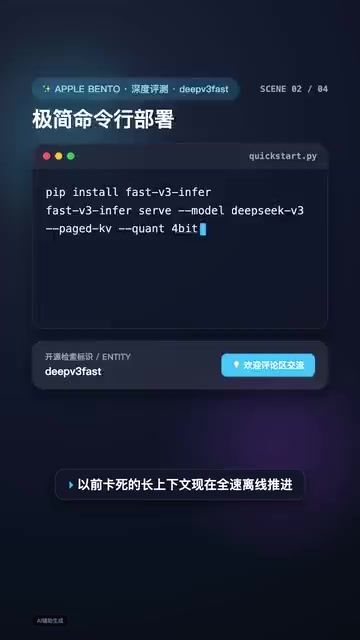
根据实测,在民用单卡上,离线推理速率翻倍暴增。尤其说个细节长上下文场景:以往受限于显存和碎片化开销,长上下文推理容易卡死或极慢,现在可以全速离线推进。这意味着用户可以在本地处理更长的文档、代码库或多轮对话,而不必依赖云端API。
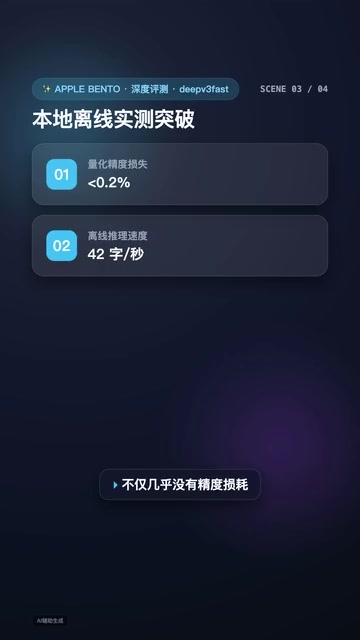
精度方面,UP主表示“几乎没有精度损耗”。这很关键——端侧推理的实用性不仅看速度,还要看输出质量是否可接受。如果优化导致精度明显下降,那么对于代码生成、逻辑推理等任务来说就得不偿失。目前来看,该方案在速度与精度之间取得了不错的平衡。
数据不出本地:隐私与成本的双重吸引力
另一个亮点是数据百分之百不出本地设备。对于涉及敏感信息的企业和个人用户,本地推理意味着无需将数据上传云端,规避了隐私泄露风险。同时,离线运行也省去了API调用费用,长期来看成本优势明显。
当然,本地推理的代价是需要自己维护硬件和软件环境。社区优化方案降低了硬件门槛,但部署和调优仍有一定技术门槛。不过,随着端侧自适应算子持续进化,这一门槛有望进一步降低。
社区优化的意义与局限
这次优化来自社区而非官方,反映出开源模型生态的活力。社区针对特定模型、特定硬件做深度调优,往往能挖掘出官方尚未覆盖的优化空间。动态显存分页和混合精度算子并非DeepSeek独有,但针对其架构做适配,需要深入理解模型计算图与显存访问模式。
需要理性看待的是,目前信息来自单一UP主分享,尚未看到更广泛的第三方复现或官方确认。吞吐“翻倍”的具体测试条件(显卡型号、上下文长度、批大小等)未详细披露,实际收益可能因场景而异。此外,端侧推理在绝对性能上仍无法与云端大规模集群相比,它更适合对隐私、成本敏感且负载可控的场景。
端侧自适应算子指针对特定模型结构与目标硬件,在编译或运行时自动选择算子实现、分块大小、精度策略与显存布局的优化方式。它不同于通用算子库,需要理解模型计算图(如注意力头的维度、KV Cache的访问模式)与硬件的显存层级、缓存容量和指令集特性。常见手段包括算子融合、KV Cache分页管理、按硬件能力回退精度等。这类优化通常与具体显卡型号和上下文长度强相关,换硬件或换模型版本后收益可能变化,因此复现时需明确测试条件。
本地显卡离平替云端还有多远?
端侧推理的进步有目共睹,但“完全平替云端服务”仍不现实。云端集群在吞吐、并发、模型规模上具有天然优势,且能持续升级硬件。本地消费级显卡受限于显存容量和算力,更适合中小规模模型或特定任务。不过,对于许多个人开发者和小团队而言,本地推理已经能覆盖相当一部分需求,尤其是当优化方案把吞吐提升两倍以上之后。
未来,随着端侧自适应算子持续进化,以及更多社区优化涌现,本地与云端的差距会进一步缩小。但两者更可能是互补关系:云端处理重负载、高并发任务,本地负责隐私敏感、低延迟、离线场景。对于手握“老显卡”的用户来说,这波优化无疑是个好消息——不必急着升级硬件,也能让现有设备发挥更大价值。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。