零基础转大模型开发:一套四阶段学习路线图
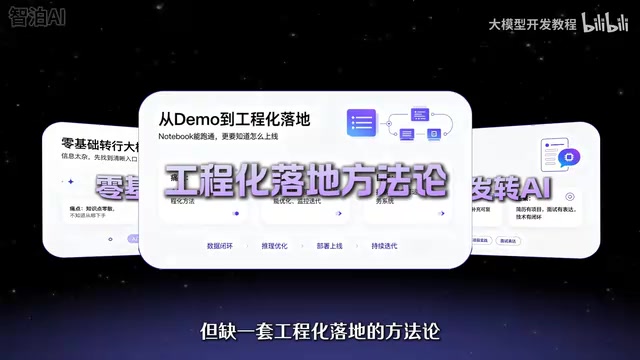
大模型开发转行四阶段路线图:从认知建立到工程落地与求职闭环。
文章介绍了一位B站开发者总结的大模型应用开发转行四阶段路线。第一阶段建立岗位认知地图,搞清能力边界与岗位需求;第二阶段打磨Prompt工程、RAG和Agent架构三块核心技能,并配套练手项目;第三阶段聚焦工程化落地,涵盖接口封装、流式输出、状态管理、评估体系与成本监控,这是Demo与上线系统的分水岭;第四阶段面向求职,将经历翻译成问题-方案-效果结构并准备高频面试题。作者指出该路线源自面试与带教经验,价值在于把学什么和为什么学绑定,但学习效果仍取决于练手项目的完成质量。
转行大模型开发,最大的坑不是数学或代码,而是信息碎片化。网上教程要么堆砌模型原理和数学推导,听完依旧写不出一个能用的应用;要么追逐趋势大词,落地细节一概欠奉。一位在B站发布系统性课程的开发者,基于自己面试求职和带新人的踩坑经验,整理出一条从零到工程化落地的四阶段路径。
先确认:这套路线适合谁
课程明确划定了三类目标人群,定位相当精准:
- 零基础想转行,但被网上杂乱信息淹没,不知道从哪下手;
- 传统开发两三年,想给简历加AI标签,但面试一问到RAG、Agent就卡壳;
- 会跑模型、调过Demo,却摸不透工程化落地的方法论,缺一套能跑通上线的体系。
作者的核心承诺不是“学完就会”,而是让你对这个岗位的认知从“好像很火”变成一张能照着走的路线图。这个定位比“七天从小白到大神”的口号务实得多。
第一阶段:认知建立,先搞清岗位边界
很多转行者一上来就啃论文,结果两周就放弃。作者的逻辑相反:先搭框架,知道岗位需要什么能力,再逐个填技能点。
第一阶段要解决的问题包括:大模型应用开发与传统后端开发的本质区别、模型的能力边界(什么能做、什么做不了)、Token与上下文窗口的作用、温度参数如何影响输出、API调用与计费逻辑,以及主流模型各自擅长什么。
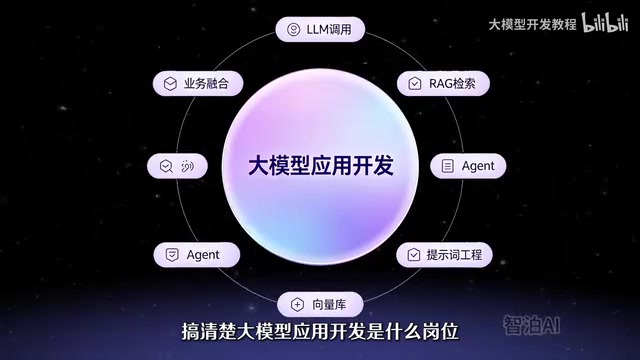
作者特别强调要逐条拆解岗位JD。原因很直接:搞不清这些,你写的系统就是空中楼阁,面试官一问就露怯。这一阶段的产出不是代码,而是对岗位的准确认知地图。
第二阶段:三块硬功夫,面试与干活的基本功
核心技能被拆成三块,每块都配一个练手项目:
Prompt工程——从会写到写得稳,覆盖角色设定、少样本示例、结构化输出。
RAG(检索增强生成)——从原理到落地,涉及Embedding、向量库、切分策略、召回调优,以及检索准确率上不去的排查思路。
Agent架构设计——多步任务如何编排、Function call和MCP如何接入、工具调用失败怎么兜底。
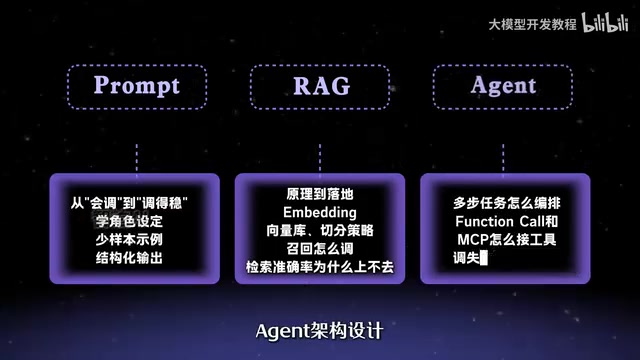
对应的练手项目是RAG文档问答和Agent自动化工作流。这三块是面试核心考点,也是日常干活的基本功,缺任何一块都难以独立承担应用开发任务。
RAG(检索增强生成) 是一种将外部知识检索与大模型生成相结合的技术范式。其核心流程是:先将文档切分并转化为向量存入向量库,用户提问时检索出最相关的片段,再将这些片段作为上下文喂给大模型生成答案。这样能缓解模型幻觉、突破训练数据时效性限制,并让回答有据可查。RAG 的难点不在跑通 Demo,而在检索准确率——切分粒度、Embedding 模型选择、召回策略都会影响最终效果。
Agent(智能体) 指能自主规划、调用工具、多步执行任务的大模型应用形态。与单轮问答不同,Agent 会拆解目标、选择工具(如搜索、计算、API)、观察结果并决定下一步。Function call 是模型调用外部函数的机制,MCP(Model Context Protocol)则是一种标准化协议,让模型以统一方式接入各类工具和数据源。Agent 的工程挑战在于工具调用失败的兜底、死循环的终止条件以及多步任务的编排可靠性。
第三阶段:工程落地,把Demo变成能上线的系统
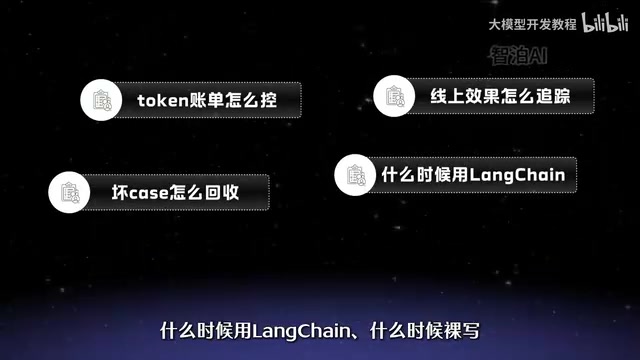
这是市面上课程普遍缺失的一环。Demo跑通和系统上线之间,隔着大量工程细节:用FastAPI封装接口、流式输出怎么做、会话状态怎么管、日志埋点怎么打、评估(Eval)体系怎么搭、测试用例如何覆盖模型“抽风”的场景、成本和Token账单怎么控、线上效果怎么追踪、坏case怎么回收。
还有一个高频纠结:什么时候用LangChain,什么时候裸写。作者把答案放在这一阶段。这些内容不性感,但决定了你交付的是玩具还是产品。
Eval(评估)体系 是大模型应用工程化中容易被忽视但至关重要的一环。传统软件测试靠断言判断对错,而大模型输出具有随机性,同一输入可能得到不同结果,因此需要建立一套量化评估机制:准备一批带标准答案或评分标准的测试集,用规则匹配、相似度计算或“模型评模型”的方式打分,在每次修改 Prompt、更换模型或调整检索策略后跑一遍,用数据判断改动是提升还是退步。没有 Eval,优化全靠感觉,线上质量无法保障。
LangChain 是一个大模型应用开发框架,封装了模型调用、Prompt 模板、检索链、Agent 等常用组件,能加快原型搭建。但它的抽象层较厚,出问题时排查链路长,且版本迭代快、API 不稳定。因此当逻辑简单或需要精细控制时,直接调用模型 SDK 裸写往往更清晰可控。选择框架还是裸写的判断标准通常是:流程复杂度、团队维护成本和对底层行为的可控性要求。
第四阶段:求职实战,把经历翻译成竞争力
最后一阶段面向落地结果:简历上每段经历要写清楚解决了什么问题、用了什么方案、效果数据是什么;面试高频题提前备好,比如RAG幻觉怎么治、Agent死循环怎么破、成本怎么降;作品集要部署上线,给面试官一个能点开的链接。
从准备到拿offer,形成闭环。
这套路线图的价值与局限
它的最大优点是把“学什么”和“为什么学”绑定在一起,每一步都清楚学完能干什么,避免转行者陷入原理细节无法自拔。四个阶段层层递进,从认知到技能到工程到求职,逻辑自洽。
需要提醒的是,这是一套课程大纲而非独立验证过的学习效果数据,“学完即就业”仍属宣传口径。真正的掌握程度取决于每个阶段的练手项目是否扎实完成,尤其是第三阶段的工程化训练——那才是区分“会调Demo”和“能干活”的分水岭。对零基础转行者来说,把这条路线当作导航图,比当作速成承诺更有价值。
相关推荐
ICLR 2027仍在发拒稿信,学术圈苦AI水文久矣
ICLR 2027持续对低质量投稿发出desk reject,Reddit社区对此表示支持。本文分析AI生成论文泛滥下学术会议的初筛压力、评价体系激励扭曲,以及研究者该如何应对。
Anthropic印度公司早于Claude?一个名字引发的趣闻
Reddit网友发现印度存在一家早于AI公司Anthropic的同名企业,引发对品牌命名与商标保护的讨论。本文梳理这一趣闻的来龙去脉与启示。
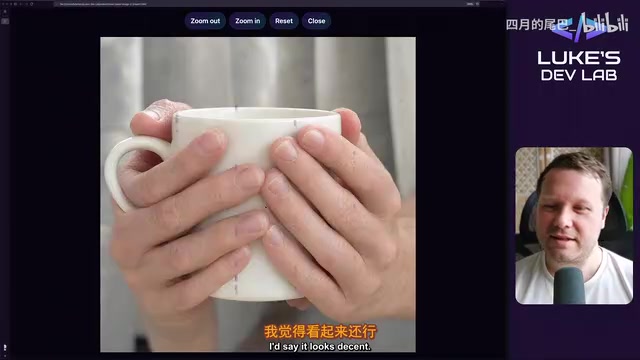
Qwen Image 2.1本地32项实测:数数翻车,动漫风格意外能打
B站UP主Luke的DevLab用RTX 5090本地实测Qwen Image 2.1共32项:拼写与空间布局可靠,苹果计数翻车,动漫风格优于写实人体,自行车轮辐条等几何结构明显短板,画面反复出现疑似训练数据残留的紫色印记。