零基础转行大模型开发:四阶段学习路线全拆解

拆解一套748集大模型系统课的四阶段路线图,提炼零基础转行的学习顺序与工程落地要点。
文章拆解了B站一套号称748集的大模型系统课程,重点不在内容清单,而在其学习路径的设计逻辑。课程面向三类人群:零基础转行者、想加AI标签的传统开发者、缺工程化方法论的demo玩家。路线分四阶段:先建立岗位认知与模型能力边界,再攻Prompt工程、RAG、Agent三项核心技能并配练手项目,接着解决从demo到上线的工程问题(接口封装、流式输出、成本监控、坏case回收、框架选型),最后落到简历重写与面试准备。文章指出其推进顺序与常见失败模式相反:应先搭应用框架再深入论文原理,并强调工程落地才是真实岗位的考察重点。
网上关于大模型的学习资料多到让人眼花,但真正零基础想转行的人往往卡在第一步:不知道从哪下手。B站上一套号称「全748集」的系统课试图回答这个问题,它的课程设计逻辑值得拆开看看——不是因为它讲得多全,而是因为它把「学什么」和「为什么学」之间的链条搭得比较清楚。
这套课到底面向谁
课程开篇就划定了三类目标人群:零基础想转行、但被碎片信息淹没的人;做了两三年传统开发、想给简历加上AI标签、却在面试中被RAG和Agent问住的人;以及能跑通模型demo、但缺一套工程化落地方法论的人。
这个定位本身透露了一个现实:大模型应用开发的门槛不在于「会不会调模型」,而在于能不能把模型能力组装成可交付的系统。市面上大量课程要么偏理论、讲完模型原理和数学推导仍然不会写应用,要么停留在趋势和大词层面、落地环节全部悬空。这套课选择卡在中间——模型认知够面试不露怯,工程能力够上手干活。
四阶段路线:从认知到求职
第一阶段:先把岗位认知立起来
第一步不是写代码,而是搞清楚大模型应用开发与传统后端开发的本质区别、模型的能力边界在哪里——什么能做、什么做不了。具体内容包括Token与上下文窗口的作用、温度参数如何影响输出、API调用与计费逻辑、主流模型各自擅长什么,以及逐条拆解岗位JD。
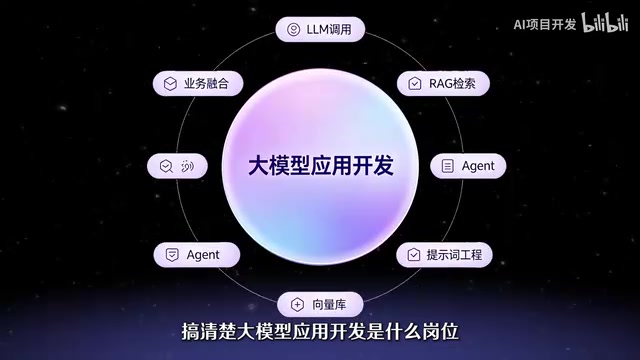
这一步看似务虚,实际决定了后面所有学习的方向感。岗位认知不清,写出来的系统就是空中楼阁,面试官一问就露馅。
Token 是大模型处理文本的基本单位,模型按 token 计费和限制输入长度;上下文窗口指模型单次能处理的最大 token 数,超出会被截断或报错。温度参数控制输出随机性,值越低输出越确定,值越高越发散。理解这些参数有助于判断模型在具体场景下的能力边界,也是面试中常被追问的基础点。
岗位 JD(Job Description)是招聘方对职位职责和任职要求的正式描述。逐条拆解 JD 能帮学习者识别市场真正需要的技能组合,而不是按个人兴趣盲目学习,这也是课程把它放在第一阶段的原因。
第二阶段:三项核心硬技能
这一阶段集中攻三块内容。Prompt工程从「会写」到「写得稳」,覆盖角色设定、少样本示例、结构化输出。RAG从原理到落地,涉及Embedding、向量库、切分策略,以及检索准确率上不去时怎么调。Agent架构设计则处理多步任务编排、Function Call与MCP的工具接入方式、工具调用失败后的兜底策略。
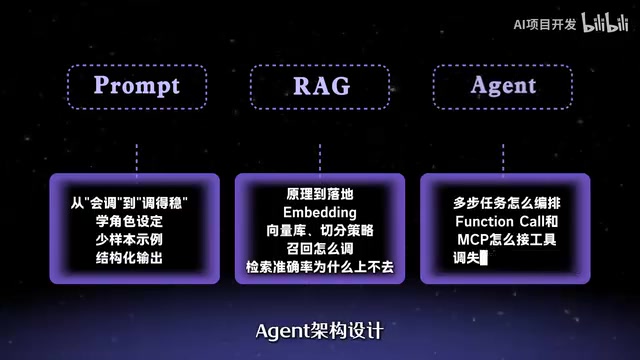
作者给每块技能都配了练手项目:RAG配文档问答,Agent配自动化工作流。这两项既是面试核心考点,也是日常干活的基本功,练手项目的作用是把知识点固化成可展示的产出。
Embedding 是把文本映射为高维向量的技术,语义相近的文本在向量空间中距离更近,RAG 的检索环节正是依赖这一性质。向量库(如 FAISS、Milvus、Chroma)负责存储和高效检索这些向量。切分策略指把长文档拆成适合检索和塞入上下文窗口的片段,切分粒度直接影响召回质量。
Function Call 是模型根据用户意图输出结构化参数、由外部程序执行实际函数调用的机制;MCP(Model Context Protocol)是 Anthropic 提出的开放协议,用于标准化模型与外部工具、数据源的连接方式,让工具接入不再依赖各框架的私有实现。
第三阶段:把Demo变成能上线的系统
这一阶段解决的是从「能跑」到「能交付」的落差:用FastAPI包接口、流式输出怎么做、会话状态怎么管、日志埋点怎么打、测试用例如何覆盖模型输出不稳定的场景、Token成本怎么控、线上效果怎么追踪、坏case怎么回收。课程还专门讨论了框架选型——什么时候用LangChain,什么时候裸写更合适。
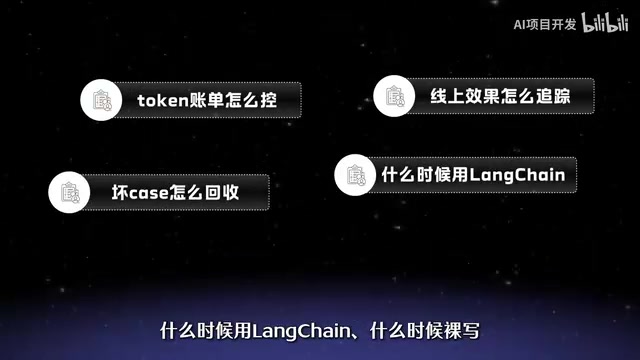
框架选型这个问题在实际项目中经常被低估。LangChain这类工具能加速原型搭建,但引入的抽象层在调试和定制时可能变成负担,理解「裸写」的适用场景是工程成熟度的标志之一。
流式输出(Streaming)指模型边生成边返回 token,前端逐字显示,能显著改善长回答场景的等待体验,但需要处理连接中断与增量拼接。会话状态管理指在多轮对话中维护历史上下文,常见方案包括服务端存储会话、按窗口截断历史以控制 token 消耗。日志埋点则是记录每次请求的输入、输出、耗时与 token 用量,是成本核算和坏 case 回收的数据基础。
第四阶段:求职实战
最后一阶段直接对准找工作:简历上每段经历按「解决了什么问题、用了什么方案、效果数据是什么」重写;高频面试题提前准备,包括RAG幻觉怎么治、Agent死循环怎么破、成本怎么降;作品集部署上线,给出一个能点开的链接。从准备到拿offer形成闭环。
学习路径设计的启示
这套课最值得借鉴的不是内容清单,而是它的推进顺序:先搭框架、知道岗位要什么能力,再逐个填技能点,每一步都清楚在学什么、为什么学、学完能干什么。
这个顺序恰好与很多人的直觉相反。常见的失败模式是上来就啃论文、背架构图,学了两周发现什么也没学会,然后放弃。论文和架构图不是不重要,但它们应该在有了应用框架之后再去深入,否则知识没有挂钩的地方,很快就会被遗忘。
另一个值得注意的点是课程对「工程落地」的权重。大量AI教程止步于demo,而真实岗位的考察点恰恰在demo之后:成本、监控、测试、坏case处理。这些内容不性感,但决定了你写的东西是玩具还是系统。
需要说明的是,这套课程的实际教学质量无法从大纲判断,748集的体量也意味着学习周期远不止标题所说的「一周」。但作为一份转行路线图,它的阶段划分和内容取舍提供了一个可以参考的框架——尤其是对那些在碎片信息里打转、需要一张全局地图的人来说。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
老派分类器仍胜Jev:嵌入+sklearn误差降37%
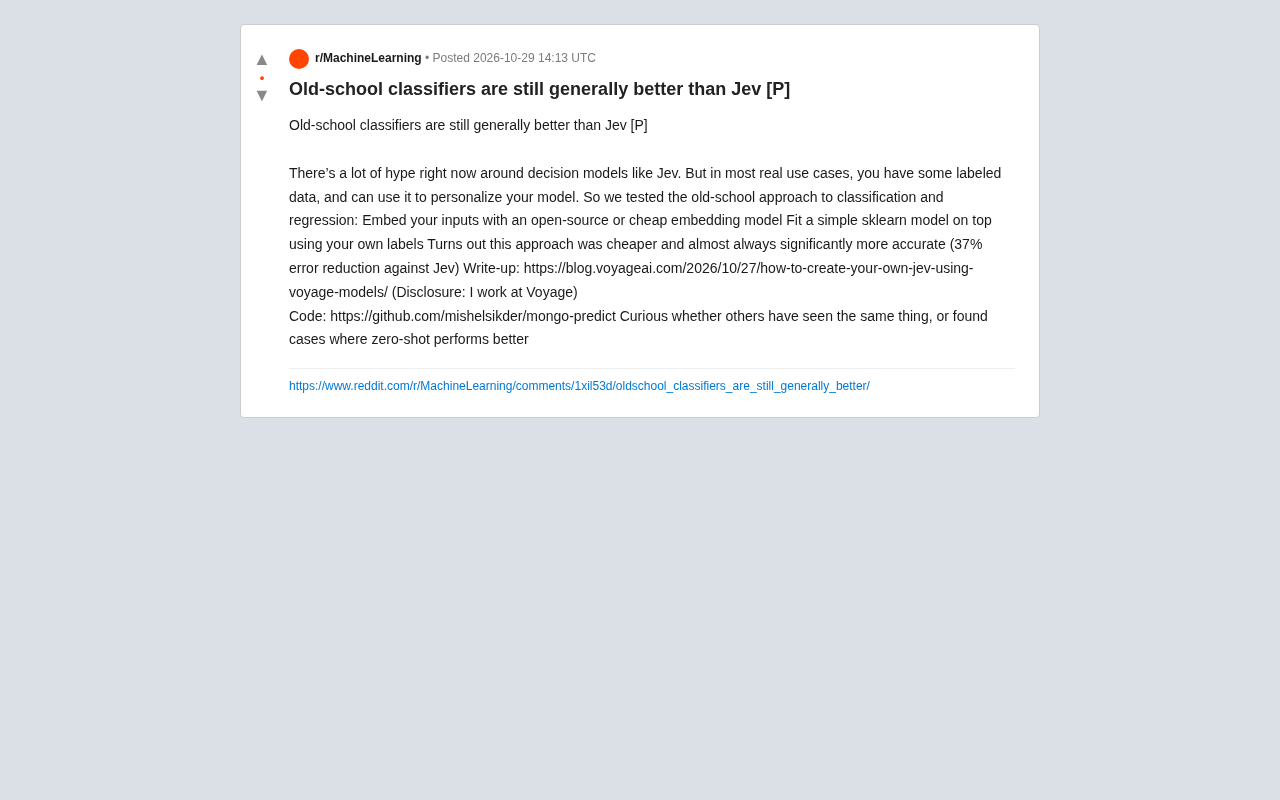
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。