零框架手写AI Agent:JavaScript实战指南
用纯 JavaScript 手写 40 行 Agent 循环,揭示 LLM+工具+循环+记忆的本质。
文章基于 YouTube 实操演示,用纯 JavaScript 从零实现一个可运行的 AI Agent,运行在本地 CPU 上的 Qwen 2.5 3B 模型。核心论点是 Agent 的本质为 LLM 加工具、循环与记忆,无需 LangChain 等框架。文章拆解了 Function Calling 的四步机制、三个真实工具(天气、计算器、记事本)的实现要点,以及约 40 行的 Agent 循环与错误处理、最大步数防护栏。实测展示了记忆、多工具并发和磁盘持久化,并讨论了何时该用框架。最终强调:模型只负责请求,代码负责决定。
为什么我们要亲手写一个 Agent?
市面上的 AI Agent 教程大多绕不开 LangChain 或 AutoGPT 这类框架。但根据 YouTube 技术频道的实测演示,剥开框架的外壳,一个 Agent 的核心不过是一个几十行的循环程序。本文基于该视频的完整实操路径,还原一个纯 JavaScript 实现的可运行 Agent——它能在本地 CPU 上调用真实天气 API、执行计算并读写磁盘文件。
这个实验的价值在于祛魅:Agent = LLM + 工具 + 循环 + 记忆。没有魔法,没有黑箱。
Agent 与聊天机器人的本质区别
聊天机器人只做一件事:输入文本,模型输出文本。它的知识边界止于训练数据截止日,无法查询今日天气,打不开本地文件,做算术题时还可能一本正经地给出错误答案。
Agent 在模型外面加了三层结构:
- 工具(Tools):一组普通函数,模型可以主动请求调用
- 循环(Loop):模型调用工具、读取结果、再决定下一步,形成"思考-行动-观察"的闭环
- 记忆(Memory):维护一个消息列表,让上下文在多次交互间延续
视频演示了一个直观对比:当问聊天机器人"东京现在多少度"时,它诚实地说自己没有实时数据;同一问题交给 Agent,它调用 OpenMeteo 接口返回了 16.7°C 的真实读数。模型没变,变的是外围结构。
模型选型:为什么用本地小模型
为了让演示"免费且诚实",视频作者选择通过 Ollama 在 CPU 上运行 Qwen 2.5 的 3B 参数版本。没有 API Key,零成本。
代价也很明确:3B 模型比云端大模型慢,而且更容易犯错。视频里就出现了一次真实失误——模型在拿到巴黎和柏林气温之前,就提前猜测了计算器的输入占位符,被工具的正则校验拦截。这个失误没有被隐藏,反而成了展示错误处理机制的最佳素材。
关键认知:Agent 代码与模型解耦。同一套逻辑,换成更大的模型只会更聪明,不需要改一行架构代码。
工具调用的四步机制
Function Calling(函数调用)是 Agent 的关节,它的流程可以拆成四步:
- 描述工具:每个工具包含名称、描述和参数的 JSON Schema
- 模型请求:需要工具时,模型不输出文本,而是返回
tool_calls字段,比如get_weather加参数city=Tokyo - 代码执行:你的程序查找对应函数并真正运行它
- 结果回传:把返回值以
role: tool的消息发回,模型据此生成最终回答
这里有一条铁律:模型从不执行任何代码,它只会请求。真正做什么,由你的程序决定。 这个边界是安全设计的基础。
JSON Schema 是描述 JSON 数据结构的标准格式,在 Function Calling 中用来告诉模型每个工具接受哪些参数、类型是什么、是否必填。例如 get_weather 的 Schema 会声明 city 为字符串且必填。模型据此生成符合格式的 tool_calls,你的代码也能在解析前做校验。它相当于工具与模型之间的“接口契约”,写得好坏直接影响模型能否正确调用。
tool_calls 字段 是模型响应中的结构化输出,与普通文本内容互斥。当模型决定调用工具时,message.content 为空,message.tool_calls 是一个数组,每项包含 id、function.name 和 function.arguments(JSON 字符串)。你的程序需要解析 arguments、执行对应函数,并将结果以 role: tool、tool_call_id 匹配的消息回传,模型才能继续推理。
三个真实工具的实现要点
天气工具:OpenMeteo 的两段式调用
OpenMeteo 免费且无需 API Key,但它的预报接口只认经纬度,不认城市名。所以 get_weather 内部要先调地理编码接口把"Tokyo"转成坐标,再调预报接口取 temperature_2m 和 wind_speed_10m——这两个是 OpenMeteo 对"地面 2 米气温"和"10 米风速"的字段命名。城市查不到时抛出明确错误,避免返回编造的温度。
计算器工具:先校验,再求值
LLM 的算术能力不可靠,所以把计算交给真实代码。但这里有个陷阱:你即将 eval 一个来自模型的字符串。安全做法是先用正则限制字符集——只允许数字、空格、小数点、括号和四则运算符,其余一律拒绝,通过后才执行求值。
eval 的安全风险在于它会执行任意 JavaScript 代码,而模型生成的字符串不可信。攻击者可通过提示注入让模型输出 process.exit() 或文件操作代码。正则白名单校验(仅允许数字、运算符、括号、小数点、空格)能拦截绝大多数恶意载荷,但更稳妥的做法是使用专门的表达式解析库(如 mathjs)或手写递归下降解析器,彻底避免执行任意代码。视频演示的白名单方案适合教学,生产环境应升级。
记事本工具:让 Agent 产生真实副作用
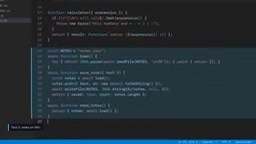
笔记存储在 notes.json 文件中。loadNotes 读取文件,不存在则返回空列表;saveNote 追加带时间戳的条目并写回;readNotes 返回全部内容。视频结尾展示了磁盘上真实存在的文件——Agent 改变了聊天窗口之外的世界。
Agent 循环:四十行代码的核心
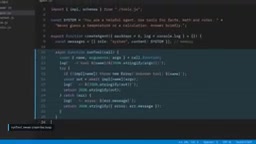
循环逻辑藏在 agent.js 的 ask 函数里。每次提问,用户消息被推入记忆数组,然后进入最多 maxSteps 轮的迭代(默认 6 步):
- 带完整历史记录和工具 Schema 调用模型
- 如果回复中没有
tool_calls,说明模型认为可以收尾,直接返回答案——这是第一个停止条件 - 如果有
tool_calls,逐个执行工具,把结果以 tool 消息推回记忆,进入下一轮 - 步数耗尽仍未收敛,返回"已停止,达到最大步数"的明确提示——这是第二个停止条件
第二个停止条件至关重要。缺少它,一个困惑的模型可能无限循环,在付费模型场景下直接转化为账单。
错误处理:让失败变成模型的输入
runTool 用 try/catch 包裹执行过程。工具名不存在、城市查不到、表达式非法、网络故障——任何异常都不会让程序崩溃,而是带着 error 字段作为普通结果回传给模型。模型读到错误原因后,可以换个思路重试,或者向用户解释问题。视频中那个不存在的城市案例验证了这条路径:模型最终如实告知用户"找不到该城市,请检查拼写",而不是编造一个温度。
maxSteps 防护栏 是 Agent 循环的硬性终止条件,防止模型陷入“请求工具→结果不理想→再请求”的死循环。每次循环消耗一次模型调用,若使用按 token 计费的 API,无限循环会迅速累积成本。默认 6 步是经验值:多数任务 2-3 步内收敛,复杂任务可能需要更多。实践中可根据任务复杂度动态调整,并在达到上限时返回明确提示,而非静默失败。
实测:记忆、副作用与防护栏
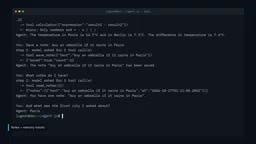
一场五问的连续对话展示了 Agent 的完整能力面:
- 计算:"18.5×4+12" 调用计算器得 86,正确
- 多工具并发:巴黎和柏林的气温差,模型一次性请求三个工具(巴黎、柏林、计算器),但计算器接收到的却是提前猜测的占位符,被正则拦截。模型转而自行完成减法得出 7.4,答案虽对,但绕过了工具——小模型的典型行为
- 记忆:"我最早问的是哪个城市?"没有触发任何工具,模型直接翻阅消息列表答出"巴黎"
- 持久化:笔记真实写入磁盘,附带时间戳
什么时候该用框架?
纯代码方案适合学习、小型工具和需要完全控制的场景。但当你需要流式输出、自动重试、多模型供应商切换、多 Agent 协作、长时状态管理或追踪评估时,框架的价值开始显现。JavaScript 生态中的常见选择包括 LangGraph.js、Vercel AI SDK 和 OpenAI Agents SDK。
不过无论选哪个,你现在都知道它底下在做什么:一个模型、几个工具、一个循环、一份消息列表。
继续深入的路径
视频给出了几条延伸建议:写一个自己的工具(汇率查询、搜索 API、私有数据库);打磨系统提示词和工具描述,观察模型选择如何变化;换更大的模型做对比;以及——始终记录每一步日志,看清楚 Agent 为什么做了那个决定。
最后那条规则值得重复:模型负责请求,代码负责决定。
相关推荐
腾讯喵影Agent实测:一张画布搞定AI视频全流程
B站UP主实测腾讯喵影Agent:输入一个想法,Agent自动生成故事卡、角色卡、分镜卡并批量生成视频,画布内完成剪辑导出,全流程不切换软件。
WorkBuddy零基础入门:桌面Agent如何把AI变成执行者
WorkBuddy零基础教程:解析这款桌面AI Agent如何操作本地文件完成办公任务,对比Codex的适用场景与学习成本,并梳理三个常见认知误区与积分省钱技巧。
Harness工程:同一模型得分翻三倍的秘密
Harness工程是AI代理开发的核心:同一模型因外围代码不同得分从13.3%升至38.3%。本文拆解harness的七个组件——循环、动作、上下文、记忆、权限、验证与可观测性,并给出以退款代理为例的实战方法与改进路径。