Llama.cpp本地运行大模型:GGUF转换与量化实战

从源码编译到量化推理,完整跑通 Llama.cpp 本地大模型部署全流程。
文章以科技 UP 主 Chung 的实操演示为基础,系统梳理了 Llama.cpp 的本地部署全流程。首先介绍 Llama.cpp 的定位:由 Georgi Gerganov 用 C++ 实现,轻量且硬件适配性极强,是 Ollama、Llama Studio 等上层工具的技术底座。接着对比四种部署方式,推荐源码编译以获得最强参数可控性,并说明 Mac 默认启用 Metal、可用 -j 参数并行加速。随后讲解如何用 convert_huggingface_to_gguf.py 将 safetensors 模型转为 GGUF 格式,以及 llama-cli 的关键参数(temperature、Top-K/Top-P、GPU 层数)调优方法。最后介绍 llama-quantize 的量化压缩能力与 iPhone 本地运行成果,并对比 Llama.cpp 与 Ollama 的取舍。
Llama.cpp 是大语言模型本地部署领域的"鼻祖级"框架,凭借 C++ 实现带来的轻量化和极高硬件适配性,成为无数本地推理工具的技术底座。本文基于科技 UP 主 Chung 的实操演示,完整梳理从源码编译、模型格式转换到量化与对话推理的全流程,帮助你在自己的机器上跑通第一个本地大模型。
Llama.cpp 是什么,为什么值得关注
Llama.cpp 由 Meta 工程师 Georgi Gerganov 创建,名字来源于两个事实:一是项目最初面向与 Meta Llama 相似的模型架构,二是核心用 C++ 实现。正是 C++ 带来的轻量特性,让它在 Mac、Windows、Linux 乃至手机等不同硬件上都能编译运行。
更关键的是生态位置——知名的 Ollama 和 Llama Studio 都构建在 Llama.cpp 之上。换句话说,学会 Llama.cpp,等于掌握了这些上层工具的能力边界与调参逻辑。它的定位类似"瑞士军刀":从模型格式转换、量化压缩到 HTTP API 服务,一个工具链全部覆盖。
四种部署方式与编译实操
部署 Llama.cpp 有四条路径:直接下载源码本地 build、通过 Homebrew 等包管理器安装(Mac/Linux)、使用 Docker 镜像、或下载预编译二进制包。UP 主推荐第一种,因为参数可控性最强。
编译流程并不复杂:先 git clone 代码,再创建 Python 虚拟环境并安装 requirements.txt 中的依赖,最后执行编译。Mac 上编译默认启用 Metal 后端,推理时可直接调用 GPU;Windows/Linux 用户则可通过参数开启 CUDA 或 Vulkan 支持。想加快编译速度,可以在 make 命令后追加 -j8 或 -j32 进行并行编译。
编译完成后会生成几个核心可执行文件:llama-cli 用于运行模型对话,llama-quantize 用于模型量化,llama-server 用于启动 HTTP 服务供 API 调用。后续所有操作都围绕这几个命令展开。
从 safetensors 到 GGUF:格式转换全流程
Hugging Face 上的模型大多以 safetensors 格式存储,这种格式能有效防止参数被篡改,但 Llama.cpp 需要的是 GGUF 格式。转换工具就是代码库中的 convert_huggingface_to_gguf.py。
以 Gemma 2 2B 为例,执行转换命令时需指定模型文件夹路径和输出精度(如 f16)。实测转换耗时不到一分钟,输出文件约 5.2GB,与原始 safetensors 的 4.9GB 基本一致——因为 f16 精度保持了原始参数精度,文件体积自然接近。
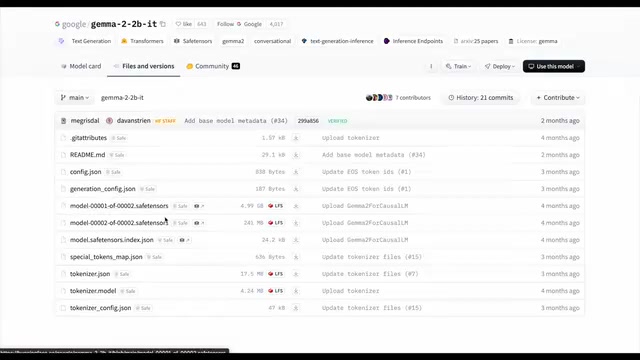
这一步的意义在于:GGUF 是 Llama.cpp 生态的"通用货币",转换完成后即可进入量化或直接推理环节。
GGUF(GPT-Generated Unified Format)是 llama.cpp 生态中定义的模型文件格式,取代了早期版本使用的 GGML 格式。它的核心设计目标是为推理引擎提供自描述、可扩展、单文件的模型封装:文件头包含元信息(架构类型、超参数、分词器配置、张量清单等),其后是按对齐规则排列的张量数据。相比 safetensors 的纯权重存储,GGUF 把推理所需的全部配置内嵌其中,因此 llama.cpp 加载时无需额外的 config.json 或 tokenizer 文件。GGUF 还支持多种量化类型(如 Q4_K_M、Q5_K_M、Q8_0),同一格式可承载不同精度,这也是它被称为生态“通用货币”的原因。
safetensors 则是 Hugging Face 推出的权重存储格式,其本质是一个简单的二进制容器:开头是 JSON 头描述每个张量的数据类型、形状和字节偏移,后面紧接原始张量数据。与 pickle 相比,它不执行任何代码,因此避免了恶意模型文件带来的反序列化风险,同时支持零拷贝内存映射,加载速度更快。但 safetensors 只负责存权重,模型结构、分词器、生成配置等仍需配套文件,所以 llama.cpp 必须先通过转换脚本把这些信息合并进 GGUF。
参数调优与本地对话推理
用 llama-cli 加载模型时,Llama.cpp 的参数丰富程度远超多数同类框架——从性能参数到模型超参数均可精细调节,这正是它适合深度调优的原因。
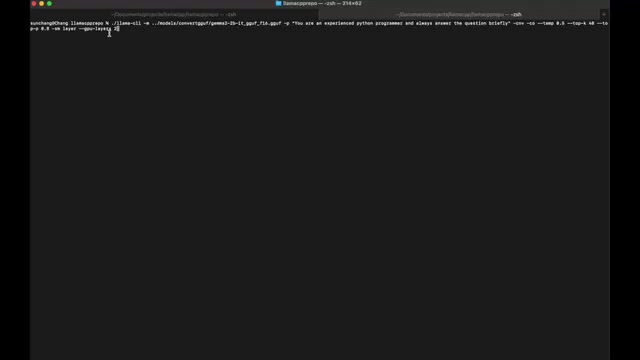
几个关键参数值得注意:-m 指定模型路径(必填);--prompt 设定模型身份;-cnv 启用对话模式,否则默认进入 completion 补全模式;--temp 控制 temperature(UP 主设为 0.5,默认 0.8);Top-K 与 Top-P 分别设为 40 和 0.8。性能层面,--split-mode 决定模型是否跨 GPU 分布,--n-gpu-layers 指定放入显存的层数——演示中 27 层的模型仅放了 2 层到 GPU,用户可根据显存容量自行调整以最大化效率。
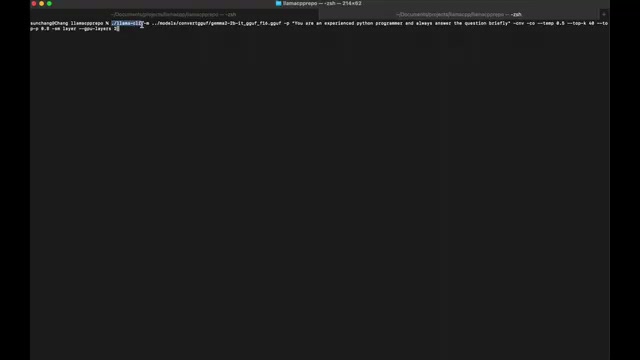
实测中,模型载入迅速,输入 prompt 后不到一秒即开始输出,生成一段完整游戏代码加详细说明耗时不到 30 秒。对话结束后按 Ctrl+C 会输出采样耗时、每秒 token 数等性能指标,方便横向对比不同工具。
Temperature、Top-K 与 Top-P 是控制文本生成随机性的三个核心采样参数,理解它们的协同关系有助于调出符合预期的输出风格。Temperature 对 logits 做缩放后再经 softmax:值越低(如 0.2)分布越尖锐,模型倾向于选择高概率词,输出稳定但可能重复;值越高(如 1.2)分布越平坦,多样性增加但容易跑题。Top-K 将候选词限制为概率最高的 K 个,直接截断长尾;K 越小越保守。Top-P(核采样)则动态选取累积概率达到 P 的最小词集合,比固定 K 更能适应不同分布的上下文。三者通常配合使用:先按 Top-K/Top-P 圈定候选范围,再由 temperature 调节最终采样。实践中常见组合是 temperature 0.70.8、Top-K 40、Top-P 0.90.95;代码生成等确定性任务可适当调低 temperature。
--n-gpu-layers 背后的机制是层卸载(layer offloading):Transformer 模型由数十个结构相同的层堆叠而成,llama.cpp 可以把其中一部分层的计算和权重放到 GPU 显存中,剩余层留在 CPU 内存由 CPU 计算。由于每层权重体积固定,放入的层数越多,显存占用越高,但 GPU 并行计算的比例也越大,每秒 token 数随之提升。当显存不足以容纳指定层数时,程序会报错或回退到 CPU,因此需要从少量层开始逐步增加,找到显存接近占满且不溢出的临界点。--split-mode 则决定多 GPU 场景下模型如何切分,单卡用户一般无需关心。
量化与移动端:Llama.cpp 的差异化价值
llama-quantize 工具可将 f16 模型进一步压缩为 4-bit、5-bit 等低精度版本,大幅降低内存占用,这是本地部署大模型的关键一环——尤其在显存有限的设备上。
UP 主还透露了一个更有意思的成果:成功用 Llama.cpp 在 iPhone 上本地运行大语言模型。这印证了 C++ 实现的跨平台优势,也说明本地 AI 的门槛正在从"有一台好电脑"降到"有一部手机"。对隐私敏感或离线场景而言,这类能力的实用价值会持续上升。
对于习惯 Ollama 的用户,UP 主的主观对比是:Llama.cpp 的响应速度和输出质量可能略优,且可调参数的数量与细致程度明显更胜一筹。当然,Ollama 的易用性仍是其优势——两者本质是同源工具在不同抽象层上的取舍。
量化是把模型权重从高精度浮点(如 f16,每参数 2 字节)转换为低精度表示(如 4-bit,每参数约 0.5 字节)的过程,目标是在尽量保留模型能力的前提下压缩体积、降低内存带宽需求。llama.cpp 的 llama-quantize 实现的是一种分块量化方案:将权重按小组(如 32 或 256 个元素)划分,每组共享一个缩放因子,组内用低位整数近似表示,从而在精度和压缩率之间取得平衡。命名中的 K 系列(如 Q4_K_M、Q5_K_M)表示采用了 k-quants 的混合量化策略——对不同张量(如注意力层与 FFN 层)分配不同位宽,M 代表 medium 档位。经验上 Q4_K_M 在体积减半以上的同时能保留大部分原始性能,是本地部署最常用的折中选项;Q8_0 接近无损但压缩有限。量化后的模型可直接被 llama-cli 加载,无需再转换。
常见问题
Q:Mac 上需要额外配置 GPU 加速吗? A:不需要,编译时默认启用 Metal 后端。
Q:f16 转换后文件为什么比原模型大? A:属正常现象,两者精度一致,体积差异来自格式封装开销,5.2GB 对 4.9GB 在合理范围内。
Q:如何判断该放多少层到 GPU? A:从少量层开始测试,逐步增加直至显存接近占满,观察每秒 token 数是否提升,找到本机最优值。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。