llama.cpp新增MoE专家GPU缓存:显存不足者的提速利器

llama.cpp新增MoE专家GPU缓存机制,专为显存不足用户加速本地大模型推理。
llama.cpp 的 PR #29887 针对显存受限用户提出了一项关键优化:为存放在系统内存(RAM)中的 MoE 模型专家权重在 GPU 侧建立缓存层。MoE 架构模型(如 DeepSeek、Mixtral)总参数规模庞大,普通消费级显卡无法完整加载,只能依赖 CPU offload,而 PCIe 总线带宽远低于显存带宽,频繁的数据搬运成为性能瓶颈。该优化利用 MoE 推理中专家激活的局部性特征,将近期常用的专家权重缓存在 GPU 显存中,减少 PCIe 传输次数,从而提升推理速度。目前该功能仍处于 PR 阶段,实际加速效果因硬件配置不同而存在差异,有待社区广泛测试验证。
一个针对「GPU Poor」用户的关键优化
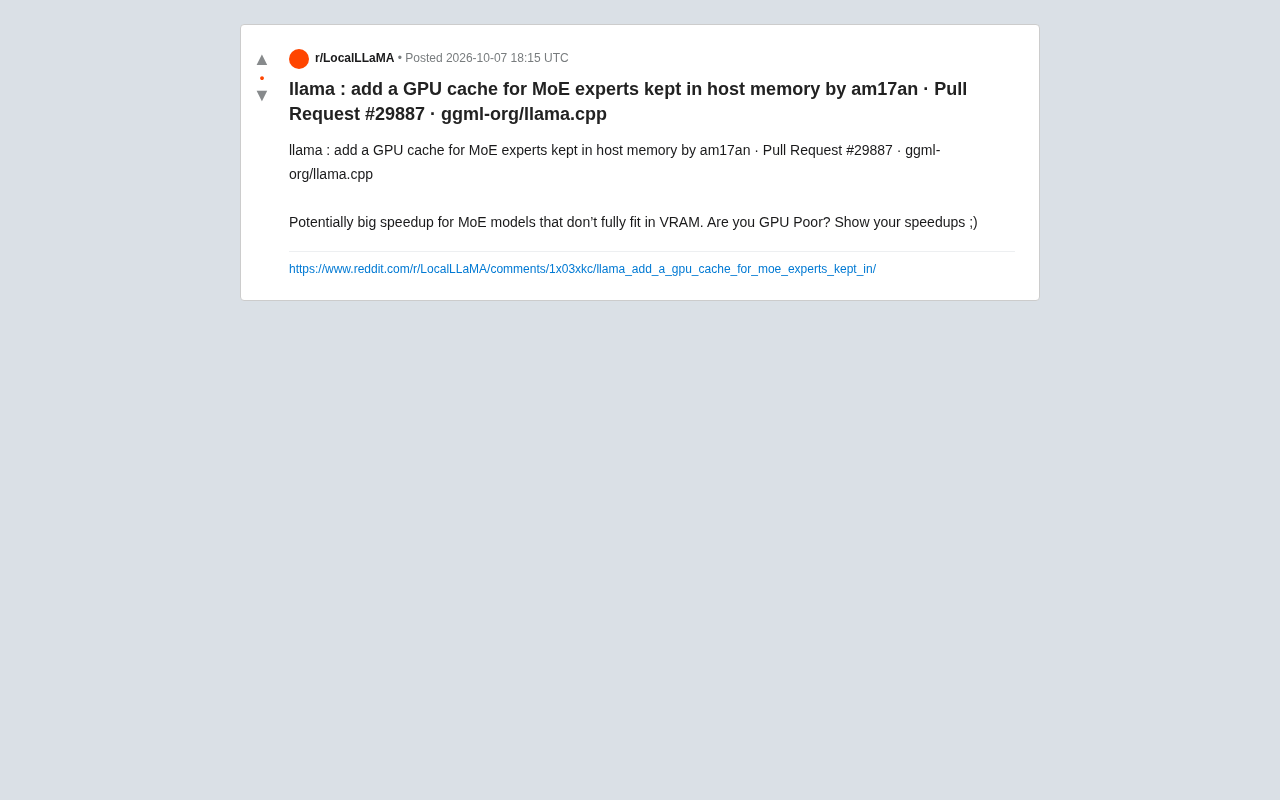
llama.cpp 近日收到一个值得关注的 Pull Request(#29887),由贡献者 am17an 提交,核心目标是为那些无法完全装入显存(VRAM)的 MoE(混合专家)模型提供显著的推理加速。这项改动在 Reddit 社区引发了讨论,作者甚至半开玩笑地发问:「你是 GPU Poor 吗?来晒晒你的提速效果吧。」
对于大量使用消费级显卡运行本地大模型的用户来说,显存始终是最硬的瓶颈。尤其是近年来兴起的 MoE 架构模型(如 Mixtral、Qwen MoE、DeepSeek广告 等),虽然激活参数量相对可控,但总参数规模庞大,往往无法一次性全部加载到有限的 VRAM 中。这正是本次改动试图解决的场景。
为 host memory 中的专家权重建立 GPU 缓存
从 PR 标题「add a GPU cache for MoE experts kept in host memory」可以清晰看出其技术思路:为存放在主机内存(host memory,即系统 RAM)中的 MoE 专家权重,在 GPU 侧建立一层缓存机制。
MoE 推理的特殊性
MoE 模型的运行机制与传统稠密模型不同。在每次前向推理时,路由器(router)只会激活一小部分专家(experts)参与计算,而非全部。这意味着在任一时刻,真正需要的专家权重其实只占总量的一小部分。
传统的做法通常是将一部分层或权重卸载(offload)到系统内存,推理时再通过 PCIe 总线在 CPU 和 GPU 之间来回搬运数据。由于 PCIe 带宽远低于显存带宽,这种频繁的数据传输会成为明显的性能瓶颈。
MoE(Mixture of Experts,混合专家)架构的核心思想是将模型的前馈网络(FFN)层替换为多个并行的「专家」子网络,每次推理由一个轻量级路由器(Router/Gating Network)动态选择其中 Top-K 个专家参与计算。以 DeepSeek-V3 为例,它拥有 256 个专家但每次只激活其中 8 个,这使得实际激活的参数量仅为总参数量的一小部分。这种设计在保持模型整体容量的同时大幅降低了单次推理的计算量,但代价是总参数规模极大——DeepSeek-V3 总参数达 685B,即便以 Q4 量化后体积仍超过 400GB,远超任何消费级显卡的显存容量。这种「计算稀疏、存储密集」的特性,使得 MoE 模型在内存受限场景下尤为依赖高效的权重调度策略。
缓存思路的价值
在 GPU 上维护一个专家权重缓存,能够利用 MoE 推理中专家激活的**局部性(locality)**特征——某些专家可能在连续的推理步骤中被反复调用。一旦命中缓存,就无需再次从主机内存通过 PCIe 搬运数据,从而减少传输开销、提升整体吞吐。对于部分权重常驻内存的混合部署场景,这种优化的收益可能相当可观。
专家激活的局部性(locality)并非假设,而是有实证支撑的现象。研究表明,在处理相似语义内容或连续对话时,模型倾向于反复激活同一批专家,这与 CPU 缓存设计中利用时间局部性的原理一脉相承。GPU 缓存的实现通常采用类似 LRU(最近最少使用)的替换策略:将有限的显存划分出一部分作为专家权重缓冲区,优先保留近期被频繁调用的专家权重。PCIe 4.0 x16 的理论带宽约为 32GB/s,而现代 GPU 的显存带宽可达数百 GB/s 乃至超过 1TB/s,两者相差一到两个数量级——这正是缓存命中率每提升一个百分点都能带来可观性能收益的根本原因。
谁会从中受益?
这项改动的目标用户非常明确,就是作者口中的「GPU Poor」群体:
- 使用单张消费级显卡(如 8GB、12GB、16GB 显存)运行大型 MoE 模型的个人用户;
- 模型规模超出显存容量,不得不依赖 CPU offload 的部署场景;
- 追求本地部署但硬件预算有限的开发者和爱好者。
对于能够将模型完整放入显存的用户,这项优化的意义相对有限——因为瓶颈本就不在数据搬运上。但对于绝大多数依赖混合内存部署的玩家而言,专家缓存可能带来直接的生成速度提升。
社区实测与开源协作的典型样本
值得关注的是,作者在发布 PR 时主动邀请社区成员提交各自的实测提速数据。这是 llama.cpp 这类活跃开源项目的典型协作模式:功能由贡献者实现,而真实硬件上的性能验证则交由庞大的社区在各种配置下完成。
由于 MoE 模型的加速效果高度依赖具体的模型结构、专家数量、显存大小以及 PCIe 带宽,不同用户的实际收益会存在差异。因此,在该功能正式合并进主线之前,社区的多样化测试反馈对于评估其普适性和稳定性至关重要。
llama.cpp 是由 Georgi Gerganov 发起的开源项目,以纯 C/C++ 实现大语言模型推理,最初以在 MacBook 上运行 LLaMA 模型而广为人知。其核心设计目标是最大化跨平台兼容性与资源效率,支持 CPU、CUDA、Metal、Vulkan 等多种后端,并内置 GGUF 格式的多级量化支持。正因为其极低的运行门槛,llama.cpp 积累了庞大且活跃的社区用户群,覆盖从树莓派到高端工作站的各类硬件。这种用户多样性使得社区测试能够覆盖开发者难以独立复现的硬件组合,也让类似本次 PR 这样依赖真实硬件反馈的功能验证成为可能。
小结
llama.cpp 的这项 MoE 专家 GPU 缓存改动,瞄准的是本地大模型推理中一个长期存在的痛点——显存不足导致的性能损失。通过在 GPU 侧缓存常驻主机内存的专家权重,它有望让受限于硬件的用户以更快的速度运行原本「跑不动」的 MoE 模型。
需要说明的是,目前该改动仍处于 Pull Request 阶段,具体的加速幅度和稳定性仍有待社区在真实环境中进一步验证。对于关注本地部署和推理效率的用户,这是一个值得持续跟踪的进展。
相关推荐

MCP 服务器是什么?让 AI 安全调用工具的标准接口
MCP(模型上下文协议)是什么?它像 USB 接口一样为 AI 提供统一、安全的工具调用标准,解决多模型集成中代码臃肿、数据泄露和 token 浪费问题。本文用电商案例讲清 MCP 服务器的核心价值。

为什么AI编程智能体不该自己测试代码?
新研究显示,阻止AI编程智能体(如Devin、Cursor、Factory)自己写测试反而能提升成功率、提速6%、降本9%。原因在于建造者不能同时当检查者。本文解析为何需要独立的测试智能体来验证真实应用。
n8n + Gemini 打造 Gmail 智能分类自动化工作流
本文介绍如何用开源自动化工具 n8n 结合 Google Gemini AI 搭建 Gmail 智能分类工作流,自动提取邮件信息、生成摘要并按类别和优先级写入 Google 表格,告别手动逐封阅读邮件。