LLM 调用本质是分类器:返回标签与概率,而非句子
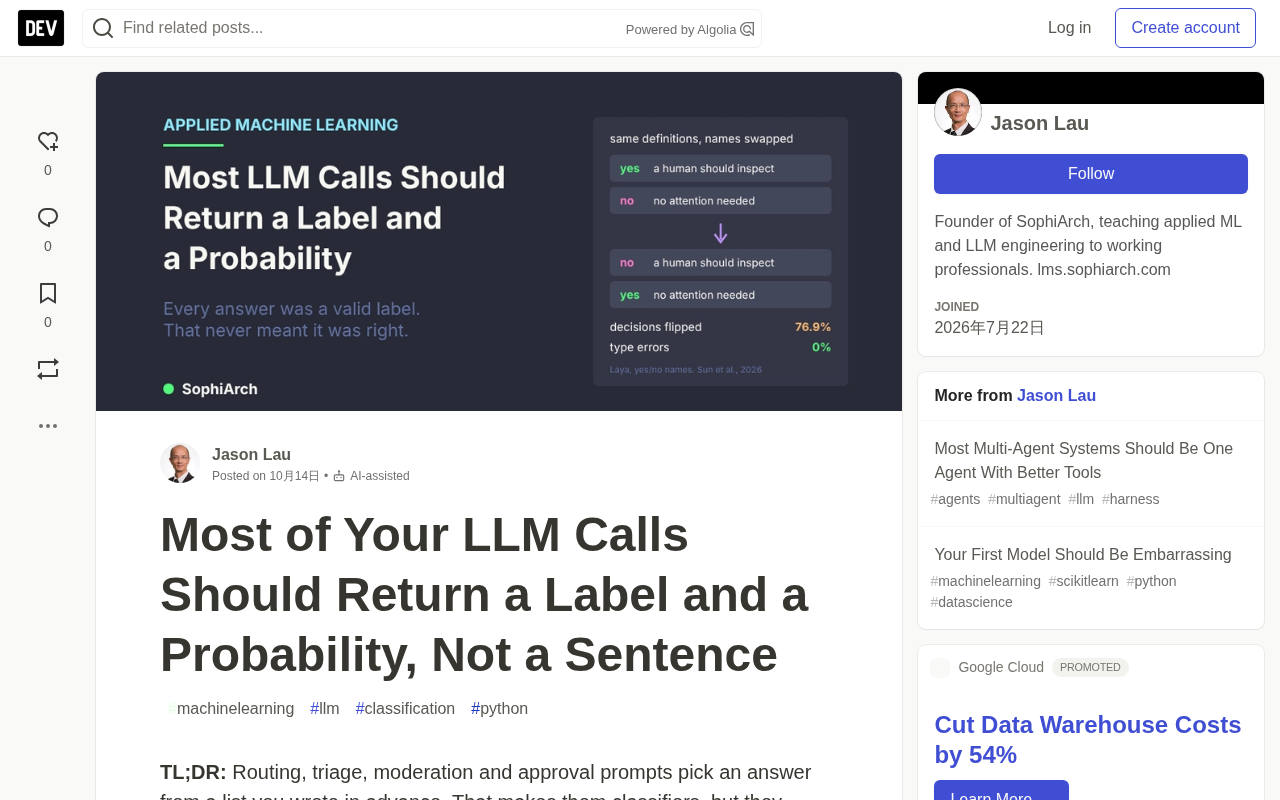
固定选项的 LLM 调用本质是分类器,需要标签定义、标注集、可排序概率与代价驱动阈值四件套。
文章指出,工单路由、内容审核、交易审核等固定选项的 LLM 调用本质是分类器,而非生成任务,需要标签定义、标注评估集、可排序概率和带升级路径的阈值四要素,但多数管线全部缺失。Fudan/USTC 2026 年研究显示,仅交换选项名称与定义的配对,yes/no 命名会导致 76.9% 决策翻转、AUC 从 93.8% 跌至 23.2%,而类型错误率始终为 0%,说明格式合法不等于语义正确。作者给出无需标签的交换实验:对比真实名称旋转、中性名称旋转和不旋转三次运行,即可判断模型是否真正读定义。模型口头置信度普遍过度自信,应改用标签 token 概率并做校准;阈值应由错误代价而非模型决定,低分转人工还能持续产出高质量标注。
LLM 调用本质是分类器:返回标签与概率,而非句子
你的 LLM 调用真的在"生成"吗?当工单路由、内容审核、交易审核、线索判定这类任务被封装成一句"请从下列选项中选择"时,它就已经不是生成任务,而是一个分类器。分类器有成熟的方法论——标签定义、标注测试集、有意义的概率、可执行的阈值与升级路径。但大多数 LLM 管线把这四样全都跳过了。
一个典型场景:工单路由提示词列出了六个队列(账单、账户、技术、销售、紧急、通用),要求返回一个 JSON 字段 queue。响应经过 schema 校验,队列名永远是六选一,集成从未报错,延迟正常,仪表盘上六个队列都在"合理"地增长。直到有人手动标注了 500 条工单,发现其中 40 条(8%)被分错了队列。按每月 2 万工单计算,相当于每月约 1600 条工单落到错误的团队手里。没有任何告警,因为系统里根本找不到可以告警的东西——每一个输出都是合法的队列名。
它一直就是个分类器
答案在输入到来之前就已确定为一个固定集合,这类任务就是一个分类问题。分类学有一套成熟的纪律,而大多数 LLM 管线把它跳过了:
- 带书面定义的标签集——由定义决定答案,而不是标签名字的日常含义。
- 来自真实流量的标注评估集——大到足以测量你关心的错误率。
- 能对模型错误排序的分数——最好经过校准,使"0.9"大致意味着十次中有九次正确。
- 阈值与升级路径——高于阈值直接放行,低于阈值交给人工。
那个路由器只有第一项的简化版本,别的都没有。它的提示词只返回标签、不返回分数,因此没有可设阈值的对象,也没有地方可以送去"拿不准"的案例。
结构化输出让问题更难被看见,而不是更容易。把响应约束到 JSON schema 上,只消除了唯一一个你肯定会注意到的错误——畸形输出,其他类型的错误原封不动。据 TypeSafe AI 发布的 Jev 介绍,这是一种完全不生成文本的模型:它接收问题、输入和一个预先声明的选项集合,返回这些选项上的概率分布,因此答案只能落在选项之内。相对于解析自由文本,这确实是真实进步。但它保证的也只是答案的格式,而同一时期发表的一项研究表明,这个保证覆盖的范围远比看上去要小。
校准(Calibration) 是分类器概率质量的核心指标:一个经过校准的模型,当其输出 0.9 时,意味着在大量同类样本中大约有 90% 确实是正确类别。未校准的模型仍可能具有很好的排序能力(即 AUC 高,高分样本确实更常正确),但数值本身不能直接当作概率使用。现代神经网络普遍存在过度自信问题,Guo 等人在 2017 年发现深度模型在 ImageNet 上的平均置信度远高于实际准确率,而 temperature scaling——用单一温度参数 T 对 logits 做缩放后再过 softmax——是一种简单且出奇有效的后处理修正方法。Platt scaling 和 isotonic 回归则分别适用于二分类和单调非参场景。校准必须在留出的标注数据上拟合,不能使用训练集,否则会过拟合分数分布。对于 LLM 管线而言,未校准的分数仍可用于排序和分桶,但只有校准后的分数才能在阈值规则中充当可信的风险等级。
标签合法 ≠ 标签正确
复旦大学与中国科学技术大学的 Sun、Xu、Shi、Yang 在论文《Type-Safe Is Not Error-Free》(2026 年 9 月)中测试了 Jev 以及两个同构模型:基于 ModernBERT 的 Laya 和基于 DeBERTa-v3 的 Open-Jev。三者的每个选项都是一个短名称加一段定义。例如名称 "yes" 附带定义 "一个人类应当检查这次运行","no" 附带定义 "无需人类关注"。
实验设计极其简单:问题、输入、名称和定义文本完全相同,唯一的变化是把哪个名称挂到哪个定义上,并在输入中把新配对写出来。读定义的模型在两版中会选择同一个定义,因此返回另一个名称;读名称的模型继续返回同一个名称,而此时它已意味着相反的语义。测试集是四个工作流上的 1200 个二元决策:发票对账、Agent 轨迹分诊、安全告警分类和客服升级。
Laya 的结果如下:
| 选项名称 | 决策翻转率 | 原配对 AUC | 交换配对 AUC |
|---|---|---|---|
| yes / no | 76.9% | 93.8% | 23.2% |
| false / true | 49.7% | 96.2% | 57.7% |
| rejected / accepted | 45.8% | 90.8% | 63.6% |
| 0 / 1(中性) | 6.5% | 94.2% | 92.4% |
| A / B(中性) | 6.0% | 94.2% | 94.1% |
数据摘自论文表 1 的选取行。
使用 yes/no 命名时,四分之三的决策发生了翻转。23.2% 的 AUC 是更关键的信号:它低于瞎猜的 50%,说明模型的分数仍然能区分两个类别,只是方向反了。正如作者指出的,AUC 不依赖决策阈值,因此"这个错误无法通过调整阈值来修正"。
Jev 本身没那么极端,但模式一致。使用 yes/no 命名时它翻转了 32.5% 的决策,比 0/1 命名高出 30.4 个百分点,AUC 从 81.5% 跌到 58.1%。由于 Jev 不是确定性的,作者还把原始版本跑了两遍看自然波动:两次之间最多只有 1.33% 的决策改变,也就是说 yes/no 的翻转率是这个底噪的 24 倍。
在所有条件下,类型错误率始终为 0%。每个答案都是合法选项。作者的结论值得记住:"类型安全保证了决策可以落在哪里,但不保证选项对模型意味着什么。"
有两个结果直接指向解决方案。把名称换成随机五字符串后,三个模型都回到了中性名称的翻转率,且交换前的准确率与中性名称时相差在 3.3 个百分点以内——含义是由定义承载的,模型也确实遵循了定义。极性比熟悉度更重要:"absent/present""negative/positive""rejected/accepted"这些 Laya 训练期间从未输出过的配对,仍把它的翻转率比中性名称抬高了 41 个百分点。
当名称与定义一致时,这为什么仍然重要
没人会故意把 "no" 挂到 yes 的定义上,所以产生式提示词关心这个问题是合理的。交换实验是测量工具,不是生产场景,它是判断模型到底在读定义还是读名称最干净的方式。在普通输入上两者一致,准确率无法告诉你在跟随哪一个。
凡是定义比词义更窄的地方,这件事都会要命。路由器里 "urgent" 队列的定义是 "生产系统宕机或客户无法登录"。一条写着 "我急需上个月发票的副本" 的工单,按定义属于账单队列,按字典词义属于紧急队列。如果模型更看重名称而非定义,它就会去错地方。"spam"(定义为排除合法的冷销售邮件)、"fraud"(定义为一组特定的拒付模式)、"qualified"(按销售团队标准而非词义)同理。
这对语言模型整体来说并不新鲜。Wei 等人(2023)指出,小语言模型"会忽略上下文中的翻转标签,从而主要依赖预训练带来的语义先验",覆盖这些先验是"模型规模带来的涌现能力",而指令微调"同时增强了语义先验的使用和学习输入—标签映射的能力,但前者更强"。Liusie、Manakul 与 Gales(2023)发现在零样本提示分类器里,"提示模板和标签词的精确选择会极大影响性能,语义等价的设置往往表现出显著的性能差异"。这篇 2026 年的论文新增的,是在最新一类为规避该问题而设计的模型上,给出了一种干净的测量方法。
AUC(Area Under the ROC Curve) 衡量的是模型对正负样本的排序能力:随机取一个正例和一个负例,模型给正例更高分数的概率。AUC 为 0.5 相当于随机猜测,1.0 表示完美排序。它的关键性质是不依赖于任何具体决策阈值,因此能独立反映模型的判别力。论文中交换名称与定义后 AUC 跌至 23.2%,低于 0.5,说明模型的分数仍然能区分两个类别,但方向被系统性反转——把本该低分的样本给了高分。这种反转无法通过移动阈值来修正,因为阈值只改变切点位置,不改变排序方向。这也解释了为什么只看准确率会漏掉问题:在类别大致平衡时,一个方向反了的模型准确率可能仍在 30%–50% 附近,看上去只是"效果差",而 AUC 低于 0.5 才明确暴露了语义反转这一结构性故障。
涌现能力(Emergent Ability)与语义先验(Semantic Prior) 是理解这一现象的关键背景。Wei 等人 2023 年的研究表明,小语言模型在面对上下文中被翻转的标签时,往往忽略这些新映射,继续依赖预训练阶段学到的语义先验——例如看到 "yes" 就联想到肯定,看到 "no" 就联想到否定。覆盖这种先验、真正学会输入到标签的新映射,被视为模型规模增大后才出现的涌现能力。指令微调虽然同时增强了先验的使用和学习新映射的能力,但前者的增强更明显。这解释了为什么交换名称与定义后模型仍按名称作答:预训练语料中 "yes/no" 与语义的绑定远比提示词里的临时定义更强。Liusie 等人也发现,零样本提示分类器中标签词的选择会极大影响性能,语义等价的设置常有显著差异。因此把含义放进定义、用中性 ID 作名称,本质上是切断模型对标签词先验的依赖,迫使它读取你提供的定义。
在自己的提示词上跑一次交换实验
最有用的一点是:这个测试不需要标签,只需要你的提示词、一批真实输入样本,以及每个输入两次额外调用。核心思路是——以 "name: definition" 形式列出选项,比较"按含义选中的定义"而不是"名称",把名称整体旋转一位后重跑:
def build_prompt(text, options):
    listed = "\n".join(f"- {name}: {definition}" for name, definition in options)
    return (
        "Pick the option whose definition fits the ticket. "
        "Reply with the option name only.\n\n"
        f"Options:\n{listed}\n\nTicket:\n{text}"
    )

def picked_definition(text, options, classify):
    name = classify(build_prompt(text, options), allowed=[n for n, _ in options])
    return dict(options)[name]  # 按含义比较,而不是按名称

def flip_rate(texts, names, definitions, classify, shift=1):
    original = list(zip(names, definitions))
    moved = list(zip(names[shift:] + names[:shift], definitions))  # shift=0 用于测量运行间噪声
    flips = sum(
        picked_definition(t, original, classify) != picked_definition(t, moved, classify)
        for t in texts
    )
    return flips / len(texts)
在几百条真实输入上跑三种方式:
- 真实名称,旋转一位(
shift=1)——这是你要的数。 - 中性名称,旋转一位——把名称换成 A、B、C 再跑一遍,这是对照组,因为旋转中性名称理应什么都不改变。
- 真实名称,不旋转(
shift=0)——同一提示词跑两遍,这是底噪,因为非零温度采样会在相同运行间改变部分答案。
如果第一个数接近另外两个,说明模型在读你的定义。如果远高于它们,说明你的定义有一部分只是装饰,而标签名称在做一部分决策。这种情况下论文给出的修复很便宜:把中性 ID 作为选项名,把所有含义放进定义,在代码里把 ID 映射回队列名。然后重跑准确率检查,因为这个改动并非自动免费——在 3 到 16 个选项的问题上,即使只是把 Laya 换成中性字母也会改变约一半的决策,尽管该模型在这些问题上的原始准确率只有 56.4%。测你自己的提示词,不要假设。
范围上有一点需要注意:论文测试的是类型化决策模型,不是通过 JSON schema 作答的聊天模型。你的模型表现得像 Laya、像 Jev 还是都不像,正是这三个数字要告诉你的。
一个可以设阈值的概率
路由器缺的第二样东西是分数。从 LLM 拿分数有两种常见方式,只有一种真正有用。
让模型说出自己的置信度。 在 schema 里加一个 "confidence" 字段很容易,但基本没有信息量。Xiong 等人在大规模评估中发现,LLM"在口头表达置信度时倾向于高度过度自信",数值"主要落在 80% 到 100% 区间,且通常是 5 的倍数,就像人类谈置信度那样"。在上面那个路由器例子里,模型在 500 条已标注工单中的 488 条上报告了 0.9 或更高。阈值没有任何可分离的空间。
读取标签本身的概率。 如果你的服务商暴露所选输出的 token log-probability(并非所有 API 或模型都支持),就用模型赋予所选标签的概率。单 token、彼此区分的选项名让这件事变得直接。这是真实的分数,但别假设它已校准。GPT-4 技术报告显示"预训练模型高度校准",但"经过后训练流程后,校准被削弱",其校准图直接标注为"后训练显著损害校准"。像 Jev 这样的类型化决策模型按设计返回分布,这是它的一项真实优势,但同样的检查仍然适用。
你需要知道的是:分数是否对模型的错误进行了排序。把标注集按分数分组,统计每组正确的比例。下面是一个路由器可能得到的示意表:
| 所选队列的概率 | 工单数 | 正确数 | 正确比例 |
|---|---|---|---|
| 0.95 以上 | 330 | 323 | 97.9% |
| 0.80–0.95 | 90 | 81 | 90.0% |
| 0.60–0.80 | 50 | 36 | 72.0% |
| 0.60 以下 | 30 | 20 | 66.7% |
| 合计 | 500 | 460 | 92.0% |
错误分布并不均匀。三分之一的工单(低于 0.95 的 170 条)包含了 40 个错误中的 33 个。这正是阈值得以成立的前提。
表中也暴露出分数并未完全校准:低于 0.60 的工单仍有三分之二的正确率。如果你希望这个数字本身可信,就在留出的标注切片上拟合校准修正:temperature scaling(Guo 等人(2017)发现它对神经网络"出奇地有效")、Platt scaling 或对原始分数做 isotonic 回归。可靠性图和这些修正方法正是 SophiArch 的应用机器学习课程中校准一讲的内容,该课程在梯度提升和随机森林模型上完整演练了它们——这些模型的原始概率同样需要这类修正。
阈值由错误代价决定
阈值不是画质设置,它是两种代价之间的权衡,两者都该写下来。假设一条错分路由的工单大约消耗 20 分钟人力(错团队阅读、判断不属于自己、转交,客户还在等待),人工分拣一条工单约 1 分钟且能分对。每 500 条工单:
| 概率至少为以下值时自动路由 | 自动路由 | 漏过的错误 | 转人工 | 成本(分钟) |
|---|---|---|---|---|
| 不设阈值 | 500 | 40 | 0 | 40 × 20 = 800 |
| 0.60 | 470 | 30 | 30 | 600 + 30 = 630 |
| 0.80 | 420 | 16 | 80 | 320 + 80 = 400 |
| 0.95 | 330 | 7 | 170 | 140 + 170 = 310 |
在这组代价下,把所有低于 0.95 的都转人工,能把路由成本削减约 60%(每 500 条从 800 分钟降到 310 分钟)。如果人工分拣一条要 3 分钟而不是 1 分钟,那么 0.80 阈值反而更优:320 + 240 = 560 分钟对 140 + 510 = 650 分钟。正确的阈值来自你的代价结构,而不是模型。
被转人工的工单还附带另一个收益:每一条都会带回一个正确标签,而且恰恰来自模型最不确定的那些案例。几个月后,这就是一个比你精心设计还要好的训练集。
temperature scaling 之外,理解 log-probability 的来源也很重要。 当服务商返回所选输出的 token log-probability 时,它反映的是模型在生成该 token 那一刻的分布,而不是对最终类别判断的置信度。如果选项名是单个 token 且彼此区分(避免 "yes" 与 "yes," 等分词歧义),这个数值才近似于类别概率。多 token 选项名需要把各 token 概率相乘或取平均,处理不当会引入偏差。此外,经过 RLHF 或其他后训练流程的模型,其 log-probability 已被人类偏好数据扭曲,GPT-4 技术报告明确指出后训练显著损害校准。因此拿到分数后的第一步应是画可靠性图:按分数分桶,统计每桶实际正确率。只有确认分数能对错误排序后,才谈得上阈值和校准修正。对于分类任务,使用逻辑回归等传统分类器在 TF-IDF 特征上往往能给出开箱即用且可校准的概率,这也是升级阶梯中把小分类器作为候选的原因之一。
沿阶梯向上爬
一旦一个决策有了标签、分数和阈值,你就可以在同等条件下比较不同的实现方式。一个合理的尝试顺序:
- 你已经在用的模型,配上中性选项 ID、输出约束到标签集、以所选标签的概率作为分数。如果准确率、交换测试和分数表在你的业务量下都可接受,就停在这里。
- 同一模型 + 校准修正,在留出标签上拟合,前提是你需要概率名副其实(比如下游规则把它当作风险等级来读)。
- 在你自己的标签上训练的小分类器,此时升级队列正在源源不断地生产标签。哪怕是 TF-IDF 特征上的逻辑回归也值得作为基线试试,因为它确定性、概率可用标准工具校准、运行成本几乎为零。至于微调或蒸馏小模型值不值得更进一步,是另一个成本问题。
- 专用决策模型,例如 Jev。这类模型按设计返回分布,速度可以很快。也请对它跑交换测试,因为这正是论文研究的那类模型。
每一级的退出测试都一样:准确率、分数表、交换翻转率,全部跑在你自己标注的流量上。不是厂商的基准,也不是模型对自己有多自信的描述。
对任何返回标签的 LLM 调用,五个问题
- 答案是否总是来自一个固定集合?那么它就是个分类器,无论这个调用看起来像什么。
- 你是否有几百条真人标注的真实输入,并且知道在其上的错误率?
- 当你把名称移到别的定义上时,有多少决策发生变化——相比中性名称、相比单纯重跑?
- 分数是否把错误排在了表格底部?是否有东西把它当作概率来读?
- 低分案例去了哪里,由谁来标注它们?
回到开头那个团队:他们用两周回答了全部五个问题。账单队列不再收到密码重置工单,"紧急"队列也安静了很多。
核心参考
- Sun, Y., Xu, J., Shi, J., & Yang, Z. (2026). Type-Safe Is Not Error-Free: Typed Decision Models Follow the Option Name, Not the Definition Bound to It.
- TypeSafe AI. Introducing System One models and Jev.
- Wei, J. et al. (2023). Larger language models do in-context learning differently.
- Liusie, A., Manakul, P., & Gales, M. (2023). Mitigating Word Bias in Zero-shot Prompt-based Classifiers.
- Xiong, M. et al. (2024). Can LLMs Express Their Uncertainty?.
- OpenAI (2023). GPT-4 Technical Report.
- Guo, C. et al. (2017). On Calibration of Modern Neural Networks.
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。