LLM攻克尼泊尔语推文NER难题:难例反超PLM

用LLM专攻PLM难以处理的低置信度难例,并通过提示优化与模型组合提升尼泊尔语推文NER效果。
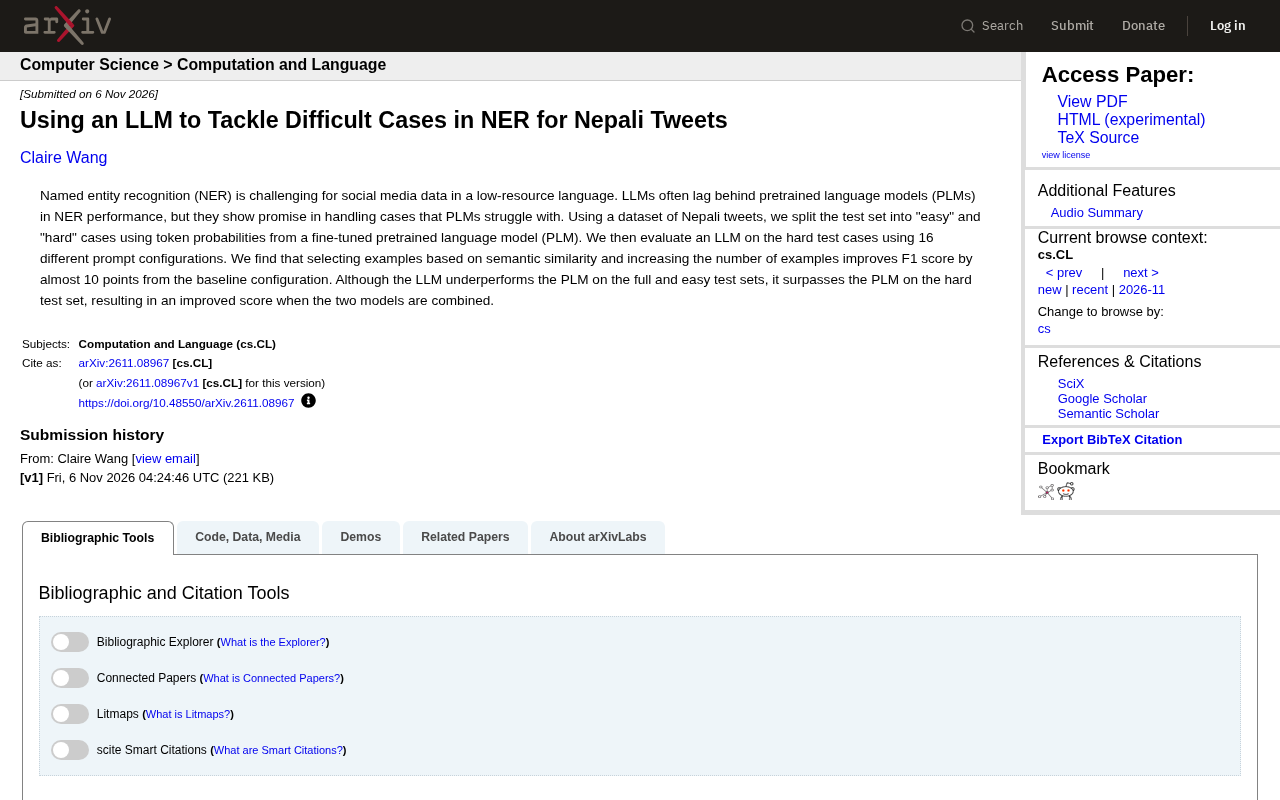
该研究针对尼泊尔语社交媒体文本的命名实体识别(NER),提出一种PLM与LLM分工协作的策略。研究者利用微调PLM的token概率将测试集分为简单和困难两部分,发现LLM在完整集和简单集上不如PLM,但在难例集上通过优化提示配置(基于语义相似度选择示例并增加示例数量)可将F1提升近10点,并超越PLM。进一步组合两个模型的预测结果,整体分数得到改善。这表明LLM并非PLM的替代品,而是处理长尾难例的补充工具,混合策略还能降低LLM的推理成本。该方法对低资源语言社交媒体NER具有普适参考价值。
在低资源语言的社交媒体文本上,命名实体识别(NER)一直是个棘手的任务。尼泊尔语推文更是如此——非正式拼写、混合语言、频繁的缩写和表情符号,让传统的预训练语言模型(PLM)也频频失手。但一项新近的分析指向一个有趣的策略:用大语言模型(LLM)专门处理PLM搞不定的“难例”,反而能实现整体效果的提升。
当PLM遇到难啃的推文
研究团队使用了一个尼泊尔语推文数据集,并利用微调后的PLM输出的token概率,将测试集划分为“简单”和“困难”两部分——概率低、模型犹豫的样本被归为难例。这相当于给数据做了一次“难度分层”,让后续的评估更有针对性。
在完整测试集和简单集上,LLM的表现确实不如PLM,这与过往观察一致:在NER这类结构化预测任务上,预训练模型往往更精准。但真正的看点在于难例集。
Token概率与置信度:在序列标注任务中,模型对每个token输出一个概率分布,表示其属于各类标签的置信程度。微调后的PLM在测试时,若某token的预测概率较低(如最大概率低于阈值),则说明模型对该位置的判断犹豫,这类样本往往包含边界模糊、类型歧义或未见过的语言模式。利用token概率进行难度分层,是一种无需额外标注的主动学习式评估方法,能有效识别模型的知识盲区。
提示工程:让LLM在难例上逆袭
研究者对LLM在困难测试集上尝试了16种不同的提示配置。核心发现是:基于语义相似度选择示例(few-shot示例检索),并增加示例数量,能将F1分数从基线配置提升近10个点。这不是小改进——在NER这种指标敏感的任务上,近10点的提升意味着大量实体边界和类型的正确判定。
语义相似度检索之所以有效,是因为难例往往具有独特的语言模式或领域词汇,相似的示例能引导LLM更好地理解当前上下文。而增加示例数量则给了模型更多“模式参考”,弥补了LLM在特定任务上缺乏微调的短板。
尽管LLM在完整集和简单集上仍落后于PLM,但在难例集上,它成功超越了PLM。这意味着两个模型具有互补性:PLM擅长常规模式,LLM则能处理边缘案例。
Few-shot示例检索:在上下文学习(in-context learning)中,示例的选择对LLM性能影响显著。随机选取示例可能引入无关模式,而基于语义相似度(如使用句子嵌入计算余弦相似度)检索与当前输入最接近的示例,能帮助模型更准确地捕捉任务边界和标签语义。对于难例而言,相似示例提供了针对性的模式参考,相当于动态构建了一个小型“训练集”,从而缓解LLM缺乏任务微调的问题。
模型组合:1+1>2
研究进一步将两个模型的预测结果结合,整体分数得到改善。这一结果提示了一个实用的工程思路:不必执着于用LLM替代PLM,而是让它们分工。对于低资源语言的社交媒体NER,先用PLM快速处理大部分简单样本,再让LLM集中火力攻克那些低置信度的难例,可能是性价比更高的方案。
这种混合策略也降低了对LLM推理成本的担忧——只有难例需要调用LLM,调用量大幅减少。
对低资源NER的启示
这项分析虽然聚焦尼泊尔语推文,但其方法论具有普适性。低资源语言的社交媒体数据普遍存在噪声大、标注少的问题,PLM的置信度分层和LLM的提示优化可以迁移到其他语言和领域。
你可能没注意到,提示配置的选择并非无关紧要:语义相似度检索和示例数量是两个关键杠杆,简单堆砌随机示例效果有限。对于实践者而言,这意味着在部署LLM处理难例时,值得投入精力设计示例检索策略。
从更广的视角看,LLM在NER任务上的定位正在变得清晰:它不是PLM的替代品,而是处理长尾难例的补充工具。在资源有限、标注昂贵的场景下,这种组合思路或许比追求单一“最强模型”更务实。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。