LLM推理学习指南:海量视频与手写笔记
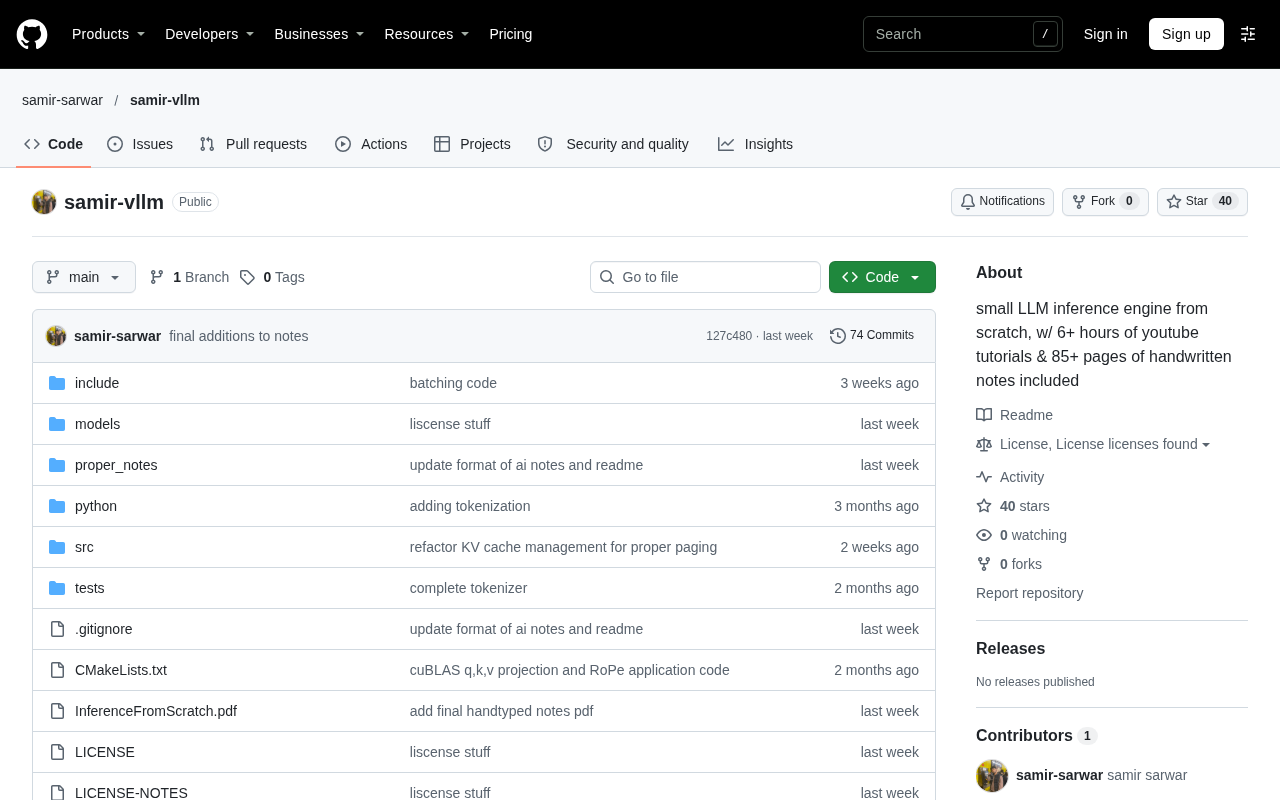
一位学习者通过视频与85页手写笔记整理LLM推理入门指南,折射出该领域系统化学习资源的稀缺与机遇。
文章围绕Hacker News上一位学习者耗费数小时观看YouTube视频并手写85页笔记整理LLM推理入门指南的分享展开。LLM推理是模型部署的核心环节,涉及量化、KV缓存、批处理等优化技术,但相关知识分散、缺乏系统性入门材料。视频与手写笔记结合的学习方式能加深理解,但个人笔记存在缺乏评审、更新滞后等局限,需结合官方文档与代码实践交叉验证。文章建议将此类笔记作为路线图,注重底层原理而非工具命令,并强调动手实验与社区讨论的重要性。该帖子热度不高,反映LLM推理学习资源仍处分散状态,系统化教程存在创作机会。
在信息过载的时代,如何高效学习一项复杂技术成为许多开发者面临的难题。最近,Hacker News 上的一则分享引发了关于 LLM 推理学习路径的讨论:一位学习者耗费数小时观看 YouTube 视频,并手写了 85 页笔记,整理出一份 LLM 推理的入门指南。尽管原始帖子只有简短的标题和链接,但这一行为本身折射出当前 AI 学习生态中的一些关键趋势。
为什么 LLM 推理值得投入时间?
LLM(大语言模型)推理是模型部署与落地的核心环节。与训练相比,推理直接关系到用户体验、成本控制和系统稳定性。随着模型规模不断扩大,推理优化技术如量化、KV 缓存管理、批处理策略等变得至关重要。然而,这部分知识往往分散在学术论文、技术博客和视频教程中,缺乏系统性的入门材料。这位学习者通过整合视频内容与手写笔记,试图构建一条从零开始的学习路径,恰好回应了社区对结构化教程的需求。
量化(Quantization) 是指将模型权重和激活值从高精度浮点数(如 FP32、FP16)转换为低精度表示(如 INT8、INT4)的技术。其核心动机在于:LLM 的参数量动辄数十亿,推理时需将全部权重载入显存,高精度格式导致显存占用巨大且内存带宽成为瓶颈。量化可将模型体积压缩 2-4 倍,同时利用整数运算单元提升吞吐量。常见方法包括训练后量化(PTQ)和量化感知训练(QAT),前者无需重新训练、实现简单,后者在训练中模拟量化误差,精度损失更小。实际部署中,GPTQ、AWQ 等算法已能在 4-bit 量化下保持接近原模型的生成质量,是降低推理成本的关键手段之一。
KV 缓存(Key-Value Cache) 是大语言模型自回归生成中的核心优化机制。在 Transformer 解码器中,每生成一个新 token,都需要对之前所有 token 的 Key 和 Value 向量进行注意力计算。若每次重新计算,开销将随序列长度平方增长。KV 缓存将历史 Key/Value 存储下来,避免重复计算,从而将单步生成的计算复杂度从 O(n²) 降至 O(n)。然而,缓存本身会占用大量显存,且随批大小和序列长度线性增长。因此,PagedAttention、KV 缓存量化、前缀共享等技术被提出以优化缓存管理,这些也是推理系统(如 vLLM)的核心创新点。
多源学习材料的价值与局限
从 YouTube 视频到手写笔记,这种学习方式体现了多源信息融合的优势。视频教程通常直观展示推理流程和工具使用,而手写笔记则促使学习者主动提炼关键概念,加深记忆。85 页的笔记量表明内容覆盖了相当多的主题,可能包括推理基础、性能指标、优化技巧等。不过,这种个人笔记的局限性也很明显:缺乏同行评审,可能存在理解偏差;且更新速度难以跟上快速迭代的技术。
在 Hacker News 的讨论中,有评论者指出,类似的学习资源虽然宝贵,但需要结合官方文档和开源代码实践才能形成完整认知。这也提示读者,在参考此类材料时应保持批判性思维,交叉验证关键信息。
批处理策略(Batching) 是推理服务中提升吞吐量的关键手段。由于单个请求的 GPU 利用率往往不足,将多个请求合并为一个批次并行计算,可以显著摊薄计算成本。但其挑战在于:不同请求的输入长度和输出长度各异,且生成是逐 token 进行的,简单批处理会导致短请求等待长请求(即“队头阻塞”)。为此,业界提出了连续批处理(Continuous Batching)和动态批处理(Dynamic Batching)等策略,允许新请求在任意时刻加入批次、完成的请求立即退出,从而在保证低延迟的同时最大化 GPU 利用率。理解批处理策略有助于开发者权衡延迟(Latency)与吞吐量(Throughput)这一对核心矛盾,也是选择推理框架时的重要考量。
如何高效利用这类学习资源
对于想要入门 LLM 推理的开发者,可以将这类笔记作为路线图而非终极答案。建议先快速浏览笔记结构,了解核心话题的分布,然后针对每个主题查阅原始视频或相关论文。动手实践不可或缺,例如使用开源推理框架进行小规模实验,观察不同参数对延迟和吞吐量的影响。社区讨论也是重要补充,Hacker News 等平台上的经验分享往往能揭示文档中未提及的陷阱。
有意思的是,学习过程中应关注推理技术的底层原理而非单纯记忆工具命令。例如,理解注意力机制的计算瓶颈有助于更好地应用优化手段。这位学习者的 85 页笔记如果能够公开分享,或许能成为更多人入门的垫脚石,但更重要的是培养自主整理和验证知识的能力。
注意力机制的计算瓶颈 是理解 LLM 推理性能的关键。标准自注意力需要计算 Query 与所有 Key 的点积,复杂度为 O(n²·d),其中 n 为序列长度、d 为隐藏维度。在长上下文场景下,注意力计算和 KV 缓存访存会成为主要瓶颈。此外,解码阶段是典型的内存带宽受限(memory-bound)任务:每生成一个 token 需读取全部模型权重和 KV 缓存,但计算量很小,因此 GPU 算力大量闲置。这解释了为何量化、KV 缓存压缩、FlashAttention(通过分块计算减少显存读写)等优化手段能带来显著加速。掌握这些底层原理,才能在实际调优中判断瓶颈所在,而非盲目套用工具。
社区反响与启示
该帖子在 Hacker News 上获得了 12 个点数,评论数较少,说明它可能是一个小众但垂直的分享。这种低热度并不代表内容无价值,反而反映了 LLM 推理领域的学习资源仍处于分散状态,尚未形成广泛传播的经典教程。对于内容创作者而言,这提示了一个机会:将零散的知识点系统化,制作高质量的入门指南,可能会受到社区欢迎。
总体来看,这位学习者的投入展现了技术学习的热情与方法。在 AI 技术快速演进的背景下,持续学习和知识整理能力比以往任何时候都重要。LLM 推理作为一个实践性强的方向,需要更多这样的探索者分享他们的学习路径,共同构建更完善的知识体系。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。