M4 Max跑本地大模型:42与130 tokens/s的三个开关

同一台 M4 Max 上,运行时、电源模式与模型结构可让推理速度相差三倍。
文章汇总五份公开基准,说明同一台 M4 Max 跑同一模型,速度可从 42 tokens/s 到 130 tokens/s,差距来自三个常被忽略的设置。其一是运行时:MLX、LLAMA.cpp、Ollama 底层引擎不同,速度差 1.5 到 3 倍,Ollama 切换到 MLX 后端后从 58 跳到 112。其二是电源模式:低功耗与高功耗模式最高差 3.84 倍,是被普遍忽视的变量。其三是模型结构:MoE 每 token 只激活约 3B 参数,远快于稠密 27B 的约 22 tokens/s。文章同时给出反例:MLX 并非永远快两倍,多数模型上仅领先约 10%,量化格式与内存占用也会扭曲对比。
同一台 M4 Max,同一个模型,一次跑出 42 tokens/s,另一次跑出 130 tokens/s。差别不在芯片,也不在模型,而在于三个大多数人从未注意的设置:运行时、电源模式、模型结构。一位 B站搬运的海外视频汇总了五份公开基准测试,把所有数字在屏幕上标注来源,并给出可直接套用的结论。
三个数字背后的现实:速度就是等待时间
一个编程 Agent 单次回答可以生成 2000 tokens。42 tokens/s 意味着约 48 秒的等待,130 tokens/s 则压缩到约 15 秒。每天 50 次回答,慢配置会吃掉整个下午。
视频设定了一个基本门槛:所有参与对比的模型都来自过去 12 个月内发布,并在 Hugging Face 上核实过,包括 Qwen 3.5/3.6/3.8、Google Gemma 4、NVIDIA Nemotron 3 Nano 与 DeepSeek广告 V4 Flash。
开关一:运行时决定了 1.5 到 3 倍的差距
2026 年 3 月,Ante Kapetovic 在 128GB M4 Max 上运行 Qwen 3.5 35B(4-bit 权重),MLX 达到 130.2 tokens/s,LLAMA.cpp 为 72.4,Ollama 落在 41 到 48 之间。用他的话说,MLX 比 Ollama 快两到三倍,比 LLAMA.cpp 快约一倍半,而模型本身只占用约 20GB 内存。
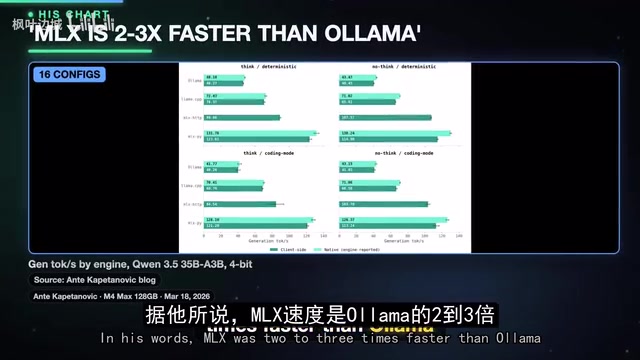
但剧情很快反转。12 天后 Ollama 移除了旧的 Apple 引擎,3 月 30 日发布的 Ollama 0.19 在 Apple Silicon 上切换到 MLX 后端。Ollama 自己的测试中,解码速度从 58 tokens/s 跳到 112。需要注意小字说明:该版本以预览形式发布,只支持一个模型,要求 Mac 内存大于 32GB,且新测试使用了不同的 NVFP4 格式。到 6 月,Ollama 称引擎再快 20%,NVFP4 比旧的 Q4 格式快约 20%。
MLX、LLAMA.cpp 与 Ollama 是什么关系
这三者并非同一层面的竞争对手。LLAMA.cpp 是 Georgi Gerganov 发起的底层 C/C++ 推理框架,支持 CPU、CUDA、Metal 等多种后端,兼容 GGUF 量化格式,几乎所有本地推理工具都在它之上构建。MLX 是 Apple 自家机器学习团队推出的数组计算框架,专门为 M 系列芯片的统一内存架构设计,能直接调用 Metal 与神经引擎,因此在对 Apple Silicon 优化充分的模型上往往更快。Ollama 不是推理引擎,而是打包与调度层:它负责拉取模型、管理上下文、暴露 API,底层引擎可以替换。这正是文章中提到「Ollama 移除旧 Apple 引擎、切换到 MLX 后端」后速度骤变的原因——同一个 Ollama,换了引擎,性能就完全不同。用户看到的 tokens/s 数字,实际由「Ollama 调用了哪个引擎 + 该引擎的版本」共同决定,而非 Ollama 本身。
开关二:电源模式,被所有人忽略的变量
QPark 在两台 128GB M4 Mac 上分别用低功耗和高功耗模式跑相同提示词与模型。同一台机器,速度差 1.4 到 3.8 倍。Ollama 跑 Qwen 3.5 35B,低功耗 51.9 tokens/s,高功耗 107.1。稠密的 Qwen 3.6 27B 从 11 翻倍到 22。DeepSeek V4 Flash 从约 9 涨到 27,接近三倍。短回答场景更夸张,28.5 tokens/s 直接跳到 109.6,即 3.84 倍,唯一变量就是电源设置。
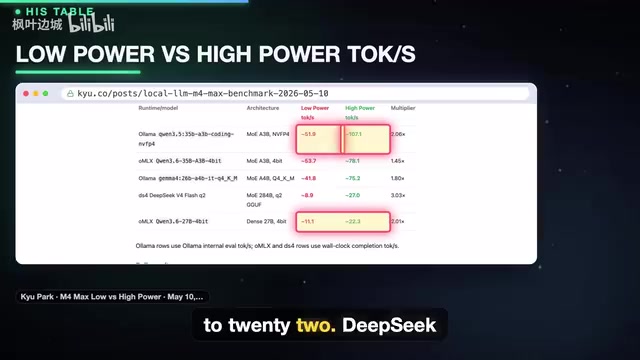
QPark 自己也标注了局限:每个用例只跑一次,没有取平均。但这足以说明,过去看过的基准视频如果开着低功耗模式,那台 Mac 可能被低估了三倍。他的建议简单直接:先检查电源模式。
Apple Silicon 的低功耗模式做了什么
macOS 的低功耗模式并非简单的风扇降速或省电待机,而是主动对 SoC 施加限制。开启后系统会下调 CPU 与 GPU 的功耗上限,限制持续睿频能力,并在部分机型上降低内存带宽调度优先级、放缓 P 核唤醒频率。对于 LLM 推理这种高度依赖内存带宽与持续矩阵运算的负载,这些限制会直接体现在每秒解码的 token 数上。更关键的是,这个开关在系统设置中位置隐蔽,很多跑基准的人根本没意识到自己开着它,于是同一台机器在不同视频里能差出三倍。高功耗模式则解除这些限制,让芯片在散热允许范围内跑到满血睿频。需要注意的是,高功耗模式在长时间负载下会更快触发降频,因此单次短测与长任务实测的结果可能又有出入,这也是基准数据需要标注持续时长的原因。
开关三:MoE 与稠密模型的结构鸿沟
混合专家(MoE)模型每个 token 只唤醒约 30 亿参数的一小部分。在高功耗运行中,35B 的 MoE 模型达到 78 到 107 tokens/s,而稠密的 27B 只有 22。NVIDIA 的 Nemotron 3 Nano 同样是把约 3B 激活参数用在每个 token 上,John Rocky 的 Apple Silicon LLM 基准记录到 MLX 159.7 tokens/s、LLAMA.cpp 86.2,但两次运行的量化并不一致。
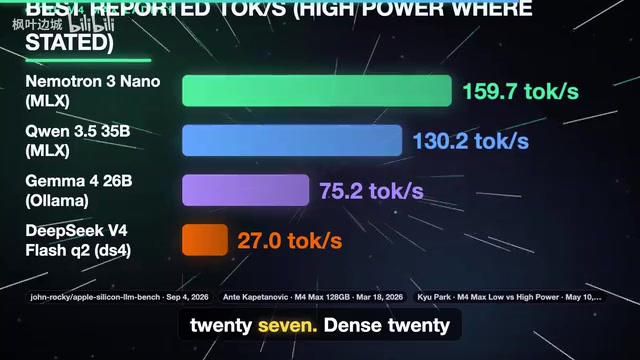
这些数字来自不同的人、不同的日期和格式,并非一次干净的对照实验,但模式在每份来源中都成立:MoE 起飞,稠密爬行。
MoE 为什么能在同等体积下跑得更快
混合专家(Mixture of Experts)把一个模型的前馈层拆成许多「专家」子网络,每个 token 推理时由路由网络只挑选其中少数几个专家参与计算。因此一个总参数 35B 的 MoE 模型,每个 token 真正激活的参数可能只有约 3B,但模型仍保有 35B 的存储与知识容量。这就是「体积大、算得少」的来源:显存或统一内存必须装下全部权重,实际计算量却接近一个小模型,解码速度因此接近小稠密模型,而回答质量更接近大模型。稠密模型没有这条路,所有参数每个 token 都要算一遍,27B 就是实打实算 27B,速度自然被压在低位。理解这一点就能看懂文章里「MoE 起飞、稠密爬行」的阶梯:速度差异来自激活参数量,而内存占用来自总参数量,两者需要分开看。
反例:MLX 并非永远快两倍
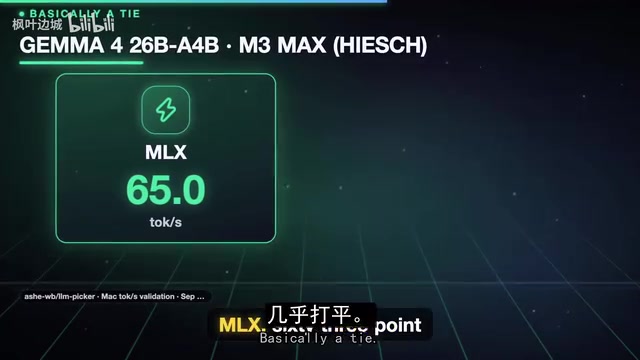
大多数视频忽略了一点。Ash 的 LLM Picker 项目收集了 92 份公开 Mac 测量数据,在多数模型上 MLX 只领先 1 到 1.2 倍,大差距主要集中在 Qwen 3.5 和 3.6 系列。例如 Gemma 4 26B 在 M3 Max 上,MLX 为 65.0,LLAMA.cpp 为 63.9,基本打平。
另一面,Ollama 有时反而赢。Jordan Ilchif 在 32GB M4 MacBook Air 上测 Qwen 3.8 27B,Ollama 的 NVFP4 构建跑出 17.2 tokens/s,纯 MLX 6.6,LLAMA.cpp 4.4。但他提醒格式不同。在公平的 4-bit 对比中,MLX 搭配 D-Flash 2 推测解码胜出,16.6 对 Ollama Q4 的 5.7;35B MoE 上 MLX 32.8、Ollama 29.9。他的结论是:MLX 的领先已回落到约 10%,"MLX 永远两倍于 Ollama"的说法已经过时。
量化格式与推测解码为何影响横向可比性
量化是把模型权重从高精度(如 FP16)压缩成低位宽表示以省内存、提速度的手段,常见的有 Q4、4-bit、NVFP4 等。不同格式的压缩方式、分组粒度、是否保留缩放因子都不一样,因此同样叫「4-bit」,NVFP4 与 Q4 的实际精度与解码开销并不相同。当一个测试用 NVFP4、另一个用 Q4 时,两者跑出的 tokens/s 就不是同条件对比,直接相减会得出误导性结论。推测解码(Speculative Decoding)是另一层变量:它让一个小型草稿模型先快速猜出若干 token,再由主模型批量验证,接受率高时能显著提速,但收益取决于任务与草稿模型匹配度。文章里「MLX 搭配 D-Flash 2 推测解码 16.6、Ollama Q4 5.7」正是把量化和解码策略两个变量同时改变的结果,因此在采信任何速度对比前,必须确认这两项是否对齐。
速查表与四个检验点
按高功耗加 MLX 或 Ollama 的公开数据,M4 Max 大致阶梯为:Nemotron 3 Nano 约 160,Qwen 3.5 35B 在 107 到 130,Gemma 4 26B 约 75,DeepSeek V4 Flash 约 27,稠密 27B 约 22。
想跑最快的编程 Agent,选 Qwen 3.5 或 3.6 35B 这类 MoE,配 MLX 或较新 Ollama。想要最聪明的稠密模型,选 Qwen 3.8 27B 加推测解码。跑 Gemma 4 时,运行时几乎不重要。
在相信任何 tokens/s 数字之前,检查四点:是否开启高功耗模式;运行时及其版本;量化格式是 NVFP4、4-bit 还是 Q4;结果是单次还是多次取中位数。漏掉任意一项,数字可能偏差三倍。
还有内存这一隐形陷阱。Jordan 指出 Qwen 3.8 的 10 万 token 上下文,会在模型之外多占约 24GB,直接压垮 32GB Mac。128GB M4 Max 则有余量。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。