M5 Ultra Mac Studio:本地AI智能体的理想工作站?
M5 Ultra Mac Studio凭借统一内存架构,正成为本地AI智能体部署的标杆桌面设备。
M5 Ultra Mac Studio因其统一内存架构(UMA)在本地AI部署领域受到广泛关注。该架构使CPU与GPU共享高带宽内存池,解决了传统独立显卡显存容量受限的核心瓶颈,使单机加载70B级别大模型成为可能。本地运行AI智能体在隐私保护、成本控制和离线能力上具有云端难以替代的优势,尤其适合处理敏感数据的开发者和小团队。然而,统一内存购后不可升级、高配价格昂贵,以及相比CUDA生态仍存在的工具链适配滞后,是选购前必须权衡的现实约束。该设备定位于中等规模模型的本地推理与智能体实验,而非全面替代云端算力。
为本地AI而生的桌面机器
随着大语言模型和AI智能体(AI Agents)逐渐从云端走向本地部署,开发者对硬件的诉求也发生了根本性变化。Mac Studio凭借其统一内存架构(Unified Memory)和苹果自研芯片的能效表现,成为不少AI从业者关注的桌面方案。此次围绕M5 Ultra版Mac Studio的讨论,核心正是它作为「本地AI智能体梦想机」的定位。
这台设备之所以被寄予厚望,关键在于它试图解决本地运行大模型时最棘手的两个瓶颈:显存容量与内存带宽。传统的独立显卡方案受限于显存大小,往往难以在单机上加载较大参数量的模型,而苹果的统一内存架构让CPU与GPU共享同一块高带宽内存池,从而为运行大型本地模型提供了可能。
统一内存架构的优势与代价
对于希望在本地部署AI智能体的用户来说,统一内存是Mac Studio最具吸引力的特性。当你需要同时运行推理框架、加载模型权重并处理上下文时,大容量的统一内存意味着可以容纳参数规模更大的模型,而不必频繁进行内存交换或依赖量化压缩牺牲精度。
这一架构也让「本地智能体」这一使用场景变得现实。AI Agent通常需要长时间驻留、维护记忆状态并反复调用模型,本地运行不仅规避了云端API的调用成本和隐私顾虑,也能保证响应的稳定性。对于处理敏感数据或需要离线运行的开发者,这种自主可控的价值难以被云服务替代。
不过,统一内存并非没有代价。相比可扩展的传统内存方案,苹果芯片的内存在购买时即固定,后期无法升级,这意味着用户必须在选购阶段就为未来的模型规模预留足够冗余。而高配版本的价格往往不菲,这也是社区讨论中反复出现的权衡点。
从技术原理上看,苹果的统一内存架构(Unified Memory Architecture,UMA)将CPU、GPU和神经网络引擎的内存物理合并为单一内存池,通过片上互联总线实现极高的带宽共享。以M5 Ultra为例,其内存带宽可达800GB/s以上,远超传统PCIe连接的独立显卡(通常为600-900GB/s的显存带宽,但主机内存与显存之间的传输带宽仅约64GB/s)。这对大模型推理至关重要:运行一个70B参数的模型,以FP16精度需要约140GB内存,以Q4量化需要约40GB,统一内存池使得GPU可以直接寻址全部系统内存,而不需要在主机内存和显存之间频繁搬运数据。这正是苹果芯片能够以远低于多卡GPU集群的硬件成本运行同等规模模型的核心原因。
本地AI智能体的实际意义
将AI智能体部署在本地,代表着一种与云优先思路不同的技术路线。从Hacker News社区的讨论热度来看,这一方向正获得越来越多开发者的认同。它的吸引力体现在几个层面:
数据不出本地,隐私与合规风险显著降低;没有按调用计费的持续开销,长期使用成本更可控;不依赖网络连接,可在完全离线的环境中运行复杂的智能体工作流。对于需要处理内部代码、私有文档或专有数据的团队,本地方案的战略价值尤为突出。
M5 Ultra Mac Studio正是瞄准这一细分需求。它并非要取代大规模数据中心的训练能力,而是聚焦于「本地推理与智能体运行」这一日益增长的场景,为个人开发者和小团队提供一台足够强大又相对紧凑的桌面级方案。
AI Agent(AI智能体)是一种能够自主规划、调用工具并迭代执行多步骤任务的大模型应用范式,区别于单次问答的关键在于其持续性:智能体需要维护对话历史、工具调用记录和中间状态,并在多轮循环中反复调用底层语言模型。这意味着相比普通聊天应用,智能体对推理延迟和上下文窗口的消耗要敏感得多。本地部署的优势在此尤为明显——云端API按Token计费,一个运行数小时的复杂智能体工作流(如自动化代码审查、长文档分析)可能产生数十美元的调用成本,而本地推理的边际成本仅为电费。当前主流的智能体框架如LangGraph、AutoGen和CrewAI均已支持接入本地模型端点,进一步降低了迁移门槛。
值得权衡的几个现实问题
尽管前景诱人,选择这类设备前仍有若干现实因素需要考量。硬件成本是首要问题——高内存配置的Mac Studio价格不菲,用户需要评估本地部署相对于云端订阅的长期性价比。
生态兼容性同样关键。虽然苹果芯片在AI推理领域的软件支持日趋成熟(如MLX框架、llama.cpp的Metal加速等),但相比CUDA生态,部分前沿模型和工具链的适配仍存在滞后。开发者在选型前应确认自己所依赖的框架是否已获得良好支持。
此外,本地硬件的性能上限终究有限。对于超大参数量的模型或高并发的推理需求,单台设备可能力不从心。M5 Ultra Mac Studio更适合中等规模模型的本地运行与智能体实验,而非替代所有云端算力。
MLX是苹果专门为Apple Silicon设计的机器学习框架,2023年底开源发布,其设计哲学借鉴了NumPy、PyTorch和JAX的接口风格,并针对统一内存架构进行了深度优化——计算图可以无缝跨CPU与GPU执行,无需手动管理数据在设备间的迁移。llama.cpp则是一个高度可移植的C/C++推理引擎,通过Metal后端支持Apple GPU加速,能够高效运行GGUF格式的量化模型。这两个框架目前已支持主流开源模型(如LLaMA、Mistral、Qwen、DeepSeek广告等系列),是苹果芯片本地推理生态的两大支柱。相比之下,CUDA生态中的vLLM、TensorRT-LLM等高性能推理框架尚无原生Apple Silicon版本,这是评估工具链适配程度时需重点关注的差距。
结语
M5 Ultra Mac Studio所引发的讨论,折射出本地AI浪潮的一个真实趋势:越来越多的开发者希望将AI能力掌握在自己手中,而非完全依赖云端。凭借统一内存架构和出色的能效比,它为本地AI智能体提供了一个颇具竞争力的桌面选项。对于重视隐私、追求可控成本并深耕本地部署的用户而言,这类设备正在从「小众选择」逐步走向主流视野。
相关推荐
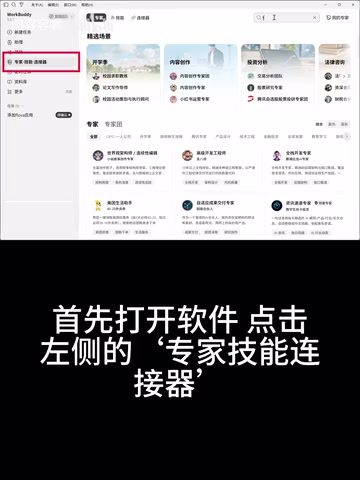
用AI照抄舞蹈动作:换人换画风不换动作实操教程
详解如何用AI复刻舞蹈动作,实现换人、换画风但保留原动作的效果。通过Flova拉片大师工具,上传角色参考图、舞蹈视频和深度视频即可自动生成,附完整操作步骤。
医生职业的阴暗面:一篇引发热议的深度反思
一篇题为《医生职业的阴暗面》的文章登上 Hacker News 热榜,获 254 赞与 287 评论。本文解读该话题为何在技术社区引发热议,并探讨职业倦怠这一跨行业的普遍命题。
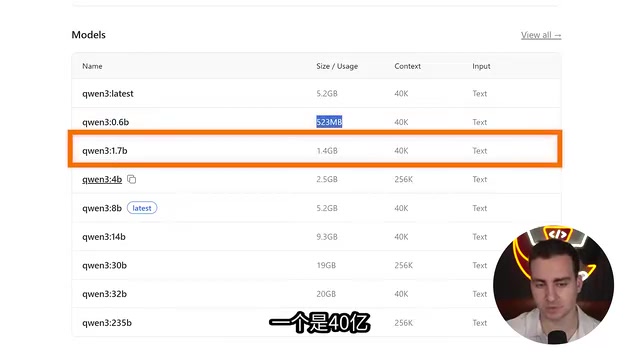
10分钟用Python搭建完全本地的AI智能体教程
本教程演示如何用 Ollama 和 Pydantic AI,几十行 Python 代码搭建完全本地运行的AI智能体,涵盖模型选择、工具函数定义和主循环编写,实现离线、免费、隐私安全的智能体应用。