MacBook训练PPO智能体:隐藏信息卡牌游戏Cabo实战

开发者在MacBook上用自对弈PPO训练出会“读心”的Cabo卡牌AI,并揭示其涌现策略与平台期挑战。
本文介绍了一个在MacBook上从零训练的Cabo卡牌游戏智能体,采用PPO算法和信念头辅助任务,通过槽位对称性处理和向量化环境实现高速训练。智能体在5.5小时内对规则机器人胜率达到90%,并涌现出故意输掉回合以重置分数、精准换牌等策略。然而,对规则机器人的胜率已趋于平台期,开发者尝试的前瞻搜索和专家迭代效果不佳。文章最后讨论了下一步计划,包括收集人类对局数据以评估和微调智能体,并寻求突破平台期的建议。该项目展示了消费级硬件上训练复杂隐藏信息游戏AI的可行性。
从零训练一个会“读心”的卡牌AI
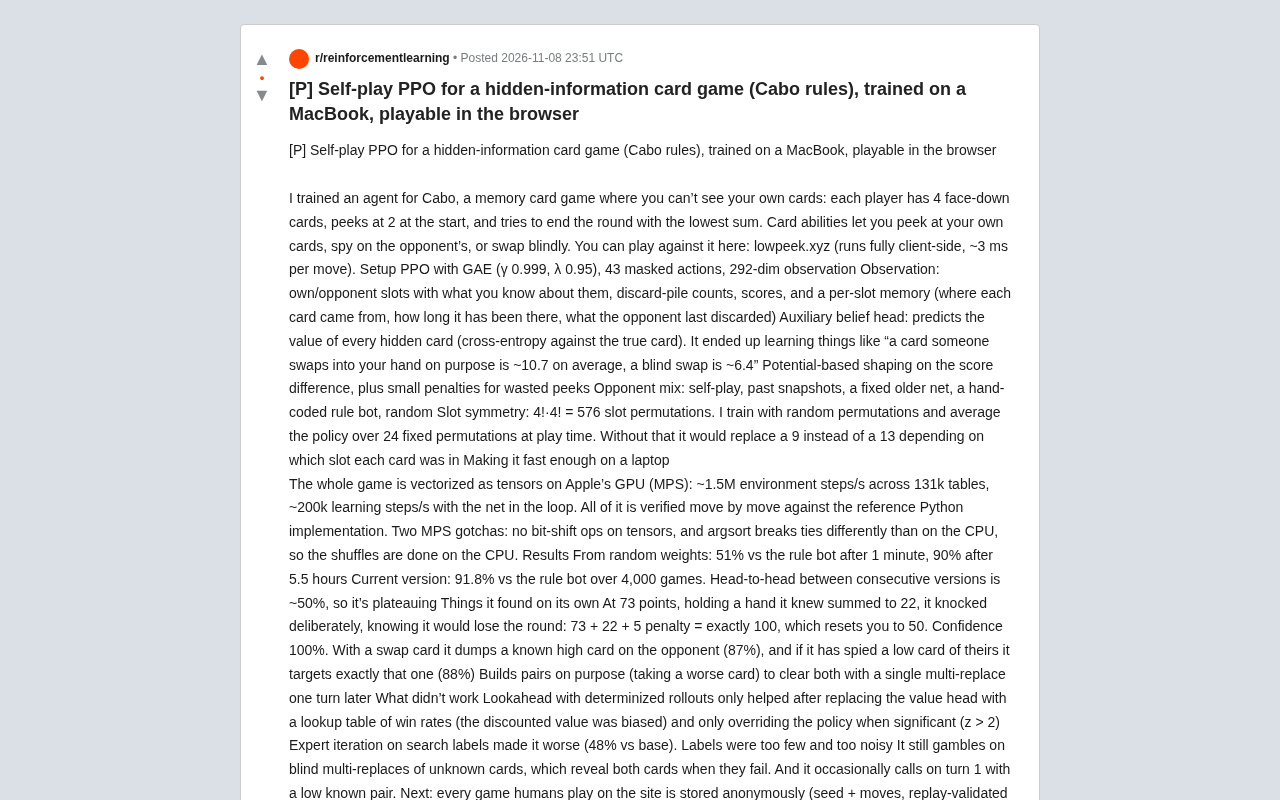
最近,一位开发者在Reddit上分享了他的项目:用自对弈PPO训练一个隐藏信息卡牌游戏Cabo的智能体,并且整个训练过程在一台MacBook上完成。Cabo是一款记忆类卡牌游戏,玩家看不到自己的牌,每人4张面朝下的牌,开局只能偷看其中2张,目标是让回合结束时手牌点数总和最低。卡牌技能允许你偷看自己的牌、侦察对手的牌,或者进行盲换。
你可以在lowpeek.xyz上直接与这个智能体对战,它完全在浏览器客户端运行,每次移动的响应时间约为3毫秒(据开发者描述)。
轻量级架构与训练配置
智能体采用PPO算法,配合GAE(γ=0.999,λ=0.95),动作空间为43个掩码动作,观测维度为292维。观测信息包括:己方和对手的牌槽位(以及你对它们的已知信息)、弃牌堆计数、分数,以及每个槽位的记忆(每张牌的来源、停留时长、对手最后弃掉了什么)。
一个关键的辅助设计是信念头(belief head):它预测每张隐藏牌的值,使用交叉熵损失与真实牌面进行训练。这个辅助任务让智能体学会了一些有趣的统计规律,比如“对手故意换到你手里的牌平均约为10.7点,而盲换的牌平均约为6.4点”。
训练中还使用了基于势能的奖励塑形(potential-based shaping)来优化分数差异,并对浪费的偷看行为施加小幅惩罚。对手池混合了自对弈、历史快照、固定旧网络、手写规则机器人以及随机策略。
PPO(Proximal Policy Optimization)是一种基于策略梯度的强化学习算法,通过限制每次策略更新的幅度来保证训练稳定性。它使用裁剪的替代目标函数,避免策略在单次更新中变化过大。GAE(Generalized Advantage Estimation)则是一种优势函数估计方法,通过参数γ(折扣因子)和λ(平滑因子)在偏差与方差之间权衡。γ接近1(如0.999)表示智能体更关注长期回报,λ=0.95则对优势估计进行指数加权平均,减少方差。在卡牌游戏中,GAE能有效处理稀疏奖励和延迟回报的问题。
动作掩码(action masking)是处理可变动作空间的关键技术。在Cabo中,并非所有43个动作在任何时候都合法(例如,没有对应手牌时不能使用换牌卡)。通过将非法动作的概率置零并重新归一化,智能体只会从合法动作中采样,避免无效探索。观测维度292维则编码了所有可见信息及记忆特征,使网络能够基于完整状态进行决策。
槽位对称性:一个容易被忽略的细节
Cabo中手牌的4个槽位具有对称性,总共有4!·4! = 576种排列。开发者训练时使用随机排列,但在对战时对24个固定排列的策略输出取平均。如果不做这个处理,智能体可能会因为牌所在槽位的不同而做出错误决策——比如该换掉9的时候却换掉了13。
这个细节揭示了隐藏信息游戏中的一个普遍挑战:策略需要对状态的对称性保持鲁棒,否则学到的策略会过拟合到特定的槽位编号上。
在隐藏信息卡牌游戏中,状态对称性是指那些在物理上不同但在策略上等价的状态。以Cabo为例,手牌的4个槽位在规则上没有区别,但神经网络看到的输入是带有槽位编号的向量。如果训练时只使用一种固定的槽位排列,网络可能会将某些策略与特定槽位编号绑定,而不是学习到真正的牌值关系。这属于过拟合的一种形式,导致智能体在槽位编号变化时表现下降。
解决对称性的常见方法包括:数据增强(在训练中随机打乱槽位顺序)、参数共享(设计对排列等变的网络结构)或推理时集成(对多个对称变换的输出取平均)。开发者采用了训练时随机排列、对战时对24个固定排列取平均的简单方案,这相当于一种测试时的集成,以较低成本提升了策略的鲁棒性。类似问题在德州扑克、麻将等游戏中同样存在,是设计隐藏信息游戏AI时必须考虑的细节。
在MacBook上实现高速训练
为了让训练在笔记本上可行,整个游戏被向量化为张量,运行在Apple的GPU(MPS)上。开发者报告称,在131k张牌桌上每秒可执行约1.5M环境步,网络参与循环时每秒约200k学习步。所有逻辑都逐移动与参考Python实现进行了验证。
不过MPS有两个坑:张量不支持位移操作,并且argsort的平局处理与CPU不同,因此洗牌操作放在CPU上完成。
MPS(Metal Performance Shaders)是Apple为自家芯片(M1/M2/M3等)提供的GPU加速框架,PyTorch通过mps后端支持在Mac上进行张量计算。与CUDA相比,MPS生态较新,部分操作尚未完全支持或行为不一致。例如,位移操作(bitwise shift)在MPS张量上可能未实现,而argsort在遇到相等元素时的排序稳定性可能与CPU不同,这会影响洗牌等依赖随机排列的操作。
开发者将洗牌放在CPU上执行,正是为了规避这些不一致性。在强化学习训练中,环境步进(environment steps)和学习步(learning steps)是衡量吞吐量的两个关键指标。环境步指智能体与环境交互的次数,学习步指网络参数更新的次数。在131k张牌桌上达到每秒1.5M环境步,意味着向量化环境充分利用了GPU的并行能力;而每秒200k学习步则反映了网络前向和反向传播的效率。这种量级的吞吐使得在消费级硬件上进行大规模自对弈成为可能。
训练结果与涌现行为
从随机权重开始,智能体在1分钟后对规则机器人的胜率达到51%,5.5小时后达到90%。当前版本在4000局对战中达到91.8%的胜率。但连续版本之间的头对头胜率约为50%,说明性能正在趋于平台期。
智能体自发学到了一些令人惊讶的策略:
- 故意输掉回合以重置分数:当它持有已知总和为22的手牌且总分为73时,它会故意敲牌结束回合,明知会输掉这一轮。因为73+22+5 penalty = 正好100,触发重置到50。置信度100%。
- 精准换牌:使用换牌卡时,它会把已知的高牌甩给对手(87%的情况),如果它侦察到对手的低牌,会精确地 targeting 那一张(88%)。
- 故意配对:它会主动拿一张更差的牌来凑对,以便在下一回合用一次多换清掉两张。
涌现行为(emergent behavior)指智能体在训练过程中自发形成的、未在奖励函数中明确规定的复杂策略。在强化学习中,当智能体面对丰富的环境动态和足够的探索时,可能发现一些人类设计者未曾预料的优化策略。Cabo智能体学会的“故意输掉回合以重置分数”就是一个典型例子:它利用游戏规则中总分达到100重置为50的机制,通过精确计算当前手牌和惩罚分,主动选择输掉当前回合以换取长期优势。这种行为表明智能体不仅学会了短期得分,还理解了游戏的长远状态转移。
类似的,精准换牌和故意配对也体现了对对手信念和牌堆分布的建模能力。这些策略的涌现依赖于信念头提供的隐藏牌预测,以及足够的训练时长。然而,涌现行为也可能包括不受欢迎的冒险行为,如盲换多换中的风险暴露。分析这些行为有助于理解智能体的决策逻辑,并指导奖励塑形和网络设计的改进。
尝试过但未奏效的方法
开发者坦诚分享了几条失败路径:
- 确定性 rollout 的前瞻搜索:只有在把价值头替换为胜率查找表(因为折扣价值有偏)且仅在显著性足够(z > 2)时才覆盖策略,才带来帮助。
- 在搜索标签上做专家迭代:效果反而更差(48% vs 基线),因为标签太少且噪声太大。
智能体仍然会在未知牌的盲换多换中冒险(失败时会暴露两张牌),偶尔也会在第一个回合就用已知的低对子叫牌。
下一步与开放问题
开发者计划将网站上人类玩家的每一局匿名存储(种子+移动,服务器端回放验证),用来评估智能体对人类的表现并进行微调。他特别希望获得关于如何突破平台期的建议:是增加对局时的搜索、采用种群训练,还是设计更聪明的信念状态表示?
这个项目展示了在消费级硬件上训练复杂卡牌游戏AI的可行性,也为隐藏信息博弈的研究提供了一个可复现的轻量级基线。
相关推荐
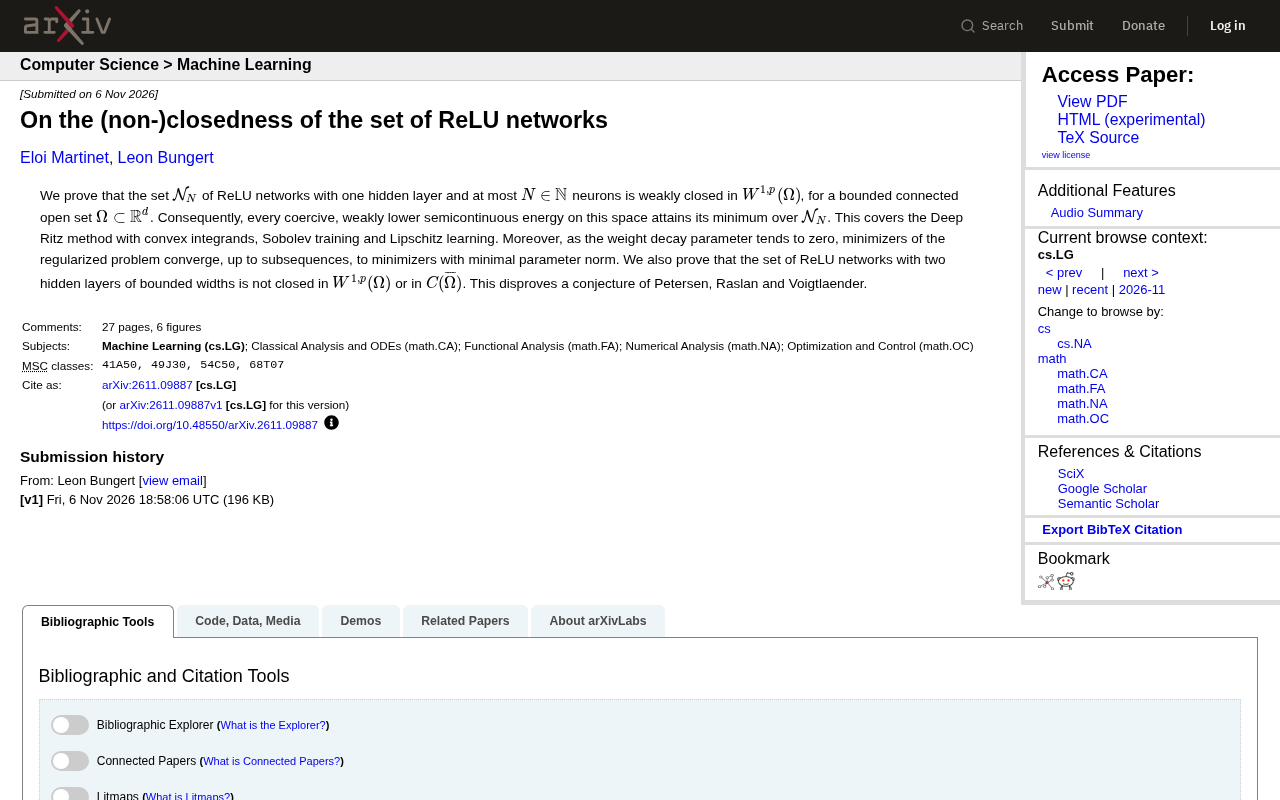
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
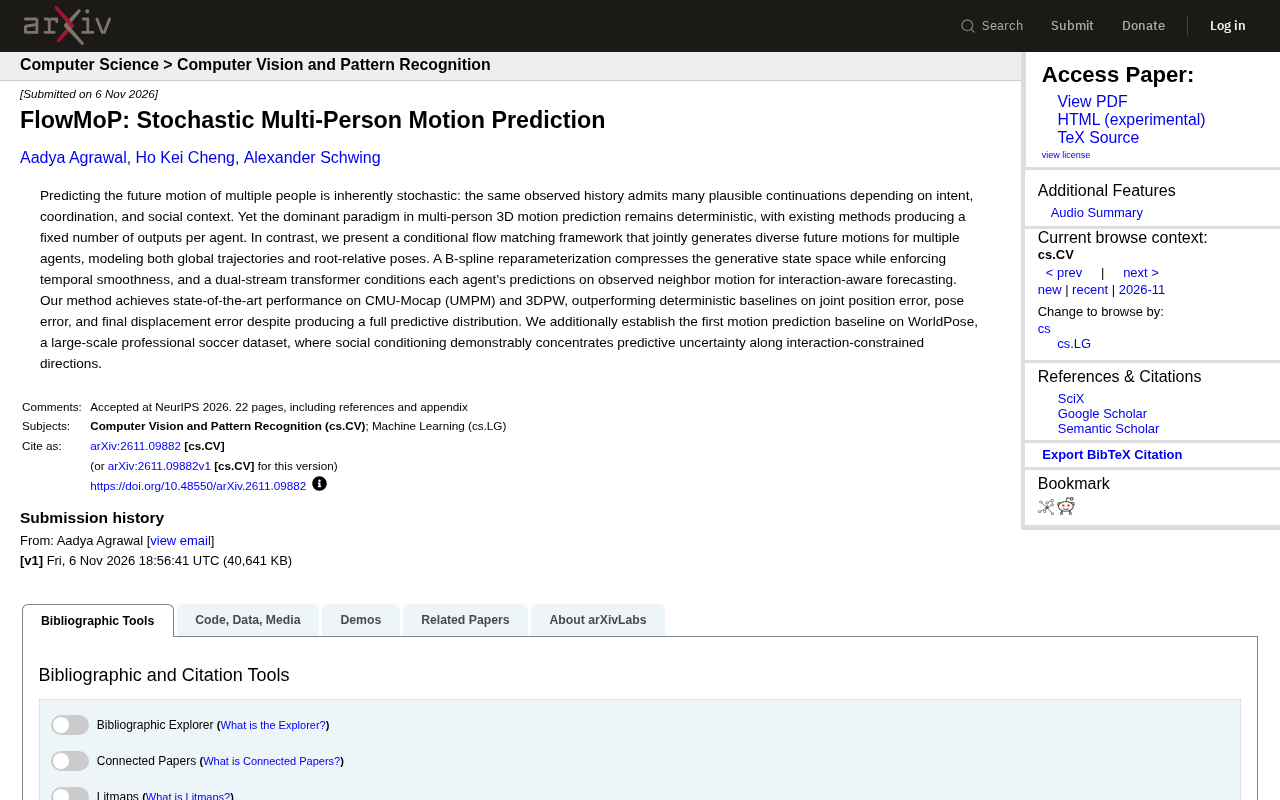
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
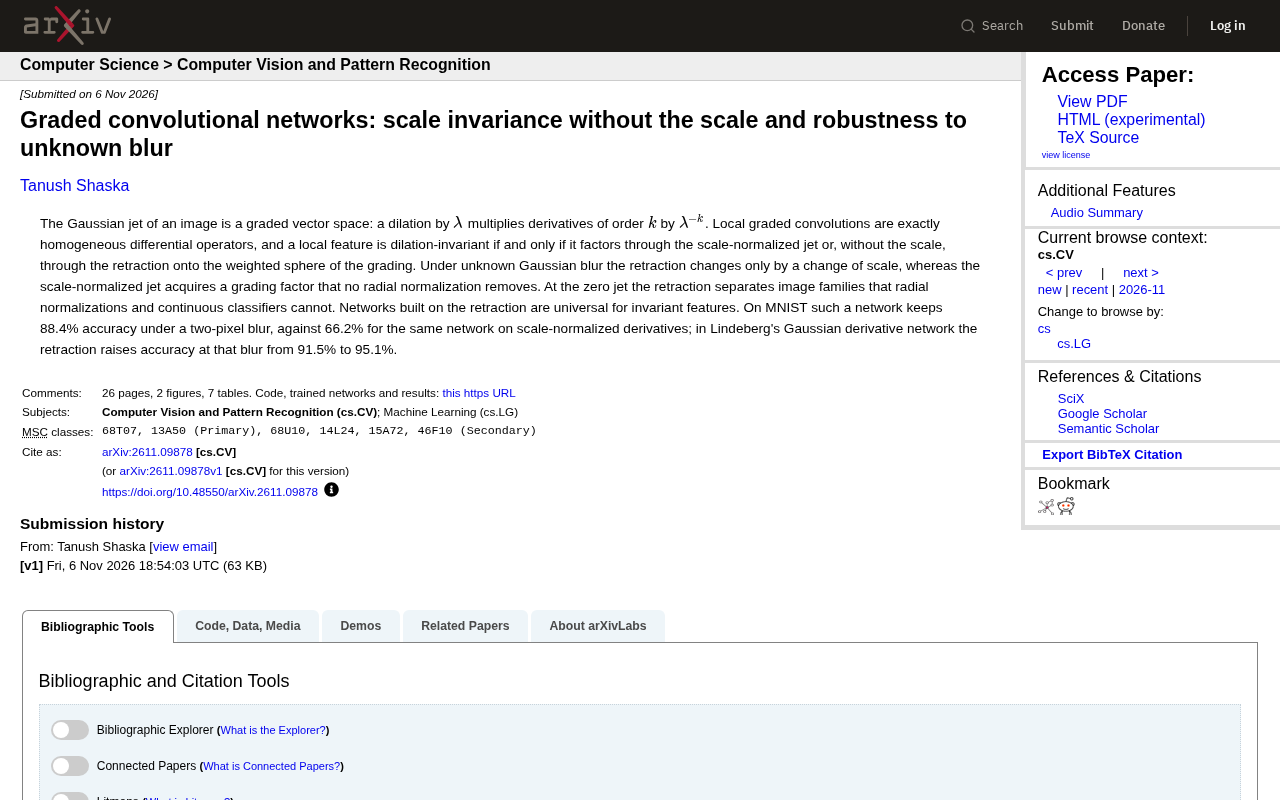
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。