Mac跑本地AI到底多快?M1到M6芯片真实横评

M后面的数字不决定AI速度,内存带宽才是关键,4年前的M1 Max在日常场景仍可碾压新芯片。
在本地运行大模型时,芯片承担两种性质截然不同的任务:预填充(读提示词)拼算力,解码(写答案)拼内存带宽。流行的「阶梯跑分图」只建模了前者,导致大众以为新芯片全面碾压老芯片——但实测写入速度中,2021年的M1 Max(400GB/s带宽)比2024年的M4 Pro(约200GB/s)快将近一倍。评估一台用于本地AI的Mac,正确优先级是内存容量第一、带宽第二、代际第三。M5是第一个因Neural Accelerator带来预填充速度真实飞跃的世代,适合Agent工作流;但普通聊天场景下,一台64GB二手M1 Max MacBook Pro的性价比可能远超同价位新机。此外,仅靠切换推理引擎或开启投机解码,同芯片性能最高可提升六倍,往往比换芯片更划算。
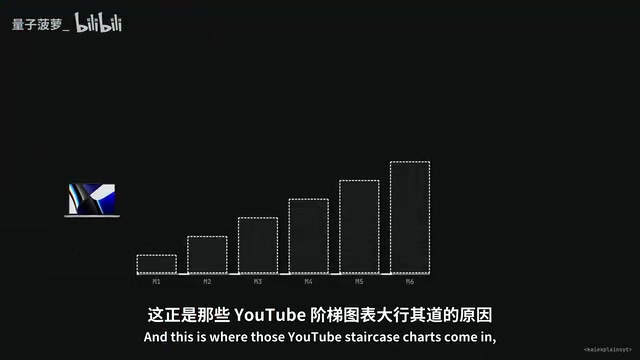
那些 YouTube 封面上的「阶梯图」我们都见过——每一代新 Mac 芯片都比上一代高一截,而底部那台老旧的 Mac mini 或 MacBook Pro 显得格外寒酸。B 站 UP 主 Kai 也曾被这种图说服过,差点觉得自己 2021 年的 M1 Max 已经是「恐龙级硬件」。但当他真正把跑分数据摆上桌面后,却发现了一个令人意外的结论:在某些场景下,四年前的 M1 Max 反而比全新的芯片更快。
这篇文章拆解的核心,就是那些阶梯图「只讲了一半故事」的真相——而被隐藏的那一半,恰恰是你坐在桌前等 AI 回复时真正在意的部分。
本地跑 AI,芯片其实在干两件完全不同的事
理解整件事的关键,在于本地运行大模型时,芯片承担着两个速度上限截然不同的任务。
第一个任务叫 pre-fill(预填充),也就是「读取你的提示词」。当你输入问题、粘贴文档时,芯片必须一次性读完所有内容才能开始回答。这是海量的并行计算,算力单元越多越快。
第二个任务叫 decode(解码),即「逐字写出答案」。模型一次生成一个 token,这里的瓶颈根本不是算力,而是一个更「无聊」的指标——内存带宽,也就是数据从内存里被搬出来的速度。
原因在于:每生成一个 token,Mac 都要把整个模型从内存里完整读取一遍过一遍 GPU。以一个 4-bit 量化、约 16GB 的模型为例,每写一个词就相当于一次 16GB 的「内存往返」。当这个动作每秒发生几十次时,内存带宽就成了天花板。
我们甚至可以自己算出这个上限:用芯片带宽除以模型大小。全新 M6 Mac mini 的带宽是 170GB/s,170÷16 ≈ 10.6 tokens/s;而 M1 Max 的带宽高达 400GB/s,400÷16 ≈ 25,实测也有 19.8 tokens/s。同样的算法,M1 Max 几乎是 M6 的两倍。这不是因为苹果把东西做差了,而是 M6 为另一种任务做了优化。
Token 是大语言模型处理文本的基本单位,大致可以理解为「词片段」——英文中一个单词通常对应 1–2 个 token,中文因编码方式不同,一个汉字往往对应 1–2 个 token。100 个中文汉字大约折合 150–200 个 token。tokens/s(每秒 token 数)是衡量模型生成速度的核心指标:人类正常阅读速度约为 5–8 tokens/s,低于这个数字会让人明显感到「在等」,高于 15 tokens/s 则通常感觉流畅。4-bit 量化是一种将模型权重从原始的 16 位或 32 位浮点数压缩为 4 位整数的技术,可将模型体积缩减约 75%,代价是精度略有损失,但在大多数实际任务中效果下降微乎其微,是目前本地部署中最常见的压缩方案。
阶梯图的陷阱:公式推算 vs 真实跑分
Kai 发现,最流行的那张对比图是用公式推算出来的,而非在真实硬件上实测——创作者本人也坦诚承认,毕竟没人能买齐所有 Mac。但这意味着那张图只建模了「读取速度」这一个维度。
阶梯图显示 M1→M2→M3→M4→M5→M6 一代比一代快,这对「读提示词」确实成立。但一旦换成「写答案」的真实实测,阶梯就彻底乱套了。
在 llama.cpp 项目 GitHub 上有一个由真实 Mac 用户维护的跑分线程,所有人用相同模型、相同软件版本运行并上传结果。按写入速度排序后:2021 年的 M1 Max 写入 61 tokens/s,而三代之后的 2024 M4 Pro 只有 51 tokens/s——老芯片更快;M1 Ultra 几乎与 M4 Max 打平;甚至出现了「倒退」,M3 Pro 被 M1 Max 甩在身后。
带宽不是一个「上得了发布会」的性能数字。「我们的新芯片内存带宽略高」远不如「快 13.5 倍」有卖点,但带宽才是决定你日常使用中 AI「感觉快不快」的那个数。
同名不同芯:你买到的是「快 Max」还是「慢 Max」?
更隐蔽的陷阱是:同一个芯片名字可能是两颗完全不同的芯片。
Kai 在对比 Max 芯片时吃了亏:M4 Max 的带宽可能是 410GB/s,也可能是 546GB/s,盒子上写的名字一模一样,而便宜那颗写入速度慢约四分之一。M5 Max 同样有 460 和 414 两个版本。大多数评测视频根本不说自己测的是哪一款。
M6 则在内存上玩了类似的把戏:16GB 版 M6 带宽只有 153GB/s,和去年的 M5 完全一样,只有升级到 24GB 以上才会跳到 170GB/s。换句话说,苹果宣称的「比 M5 快 10%」,只有在你已经付钱升级之后才成立;基础配置就是「花 M6 的钱买 M5 的速度」。
还有一个坑:32 核的 M4 Max 和 M5 Max 最高只能配 36GB 内存,而一台售价 2499 美元、badge 上印着 Max 的机器,根本装不下一个 4-bit 的 27B 模型。所以每当有人发 Max 跑分,第一个问题永远应该是:这是哪个 Max?
M5 的真实飞跃:Neural Accelerator
听到这里你可能觉得新芯片对本地 AI 简直是「智商税」,但这也不全对。有一次真正的飞跃确实发生了,那就是 M5。
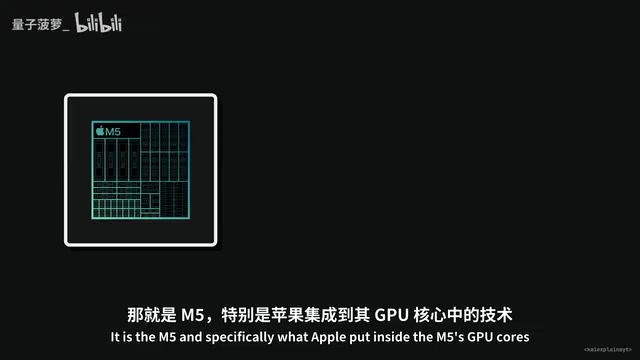
苹果在 M5 的 GPU 核心里加入了一个叫 Neural Accelerator 的矩阵运算单元,它戏剧性地改变了「读取速度」。在同一个 llama.cpp 线程里,M4 Max 读取提示词的速度是 886 tokens/s,而 M5 Max 达到 3220 tokens/s——快了 3.6 倍。这虽然不是苹果幻灯片上精心挑选的「13.5 倍」,但在相同软件下仍是实打实的巨大提升。
有意思的是:如果用 2023 年的旧版 llama.cpp 跑 M5 Max,读取速度只有约 990 tokens/s,几乎和 M4 Max 一样。Neural Accelerator 需要「知道它存在」的软件才能发挥作用——就像你有辆跑车却只用三档,因为没人告诉你还有更高的档位。
但写入速度从 M4 Max 到 M5 Max 只提升了 25%,这纯粹是带宽的功劳。苹果自己的机器学习团队也在论文里写明:文本生成的代际提升受限于内存带宽。所以诚实的结论是:提示词很长(数千 token)时,M5 是第一款让你明显感到响应变快的芯片;但如果提示词短、你在意回答速度,老 Max 依然很能打。
AI Agent:真正改变结论的场景
有一个场景彻底改变了 Kai 对这场争论的看法——AI Agent(智能体)。
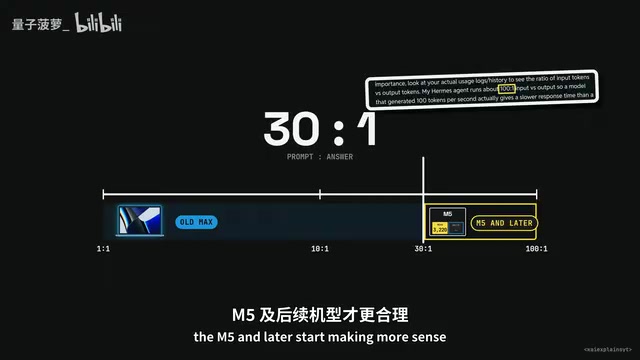
Agent 是把多次 AI 调用串联起来的工作流,模型会调用工具、读文件、运行代码。它们每次调用都会把整个上下文(指令、所有工具输出、对话历史)一次性发送出去,可能在你还没打一个字之前就已经有 3 万个 token。
有用户实测:在 M1 Max 上跑 27B 模型,一个 3.2 万 token 的提示词,要等超过 500 秒才吐出第一个字——那是 8.5 分钟,够去泡杯咖啡回来。而在 M5 Max 上不到一分钟,配合优化软件甚至 40 秒。
反过来说,普通聊天场景里老芯片仍占优:一个 1000 token 问题 + 500 token 回答,M1 Max 约 10 秒,基础版 M5 要 17 秒——四年前的芯片快了 70%。临界点大约在「每个回答 token 对应 30 个提示词 token」:低于这个比例老 Max 赢,高于它 M5 及以后才更划算。
上下文窗口(Context Window)是模型在单次推理时能「看到」的最大 token 数量。Agent 工作流之所以会积累数万 token,是因为它需要把所有已发生的交互记录(工具调用结果、代码执行输出、中间推理步骤)全部塞进这个窗口,让模型在每一步都能看到完整的「操作历史」。这与普通聊天有本质区别——普通聊天的提示词通常只有几百到几千 token,而一个运行了十几轮工具调用的 Agent,上下文可能轻松突破 3 万 token。正是这个差异,导致预填充速度(而非解码速度)成为 Agent 场景的真正瓶颈,也是文中「老 M1 Max 在聊天场景反而更快,但在 Agent 场景大幅落后」这一结论的根本原因。
评估 Mac 的正确顺序:内存 > 带宽 > 代际
有一个指标比带宽和代际都更重要,却从没被图表放在第一位——那就是内存。
任何一代的 16GB Mac,能给 GPU 使用的只有约 12.7GB。而一个 4-bit 的 27B 模型就是 16GB,还没加任何上下文就已经装不下了。如果有人给你看 16GB Mac 跑 27B 模型的跑分,那要么跑得极慢,要么数据本身就是错的。
24GB 勉强能装进去但几乎没有余量,32GB 才算日常可用,64GB 才真正好用。所以评估一台用于本地 AI 的 Mac,正确顺序是:内存第一,带宽第二,代际第三——而几乎所有图表都反着来。
软件差距:可能比换芯片更划算
最让 Kai 意外的发现是:同芯片、同模型下,仅靠软件带来的性能差距极其惊人。
在 M6 上,原生 MLX 约 9 tokens/s,切换到多 token 预测可达 16–19,一个叫 Splash 的引擎在短提示词上甚至跑到 52 tokens/s——纯软件就是六倍差距。
最大的提升来自投机解码(speculative decoding):用一个小的草稿模型提前猜几个 token,大模型一次性验证。如果猜中,16GB 的往返就能产出 4–5 个 token。有 M5 Max 实测到 144 tokens/s,远超约 38 的理论天花板。
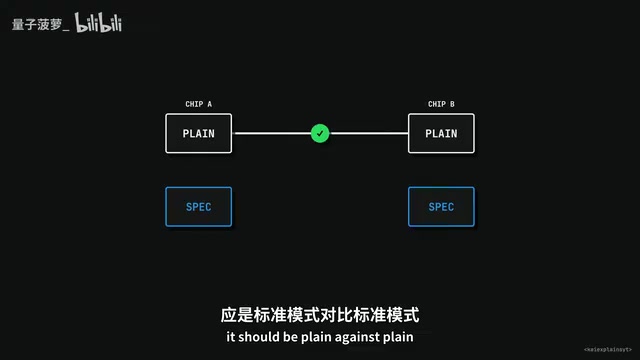
但命中率完全取决于你问什么:有 M1 Max 用户在代码任务上命中率 94%,散文却只有 19%。而在内存受限的小芯片上,投机解码反而可能更慢——一位 M5 MacBook Air 用户打开后从 7.4 掉到了 3 tokens/s。所以对比跑分时必须「原生对原生、投机对投机」,绝不能交叉比较。
投机解码(Speculative Decoding) 的原理值得多说一句。传统解码每次只生成一个 token,每生成一个就要完整读取一遍大模型权重——这是内存带宽成为瓶颈的根源。投机解码引入一个体积极小(通常是主模型的 1/10 甚至更小)的「草稿模型」,它先快速猜出接下来 4–8 个 token,然后大模型对这批候选 token 做一次并行验证。验证本身是并行计算,消耗的算力远少于逐字生成,却能一次「确认」多个 token。如果草稿模型猜中了,就相当于用一次内存读取换来了多个 token 的产出,有效带宽利用率成倍提升。猜错的 token 会被丢弃,但不会导致输出错误——大模型的验证保证了结果的准确性。这也解释了为什么命中率对最终速度影响如此之大:代码任务中词汇重复性高、规律强,草稿模型容易猜中;而散文写作的表达方式千变万化,命中率自然断崖式下跌。
结论:别再只看 M 后面的那个数字
Kai 的建议相当直接:
- 如果你做编程 Agent(真正的智能体工作流,频繁调用工具、循环几十次),M1 Max 确实不合适,差距很大。1699 美元的 M5 Pro Mac mini 读提示词速度是 M1 Max 的两倍多,写入速度相当,这才是该用的升级。
- 如果主要是聊天、写作、单条编程问答、文档总结、创意工作,有人花约 1200 美元买了台 64GB 的二手 M1 Max MacBook Pro——带宽是 1299 美元 32GB M6 Mac mini 的 2.35 倍,更多内存、更快写入、更便宜。它唯一的短板是啃 3 万 token 长提示词慢,而对大多数人来说这从来不是瓶颈。
一句话:别再只盯着「M 后面的数字」,那只告诉你芯片大概有多少计算单元,却是预测日常 AI 响应速度最不准的指标。先看内存,再看带宽(以及具体是哪颗芯片),最后才看是否 M5 及以后。而在掏钱之前,先换个更好的推理引擎——软件带来的提速是真实、巨大且免费的。
最新的 Mac,往往只是在「你可能根本不做的那件事」上更快而已。
相关推荐
98%家庭不付费AI:消费级AI到底是机会还是幻觉?
a16z最新报告显示全美仅2.2%家庭为AI付费,顶级1%用户支出相当于后50%总和。本文深度解析消费级AI应用榜单、大模型格局、企业采购变化,以及"消费者永不付费"的核心辩论与破局路径。

用Codex做生产监控:Grafana、K8s与安全全链路自动排障
基于 OpenAI Codex 的实战演示,拆解如何用 agentic 工作流处理 Grafana 指标异常、Kubernetes 级联故障和安全资源耗尽三类生产故障,把排障时间从一小时压缩到几分钟,并探讨从人在回路到全自动闭环的落地路径。

Cornerstone OnDemand如何用Amazon Bedrock将数据库诊断效率提升78%
Cornerstone OnDemand基于Amazon Bedrock和Strands Agents构建多智能体系统Orion AI,仅用三人团队在六个月内将数据库诊断时间缩短78%,从45分钟降至10分钟。本文解析其架构设计与可复用经验。