Maestro:全局协调破解Lean证明失败难题

Maestro用全局协调器让Lean证明器报告失败原因,从而全局重规划,显著提升形式化证明成功率。
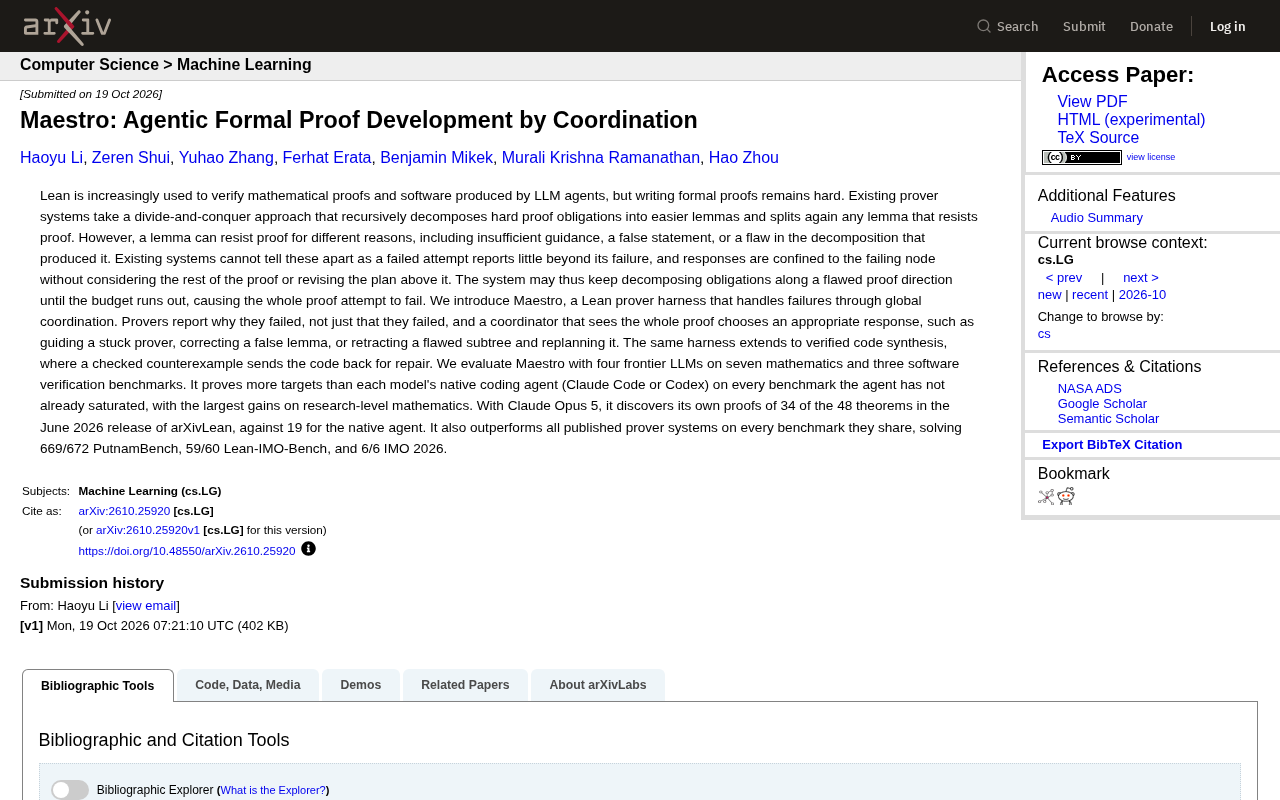
文章介绍了Lean形式化证明器框架Maestro。现有证明器采用分而治之策略,但失败时只返回“失败”信号,无法区分是缺少引导、命题为假还是拆分方式有缺陷,导致系统只能在失败节点内局部响应,沿错误方向耗尽预算。Maestro的核心是让证明器报告失败原因,并由一个能看到完整证明树的协调器统一调度:补充引导、纠正错误引理、或撤回有缺陷的子树重新规划;同一机制也适用于经过验证的代码合成。在四个前沿LLM和十个基准上的评估显示,Maestro在所有未饱和基准上都优于原生编码代理,研究级数学提升最大,例如Claude Opus 5下arXivLean自主证明34/48,而原生代理仅19/48。
形式化证明正成为验证LLM生成数学证明与代码的重要手段,但用Lean写证明依然困难重重。传统证明器采用分而治之策略,把复杂证明义务递归拆成更简单的引理,一旦某个引理卡住就继续拆分。问题在于,引理失败的原因可能截然不同——缺少引导、命题本身为假、或者拆分方式有缺陷——而现有系统只能看到“失败”这一结果,无法区分原因,更无法跳出失败节点去审视整个证明计划。Maestro的提出正是为了解决这一根本性缺陷。
失败信息贫乏导致证明方向跑偏
现有证明器的核心痛点不是算力不够,而是失败反馈太单薄。一个引理无法证明时,系统只得到“失败”信号,既不知道是证明器需要更具体的提示,还是这个引理本身就是错的,抑或是上游拆分方式有问题。由于响应被限制在失败节点内部,系统无法回头修订上层计划,只能沿着可能有缺陷的证明方向继续拆解,直到预算耗尽,整个证明尝试随之崩盘。这种“局部响应、全局失明”的模式,在困难问题上尤其致命。
Maestro的思路是让证明器在失败时报告“为什么失败”,而不仅仅是“失败了”。这一改变看似简单,却把原本封闭的失败信号变成了可供协调器决策的信息源。
Lean与形式化证明的基本概念
Lean是一种交互式定理证明器(interactive theorem prover),同时是一门依赖类型论(dependent type theory)的编程语言。在Lean中,数学命题被表述为类型,而该命题的证明则是这个类型的项(term)。证明器的工作就是构造出这个项,一旦构造成功,内核(kernel)会独立检查其正确性,因此形式化证明具有极高的可信度。Lean 4及配套的数学库Mathlib已成为形式化数学的事实标准,arXivLean、PutnamBench等基准正是构建在其之上。
分而治之的证明策略
传统自动证明器面对复杂目标时,通常采用“分解”(decomposition)策略:把一个大证明义务拆成若干更小的引理(lemma),先证明这些子引理,再组合起来。这种策略对应了数学中常见的“引理—定理”结构,但当某个子引理无法证明时,系统缺乏对失败原因的诊断能力。由于每个证明器实例只看到自己的局部目标,它无法判断失败是源于自身能力不足,还是上游的分解本身就不合理,这正是“局部响应、全局失明”的根源。
Agentic证明与协调器
Agentic(代理式)证明指的是让LLM作为自主代理,在证明环境中调用策略(tactic)、引理搜索等工具,迭代地推进证明。与单次生成不同,代理式方法允许模型观察环境反馈并调整策略。Maestro的协调器(coordinator)是一种元层代理:它不直接写证明,而是维护整棵证明树的结构化表示,接收来自各子证明器的失败报告,并据此决定下一步动作。这种“协调器—证明器”的分层架构,把全局规划与局部搜索解耦,使得失败信息能够跨层级流动。
协调器如何全局调度证明过程
Maestro是一个Lean证明器框架,核心是一个能看到完整证明树的协调器。当某个证明器报告失败原因后,协调器根据全局状态选择应对方式:给卡住的证明器补充引导、纠正错误的引理、或者撤回有缺陷的子树并重新规划。这三种响应分别对应了失败的三类根因,避免了过去“一刀切继续拆分”的盲目性。
这套机制同样延伸到经过验证的代码合成场景。当检查器给出反例时,代码会被送回修复,而不是在错误的路径上反复尝试。协调器在这里扮演的角色,本质上是一个掌握全局信息的调度中枢,让每个局部失败都能被放到整体计划中重新评估。
基准测试:研究级数学提升最显著
研究团队用四个前沿LLM在七个数学和三个软件验证基准上评估了Maestro。在原生编码代理(Claude Code或Codex)尚未饱和的每一个基准上,Maestro都证明出更多目标,其中研究级数学的提升幅度最大。
具体数据相当有说服力。使用Claude Opus 5时,Maestro在arXivLean的2026年6月版本中自主发现了48个定理里34个的证明,而原生代理只做到19个。在与已发表证明器系统共享的基准上,Maestro全面胜出:PutnamBench解决669/672,Lean-IMO-Bench解决59/60,IMO 2026达到6/6。这些结果说明,全局协调带来的收益并非局限于某一类问题,而是在数学与软件验证两个方向上都成立。
几个基准的含义
PutnamBench收录的是威廉·洛厄尔·普特南数学竞赛(Putnam Competition)的题目,该竞赛以难度高、需要巧妙构造著称,是衡量自动定理证明能力的经典基准。Lean-IMO-Bench则来自国际数学奥林匹克(IMO)试题的形式化版本,侧重初等但需要创造性洞察的证明。arXivLean是从arXiv数学论文中提取定理并形式化得到的基准,属于研究级数学,其难度和背景知识要求远高于竞赛题,因此在这一基准上的提升最能体现方法的泛化能力。IMO 2026指2026年国际数学奥林匹克试题的形式化集合。
Pass@k与自主证明率
这类基准通常报告“解决了多少题”,即证明器在给定预算内成功完成形式化证明的目标数量。所谓“自主发现证明”,指的是系统在没有人工提供证明草图或关键引理的情况下,独立搜索出完整证明。与已发表证明器系统共享的基准上的对比,排除了题目选择带来的偏差,使Maestro的优势更具说服力。
协调式证明的启示
Maestro的价值不止于刷新基准数字。它揭示了一个更普遍的设计原则:当失败原因可以被结构化地表达出来,系统就能从“盲目搜索”转向“有依据的调度”。这一思路对依赖LLM进行形式化验证的工作流有直接借鉴意义——无论是数学定理证明还是经过验证的代码合成,失败都不应只是一个终止信号,而应是触发全局重规划的信息入口。
从工程角度看,Maestro没有重新发明证明器,而是在现有证明器之上加了一层协调逻辑,用信息流动的改善换取了搜索效率的提升。这种“不改内核、改协作”的路径,对于构建更可靠的AI辅助形式化工具链,可能比单纯堆叠模型能力更具可持续性。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。