MapReduce思想用于AI代码清理:一种新的Agent协作范式
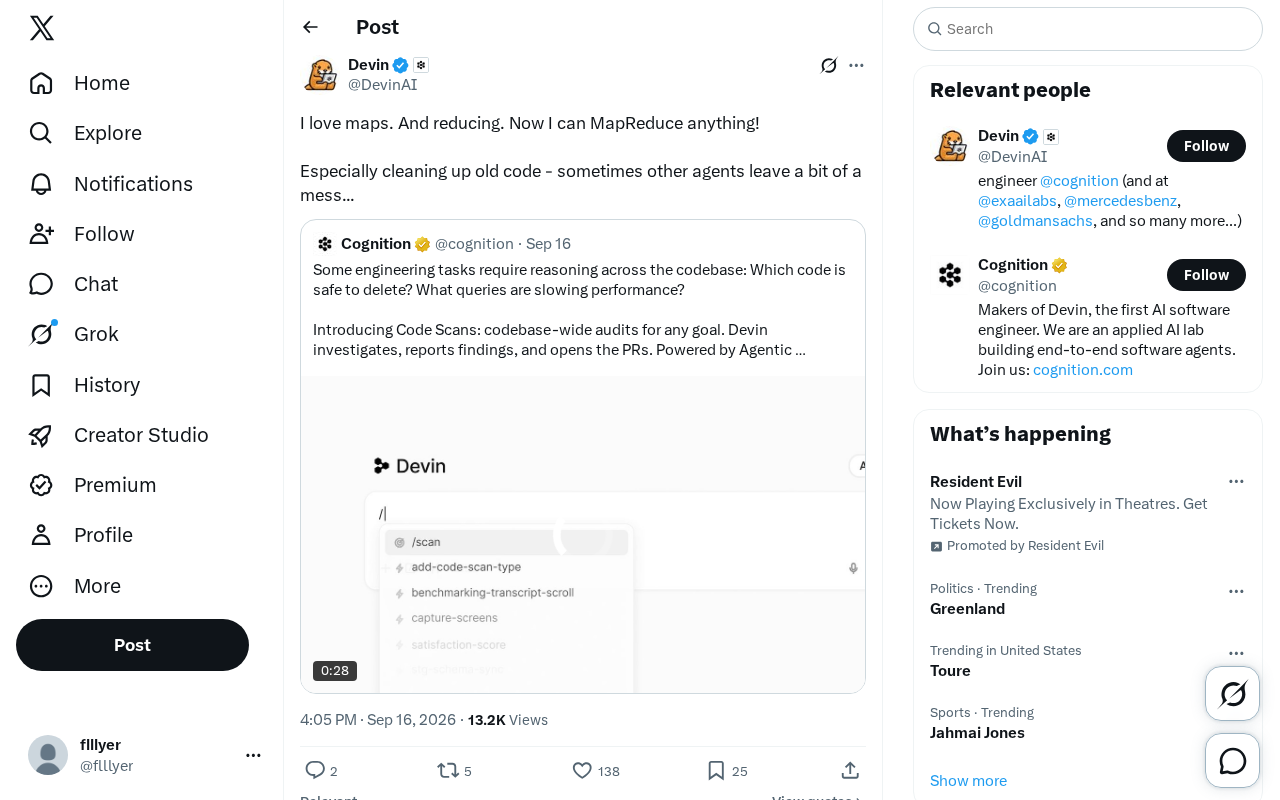
开发者将MapReduce分治范式迁移至AI Agent代码清理工作流,以应对多Agent协作带来的代码治理难题。
一条开发者社区的分享揭示了一个新兴工程实践:将经典的MapReduce"分而治之"思想应用于AI Agent的代码清理工作。随着AI编程助手大规模介入开发流程,由不同Agent在不同上下文中生成的代码日益积累,风格不统一、冗余实现、遗留调试痕迹等技术债务问题随之涌现,而单个Agent受限于上下文窗口,无力独自处理庞大代码库。MapReduce式方案将代码库拆分为独立片段并行清理(Map阶段),再汇总做全局一致性对齐(Reduce阶段),有效规避了上述限制。这一实践折射出AI编程正从"单点生成"迈向"多Agent协作与元治理"的行业趋势,同时也面临切分粒度难以确定、Reduce阶段合并复杂度高等现实挑战,建议在小范围试点后谨慎推广。
从MapReduce到AI代码治理
一条来自开发者社区的简短分享引发了不少关注:"I love maps. And reducing. Now I can MapReduce anything!" 这句略带调侃的话背后,其实指向了一个正在兴起的工程实践——把经典的 MapReduce 分治思想应用到 AI Agent 的代码清理与维护工作中。
MapReduce 本是分布式计算领域的经典范式,核心是"分而治之":先把大任务拆分(Map)成若干独立的小任务并行处理,再把结果汇总(Reduce)成最终答案。这套思路最初用于处理海量数据,如今被开发者创造性地迁移到了 AI 编程助手的工作流中。
MapReduce 最初由 Google 在 2004 年的论文中提出,并在 Hadoop 等开源框架中得到广泛实现。其核心抽象简洁而强大:Map 函数将输入数据转换为键值对,Reduce 函数对相同键的值进行聚合计算,两个阶段之间由框架自动完成数据的排序与分发。这一模型之所以经久不衰,在于它将"如何并行"的复杂性隐藏在框架内部,让开发者只需描述"做什么"。当这套思路被迁移到 AI Agent 工作流时,其精髓被保留了下来:用 Map 的并行分治来突破单个 Agent 的上下文限制,用 Reduce 的汇总聚合来恢复全局一致性。这种迁移并非简单类比,而是把一个在数据处理领域验证了二十年的工程原则,应用到了一个新兴的、同样面临"规模爆炸"问题的领域。
为什么代码清理需要MapReduce
这条分享中最值得玩味的一句是:"Especially cleaning up old code - sometimes other agents leave a bit of a mess..."(尤其适合清理老代码——有时候其他 Agent 会留下一堆烂摊子)。
这句话点出了当前 AI 辅助编程的一个真实痛点。随着越来越多团队引入 AI 编程 Agent 参与开发,代码库里开始出现由不同 Agent、在不同上下文下生成的代码。这些代码往往:
- 风格不统一,缺乏一致的命名与结构约定
- 存在冗余实现,同一功能被重复造轮子
- 遗留了调试痕迹、无用注释或临时方案
- 缺乏对整体架构的全局理解
单个 Agent 由于上下文窗口有限,很难一次性理解并清理一个庞大的代码库。这正是 MapReduce 思路的用武之地。
上下文窗口(Context Window)是当前大语言模型的核心限制之一,指模型在单次推理中能够"看到"的最大文本量。主流编程助手的上下文窗口通常在数万到数十万 token 之间,对于一个中等规模的工程项目(数十万行代码)而言远远不够。这意味着单个 Agent 无法一次性理解整个代码库的结构、依赖关系与历史演变,在执行重构或清理任务时极易产生"局部合理、全局破坏"的修改。此外,不同 Agent 在不同会话中生成的代码,由于缺乏共享的"记忆"与约定,天然存在风格漂移(Style Drift)问题——这与分布式团队协作中的代码一致性挑战高度相似,因此借用分布式系统的治理思路来应对,具有内在的合理性。
MapReduce式代码清理的工作机制
将这一范式落地到代码清理,大致可以拆解为两个阶段:
Map阶段:分片并行处理
把庞大的代码库按模块、文件或功能单元切分成多个独立片段,每个片段交给一个 Agent 实例并行处理。每个 Agent 只需专注于自己负责的那一小块,比如识别死代码、统一格式、修复明显的坏味道。这样既规避了单个 Agent 上下文长度的限制,也大幅提升了处理效率。
Reduce阶段:汇总与一致性对齐
各分片处理完成后,进入 Reduce 阶段,将局部清理结果合并,并在全局层面做一致性检查——例如确保跨模块的接口调用没有被破坏、命名约定在整个项目中保持统一、重复实现被合理归并。这一步是保证"局部最优"能够拼接成"全局可用"的关键。
这一实践反映的行业趋势
这条看似轻松的分享,实际折射出 AI 编程正在从"单点生成"走向"多Agent协作与治理"的阶段性变化。
第一层信号是:AI 生成代码的规模正在快速膨胀,随之而来的是技术债务问题。当机器生成代码的速度远超人工审查的速度,如何系统性地维护代码质量成为新课题。
第二层信号是:开发者开始把成熟的分布式系统思想反哺到 AI 工作流设计中。MapReduce、流水线、消息队列这些工程范式,正在被重新诠释为组织多个 AI Agent 协同工作的框架。
第三层信号是:"Agent 清理 Agent 留下的烂摊子"这一场景本身,说明 AI 编程生态已经进入需要"元治理"的阶段——不仅要用 AI 写代码,还要用 AI 来管理和纠正 AI 产出的代码。
"元治理"(Meta-governance)概念在 AI 工程语境中指的是:用一套系统或流程来监督、纠正和协调其他 AI 系统的产出,而非直接由人工完成所有审查工作。这一需求的出现标志着 AI 辅助开发进入了新的成熟阶段。早期,AI 编程工具主要作为单点加速器存在,其产出由人工直接审查。但随着 AI 生成代码的比例在部分团队中已超过总提交量的 30%-50%,纯人工审查在速度和规模上都开始力不从心。元治理的思路是构建分层的质量保障体系:第一层 Agent 负责生成,第二层 Agent 负责审查与规范化,人工则聚焦于策略制定与最终兜底。这与传统软件工程中 CI/CD 流水线自动化测试的演化路径高度相似——自动化不是替代人的判断,而是把人的精力解放到更高价值的决策层面。
需要理性看待的局限
必须指出,这条分享来自社交媒体的个人实践分享,属于单一来源的经验之谈,缺乏系统的数据验证和方法论细节。将 MapReduce 应用于代码清理仍面临几个现实挑战:
- 切分粒度难以确定:代码模块之间往往存在耦合,简单按文件切分可能割裂上下文
- Reduce阶段的复杂度:合并局部修改并保证全局正确,本身就是一个难题
- 质量把关:AI 清理后的代码仍需人工复核,避免"越清理越乱"
对于希望尝试这一思路的团队,建议先在小范围、低风险的代码模块上试点,验证效果后再逐步推广,同时保留完善的版本控制与回滚机制。
结语
把 MapReduce 这样的经典计算范式迁移到 AI Agent 协作场景,是一个既有趣又务实的方向。它提醒我们,AI 时代的软件工程并非要抛弃过往积累,而是要在新的工具语境下重新激活那些经过时间检验的工程智慧。当 AI 写代码的能力越来越强,如何治理和维护这些代码,可能才是真正决定生产力的关键。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。