MCP Memory:用SQLite打造轻量级AI智能体记忆方案

智能体为何需要"记忆"
随着大语言模型(LLM)从单轮问答走向多轮、长期的智能体(Agent)应用,一个核心痛点日益凸显——模型没有持久记忆。每次对话结束,上下文便烟消云散。为了让 AI 智能体能够记住用户偏好、历史交互和关键事实,业界涌现出各种"记忆层"方案,其中大多依赖向量数据库和昂贵的嵌入(embedding)计算。
大语言模型本质上是无状态的函数:给定输入 token 序列,输出概率分布下的下一个 token。模型的"记忆"完全依赖于上下文窗口(context window)中的内容。虽然近年来上下文窗口从 GPT-3 的 4K token 扩展到 Claude 的 200K 甚至 Gemini 的百万级 token,但这仍然是一种"工作记忆"而非"长期记忆"。每次会话结束,这些信息便不再可用。
更重要的是,上下文窗口越长,推理成本越高。标准 Transformer 架构中的自注意力(Self-Attention)机制需要计算序列中每个 token 与所有其他 token 的注意力权重,其计算复杂度与序列长度呈二次关系(O(n²))。具体而言,对于长度为 n 的序列,注意力矩阵需要 n² 次点积运算和 n² 个存储单元。虽然业界已发展出多种优化技术——如 FlashAttention 通过分块计算和 IO 感知减少显存访问次数、KV Cache 通过缓存已计算的键值对避免重复计算、以及稀疏注意力(Sparse Attention)和线性注意力(Linear Attention)等架构变体——但这些优化只是降低了常数系数或改变了特定操作的效率,并未从根本上解决"将全部历史装入上下文"的经济性问题。以 GPT-4 为例,128K 上下文的输入成本约为 $10/百万 token,如果每次交互都将完整历史注入上下文,对于长期运行的智能体,月度成本将极为可观。
这就是为什么智能体需要外部记忆系统——在适当时机检索相关信息注入上下文,而非始终携带全部历史。这种设计模式在认知科学中有对应概念:人类大脑区分工作记忆(前额叶皮层,容量约 7±2 个组块)和长期记忆(海马体与新皮层),智能体的上下文窗口对应工作记忆,而外部记忆系统对应长期记忆的检索机制。
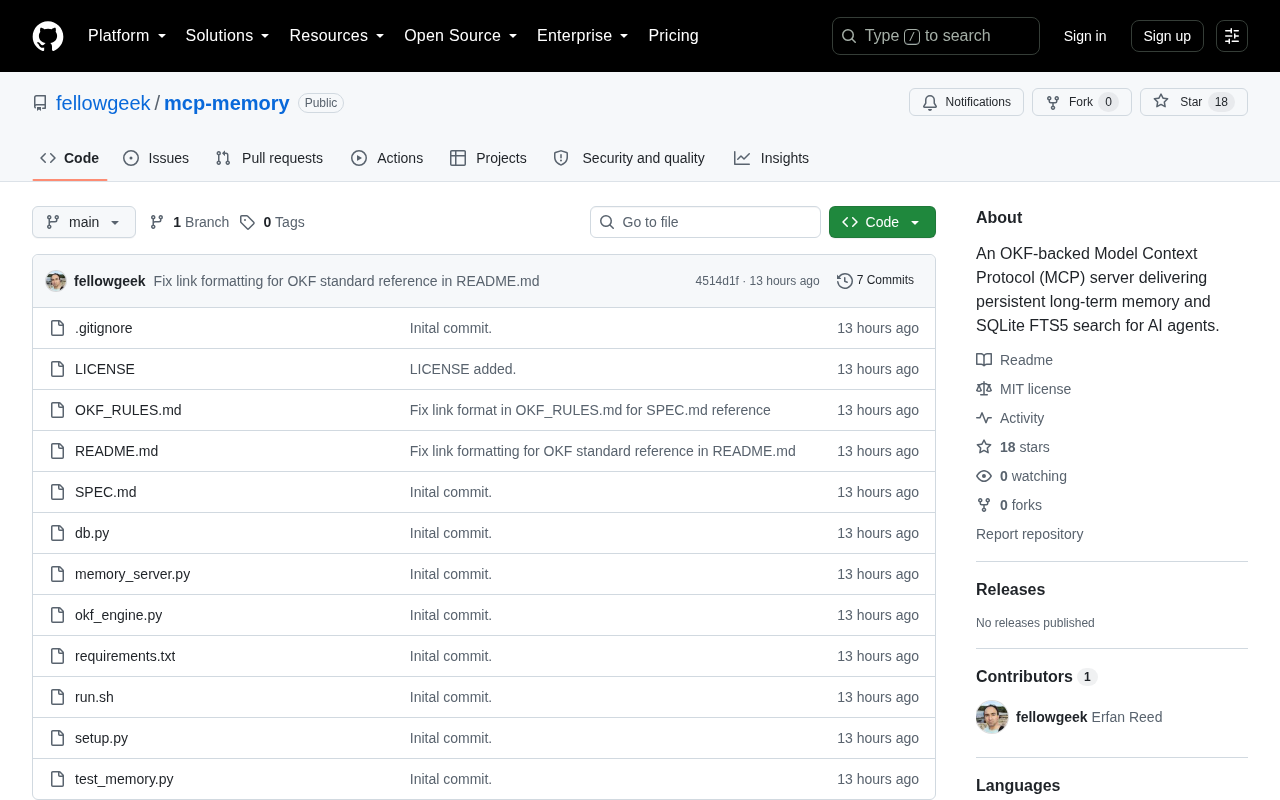
近日,一个名为 MCP Memory 的开源项目在 Hacker News 上引发关注。它另辟蹊径,结合了 Google 的 OKF(Object Knowledge Format)与 SQLite 的 FTS5 全文检索能力,提供一个快速、轻量、无需重型基础设施的智能体记忆方案。
MCP Memory 技术架构解析
MCP 协议:标准化的上下文接口
MCP(Model Context Protocol,模型上下文协议)是近来备受瞩目的开放标准,旨在为 AI 模型与外部工具、数据源之间建立统一的通信接口。将记忆功能封装为一个 MCP Server,意味着任何支持 MCP 的客户端(如 Claude Desktop、各类 IDE 插件或 Agent 框架)都能即插即用地接入持久记忆能力,而无需针对每个应用重复开发。
MCP 由 Anthropic 于 2024 年末提出并开源,其设计灵感类似于语言服务器协议(LSP)对 IDE 生态的统一作用。LSP 的成功经验在于:在 LSP 出现之前,每种编程语言需要为每种编辑器分别实现代码补全、定义跳转等功能,形成 M×N 的组合爆炸;LSP 将其简化为 M+N 的线性关系——语言实现一个 Server,编辑器实现一个 Client,双方通过标准协议通信。MCP 对 AI 工具生态的作用完全类似:工具提供者只需实现一个 MCP Server,就能被所有兼容客户端调用。
在技术实现上,MCP 基于 JSON-RPC 2.0 通信标准,支持 stdio(标准输入输出)和 SSE(Server-Sent Events)两种传输层。协议定义了三种核心原语:工具(Tools) 是模型可以主动调用的函数,如"存储记忆"或"检索记忆";资源(Resources) 是模型可以读取的数据,如文件内容或数据库记录;提示(Prompts) 是预定义的交互模板。MCP Server 通过 initialize 握手声明自身能力,Client 通过 tools/list 发现可用工具,通过 tools/call 执行调用。这种声明式的能力发现机制使得 Client 无需硬编码任何工具知识。
截至 2025 年初,MCP 生态已拥有数千个社区开发的 Server,覆盖从 GitHub 操作、Slack 消息到 PostgreSQL 查询的广泛场景。主要支持 MCP 的客户端包括 Claude Desktop、Cursor IDE、Windsurf、Continue 等开发工具,以及 LangChain、CrewAI 等 Agent 框架通过适配层的支持。
这是该项目最具价值的设计选择之一:它不重新发明轮子,而是拥抱正在形成的行业标准,从而具备良好的生态兼容性。
为什么选择 SQLite FTS5 而非向量数据库
目前主流的智能体记忆方案(如 Mem0、Zep 等)普遍采用向量嵌入 + 语义检索的路线。这种方式虽然能捕捉语义相似度,但也带来了明显的成本:
- 计算开销:每次写入和查询都需要调用嵌入模型,产生 API 费用或本地算力消耗
- 基础设施复杂度:需要部署和维护专门的向量数据库(如 Pinecone、Qdrant、Chroma)
- 延迟:嵌入计算与向量检索链路较长
以具体成本为例,OpenAI 的 text-embedding-3-small 每百万 token 约 $0.02,看似便宜,但智能体在持续交互中每次写入记忆和每次查询都需要调用嵌入 API。假设一个活跃智能体每天产生 100 次记忆写入和 500 次检索,每次平均处理 200 token,月度嵌入成本约为 $1.08。这对单用户可控,但扩展到 10 万用户则月度成本达 $108,000。
此外还需考虑向量数据库本身的托管费用和架构复杂度。向量数据库的核心数据结构是近似最近邻(ANN)索引,其中最主流的是 HNSW(Hierarchical Navigable Small World)算法——通过构建多层跳跃列表式的图结构,在高维空间中实现对数级别的近似最近邻搜索。HNSW 索引的构建需要大量内存(通常是原始向量数据的 1.5-2 倍),且对动态更新不如传统数据库友好。不同向量数据库的架构选择也带来不同的运维负担:Pinecone 是全托管服务,标准套餐起步 $70/月;Qdrant 支持自部署但需要管理集群;Chroma 和 LanceDB 虽然可以嵌入式运行,但嵌入计算本身的成本仍然存在。Weaviate Cloud 从 $25/月起步。
对比之下,SQLite 方案的成本几乎为零——一个文件,无需网络调用,无需托管服务,完全在本地完成。
MCP Memory 反其道而行,采用 SQLite 内置的 FTS5 全文检索引擎。FTS5(Full-Text Search version 5)是 SQLite 内置的全文索引扩展模块,自 SQLite 3.9.0(2015年发布)版本起提供。其底层使用倒排索引(inverted index)数据结构:将每个文档中的词条(term)映射到包含该词条的文档列表及其位置信息。具体而言,倒排索引由两部分组成——词汇表(vocabulary)存储所有唯一词条,倒排列表(posting list)记录每个词条出现在哪些文档的哪些位置。查询时只需在词汇表中定位词条(通常通过 B-tree 实现 O(log n) 查找),然后直接获取对应的文档列表,实现极快的关键词定位。
FTS5 默认使用 BM25 排序算法,这是信息检索领域的经典相关性评分公式。BM25 的核心思想可以分解为三个因子:词频饱和度(高频词的边际贡献递减,通过参数 k1 控制饱和速度)、逆文档频率(在少量文档中出现的词更有区分度,IDF = log((N - df + 0.5)/(df + 0.5)),其中 N 是总文档数,df 是包含该词的文档数)、以及文档长度归一化(较短文档中出现的词权重更高,通过参数 b 和平均文档长度调节)。相比早期的 FTS3/FTS4,FTS5 在性能和 API 设计上有显著改进,支持自定义分词器(tokenizer)、列级权重、前缀查询和短语匹配。值得注意的是,对于中文等非空格分词的语言,需要配置专门的分词器(如 jieba 或 ICU 分词器),这是 FTS5 在多语言场景下需要额外处理的环节。在实际基准测试中,FTS5 对百万级文档的检索延迟通常在个位数毫秒级别,远快于向量检索的典型延迟(10-100ms)。
其核心优势在于:
- 零外部依赖:整个记忆库就是一个 SQLite 文件,可随应用一起分发
- 极快的检索速度:关键词检索在本地毫秒级返回
- 无嵌入成本:完全不依赖嵌入模型,省去 API 调用与算力开销
Google OKF 的知识组织作用
OKF(Object Knowledge Format)是 Google 提出的一种结构化知识表示格式,旨在将非结构化信息组织为以实体(Object)为中心的知识单元。每个知识对象包含类型标识、属性键值对和关系链接,类似于知识图谱中的节点表示但更轻量。
要理解 OKF 的定位,需要了解知识表示领域的光谱。在一端是完全非结构化的自由文本,在另一端是 RDF(Resource Description Framework)和 OWL(Web Ontology Language)等重量级语义网标准。RDF 使用"主语-谓词-宾语"三元组表示知识,理论上非常强大,但其复杂的 XML 语法、需要预定义本体(ontology)、以及 SPARQL 查询语言的学习曲线,使其在实际应用中门槛过高。知识图谱(如 Google Knowledge Graph、Wikidata)则需要大规模的实体链接和关系抽取流水线。OKF 取中间路线:它保留了实体和属性的结构化优势,但不强制要求预定义模式(schema-free),也不需要复杂的推理引擎,使其特别适合 LLM 应用中"足够结构化但不过度工程化"的需求。
在 MCP Memory 的语境中,OKF 的价值在于将"用户偏好 Python 语言"这样的记忆,从一段自由文本结构化为 {type: 'preference', subject: 'user', attribute: 'programming_language', value: 'Python'} 的形式。这种结构化带来三个关键优势:
- 精确检索:可以按类型(type)、主体(subject)或属性(attribute)进行精确过滤,而非仅靠全文匹配
- 去重与更新:当用户偏好从 Python 变为 Rust 时,系统可以通过主体+属性的组合键精确定位并更新对应记录,而非追加一条新记忆导致矛盾
- 一致性维护:结构化格式使得冲突检测成为可能——如果两条记忆对同一属性给出不同值,系统可以按时间戳保留最新值或提示用户确认
相比于将记忆简单存储为一段段自由文本,结构化的知识表示能让检索更精准、事实关系更清晰。这种"结构化知识 + 全文检索"的组合,是 MCP Memory 区别于纯向量方案的技术特色。
SQLite 记忆方案的优势与权衡
轻量方案的现实价值
对于大量实际应用场景而言,开发者并不需要复杂的语义向量检索。很多智能体记忆本质上是事实性、关键词导向的——例如"用户的名字叫什么""上次讨论的项目名称""偏好的编程语言"。在这类场景下,基于关键词的 FTS5 检索完全够用,且响应更快、成本几乎为零。
SQLite 本身的技术特性也值得在此强调。作为全球部署量最大的数据库引擎(估计活跃实例超过万亿个,存在于每部智能手机、每个浏览器和大量嵌入式设备中),SQLite 拥有超过 25 年的工程积累和极高的可靠性。它的单文件架构意味着备份就是复制文件,迁移就是移动文件,版本控制也极为直观。在 AI 智能体的场景中,这种简单性尤为珍贵:用户的记忆数据可以轻松导出、备份或在设备间同步,不存在供应商锁定问题。
这种务实的设计理念,恰好契合了当前开发者社区对"去重型化"工具的普遍诉求:不是所有 AI 应用都需要一整套向量数据库栈。
全文检索的固有局限
放弃向量嵌入也意味着放弃了语义理解能力。FTS5 依赖字面匹配,当查询词与存储内容用词不同但语义相近时(例如查询"喜欢什么车"却存储着"钟爱特斯拉"),关键词检索可能会漏检。这是纯全文方案难以回避的短板。
从技术原理来看,BM25(Best Matching 25)是概率信息检索模型的代表,由 Stephen Robertson 等人在 1990 年代提出(论文最早可追溯至 TREC-3 会议,1994年),至今仍是 Elasticsearch、Solr 等主流搜索引擎的基础排序组件。它通过统计词频和文档频率来计算查询与文档的相关性得分,本质上是"词袋模型"(Bag of Words)——只关注词的出现频率,不理解词序和语义。"猫追狗"和"狗追猫"在 BM25 看来是完全等价的。
相比之下,向量语义检索使用神经网络(通常是 BERT 类 Transformer 编码器)将文本编码为高维稠密向量(通常 256-1536 维),通过余弦相似度或点积计算语义距离。这些模型通过在大规模文本对上的对比学习训练,学会将语义相近的文本映射到向量空间中的邻近位置。语义检索能理解"汽车"和"轿车"是近义词,"银行"在"河岸"语境和"金融"语境中有不同含义(多义词消歧),而 BM25 做不到。
但 BM25 对精确术语(如产品名称、代码变量名、人名)的匹配更可靠,且不存在向量检索中常见的"语义漂移"问题——即返回语义相似但实际无关的结果。例如,查询"Python 错误处理"时,向量检索可能返回"Java 异常机制"的内容(语义相似但用户明确需要 Python),而关键词检索会严格限定在包含"Python"的文档中。
理想的方案或许是混合检索(hybrid search)——将 FTS5 的关键词精确匹配与轻量级语义检索相结合,兼顾速度与召回率。混合检索已成为生产级搜索系统的最佳实践(Elastic 8.0、Vespa、Weaviate 等均已原生支持),常见实现方式包括:
- 倒数排名融合(RRF, Reciprocal Rank Fusion):对两种检索各自返回的排名列表,通过公式
score(d) = Σ 1/(k + rank_i(d))合并(k 通常取 60),简单有效且无需调参 - 加权线性组合:对 BM25 分数和向量相似度分数分别归一化(通常用 min-max 归一化到 [0,1])后加权求和,如
final_score = α × bm25_norm + (1-α) × vector_norm,α 可根据场景调整 - 两阶段检索(Retrieve-and-Rerank):先用关键词快速召回较大的候选集(如 Top-100),再用语义模型(交叉编码器 Cross-Encoder)对候选集精排,取 Top-K 作为最终结果
在 SQLite 生态中,sqlite-vec 等扩展已经支持在同一数据库中同时维护 FTS5 索引和向量索引。sqlite-vec 由 Alex Garcia 开发,允许在 SQLite 中存储和查询浮点向量,支持 L2 距离、余弦距离和点积等度量方式。虽然其 ANN 性能不及专用向量数据库,但对于记忆检索这种规模(通常数千到数万条记忆,而非数百万)完全足够。
MCP Memory 未来若引入混合检索,可以在保持轻量架构的前提下,对需要语义理解的查询使用小型本地嵌入模型(如 all-MiniLM-L6-v2,仅 80MB,384 维输出,在 CPU 上单次推理约 5-10ms;或 bge-small-en-v1.5,仅 130MB,在 MTEB 基准上表现优于许多更大模型),实现成本与效果的平衡。这种"本地小模型嵌入 + SQLite 向量存储 + FTS5 关键词检索"的三合一架构,可能是个人智能体记忆的最优工程解。
对 AI 智能体开发者的启示
MCP Memory 的出现,反映了 AI 工程领域一个值得关注的趋势:在向量数据库热潮之后,开发者开始重新审视传统数据库技术的价值。SQLite 这样久经考验的嵌入式数据库,凭借其零配置、高性能和极佳的可移植性,正在 AI 时代找到新的用武之地。
这一趋势的背景是 AI 工程从"技术驱动"向"需求驱动"的成熟转变。2023-2024 年间,向量数据库领域经历了一轮投资热潮(Pinecone 估值 $7.5B,Weaviate 融资 $5000万),许多开发者在尚未验证需求的情况下就引入了向量检索栈。随着实践深入,社区逐渐认识到"不是所有钉子都需要语义向量这把锤子",更务实的工程选择开始回归。
对于正在构建 AI 智能体的开发者,这个项目提供了几点参考:
- 优先评估真实需求:你的记忆检索到底需不需要语义理解?如果大部分是关键词或事实查询,轻量方案可能更优。一个实用的判断标准是:如果你的记忆内容大多包含明确的实体名称(人名、项目名、技术术语),且查询通常也围绕这些实体展开,那么关键词检索的召回率可能已经足够高
- 拥抱标准协议:将功能封装为 MCP Server,能极大提升复用性和生态兼容性。更重要的是,标准协议使得记忆方案可以被替换而不影响上层应用——今天用 FTS5,明天想切换到混合检索,只需更换 Server 实现,Client 端无需任何修改
- 保持成本意识:嵌入模型的调用成本在规模化后不容忽视,本地全文检索是一种经济的替代或补充。特别对于个人开发者和小团队,在产品验证阶段使用零成本方案快速迭代,待需求明确后再决定是否引入更复杂的检索架构,是更稳健的工程策略
结语
MCP Memory 并非要取代所有向量记忆方案,而是为特定场景提供了一个快、轻、省的选择。它证明了在 AI 基础设施日趋复杂的今天,回归简单、成熟的工程方案往往能带来意想不到的效率提升。随着 MCP 生态的持续扩张,这类聚焦单一能力、遵循开放标准的"小而美"工具,或将成为构建可靠 AI 智能体的重要拼图。
从更宏观的视角看,MCP Memory 代表的是一种工程哲学:在 AI 时代,最好的基础设施不一定是最新最酷的技术,而是最适合问题规模和约束条件的方案。SQLite 诞生于 2000 年,BM25 诞生于 1994 年,但当它们被恰当地组合并通过现代协议(MCP)暴露给 AI 系统时,依然能提供极具竞争力的解决方案。这提醒我们:在追逐前沿的同时,不要忘记那些经过时间验证的工程智慧。
核心要点
相关推荐
LangGraph速通指南:手撕企业级AI智能体与工作流
LangGraph 速通指南:解析 LangGraph 与 LangChain 的独立关系、MIT 开源协议、FastAPI 高并发部署、人工审批与长短记忆存储机制,助你手撕企业级 AI 智能体与工作流。
从0到1搭建智能客服Agent:意图识别92%的实战拆解
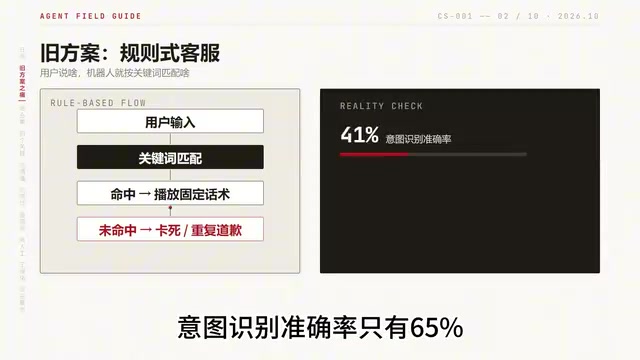
B站实战分享:从0到1搭建智能客服Agent,用BERT意图识别、对话状态跟踪、向量检索混合方案和转人工打分模型,把意图识别准确率从65%提升到92%,对话完成率78%,每天处理10万次对话。
Loop Engineering:让AI自动写代码并合并PR的工程范式
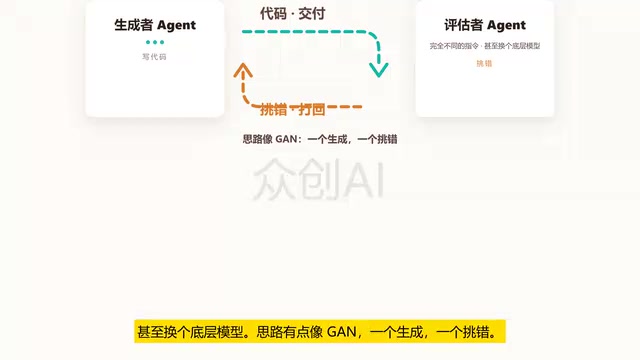
Loop Engineering 正在改变 AI 开发流水线:Stripe 用 Minions 系统每周合并超 1300 个机器生成的 PR。本文拆解 Loop Engineering 的五个核心动作、六类部件、五种失控模式与三条安全纪律,说明为什么独立评估者、状态文件与预算上限比全自动更重要。