美国上诉法院维持五角大楼封杀Anthropic的决定

美国联邦上诉法院维持五角大楼将Anthropic列为供应链风险的裁决,Claude的"道德拒答"机制成核心争议。
美国联邦上诉法院以2比1裁决,维持五角大楼将AI公司Anthropic定性为"供应链风险"的决定,禁止军方及国防承包商使用Claude模型。事件起于今年2月双方就军方使用Claude的谈判破裂,国防部依据两项不同法律授权分别作出裁定,迫使Anthropic同时在旧金山和华盛顿两地应诉。虽然旧金山联邦法官裁定其中一项定性违法,但此次上诉败诉使整体限制仍然生效。争议核心在于:军方认为Claude的训练方式内嵌了"道德判断"机制,可能导致模型在战场场景下拒绝执行指令,这在国防逻辑中属于不可接受的风险。该事件揭示出AI"安全拒答"能力在民用与国防场景中截然相反的价值判断,对整个大模型行业进入政府市场具有深远的信号意义。
事件回顾:Anthropic败诉上诉法院
美国联邦上诉法院在华盛顿特区以2比1的裁决,维持了五角大楼此前将AI公司Anthropic列为供应链风险的决定。据CNBC记者Kate Rooney在Tech Check栏目中的报道,这意味着这家AI实验室在与特朗普政府长达数月的法律拉锯战中失去了关键一局。
整起事件最早可追溯至今年2月。当时,美国国防部(报道中以"Department of War"称呼)在双方就军方如何使用Anthropic旗下Claude模型的谈判破裂后,将该公司正式定性为"供应链风险"。这一定性直接禁止美国军方使用Claude,同时也阻止国防承包商在任何与五角大楼相关的工作中使用这些AI模型。
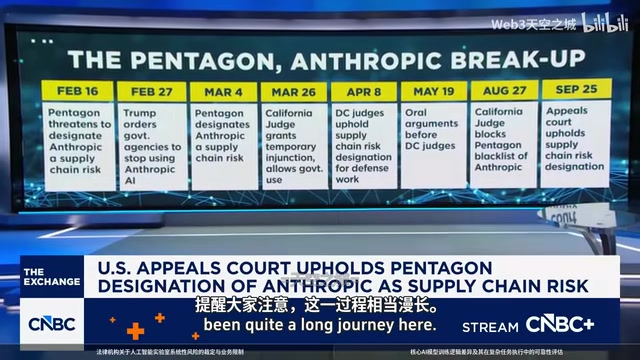
Anthropic方面曾提出抗辩,主张该决定"武断、非法且违宪"。但上诉法院驳回了全部主张。撰写多数意见的法官表示,国防部对于"继续使用Claude可能构成国家安全风险"的结论拥有"充分依据"。
两套定性、两条战线的法律博弈
值得关注的是,五角大楼当初是依据两项不同的定性来执行这次封杀的,这也意味着Anthropic不得不在两个不同的法院分别提起挑战。
今年早些时候,旧金山一位联邦法官曾裁定其中一项定性属于违法,Anthropic在加州战线赢得了部分胜利。但华盛顿特区上诉法院此次的裁决,让政府对Anthropic的限制整体上得以继续生效。
换句话说,尽管Anthropic在一条战线上取得突破,但真正决定其能否重返军方供应链的关键环节仍以败诉告终。Anthropic当天发表声明表示"尊重但不认同"该裁决,并正在考虑包括进一步上诉复审在内的多种选项。
"供应链风险"定性的法律依据
美国国防部将供应商列为"供应链风险"的权力,主要来源于《联邦采购法规》(FAR)及《国防联邦采购法规补充》(DFARS)中关于信息和通信技术供应链安全的条款,以及2018年《国防授权法案》(NDAA)相关修正条款。这一机制最初主要针对硬件供应商(如华为、中兴),后来逐步扩展至软件与AI服务领域。一旦被列入该名单,相关企业不仅无法直接获得军方合同,其产品也会被排除在所有国防承包商的技术栈之外,影响面极为广泛。Anthropic此次同时面临两项定性、需在两个司法管辖区分别应诉,正是因为国防部使用了两个不同的法律授权依据分别作出裁定,而非依据同一条款一次性处理。
为什么偏偏是Anthropic?训练方式成争议焦点
一个核心疑问在于:为什么国防部单单针对Anthropic,而没有对OpenAI、xAI(Grok)或Perplexity等其他AI厂商采取类似行动?
据报道,争议的根源在于军方对Claude"训练方式"的质疑。五角大楼方面认为,Claude的训练过程存在偏见,模型反映了背后公司高层的政治倾向。报道特别提到,Anthropic的CEO Dario Amodei被相关官员形容为"woke"(觉醒派)。
更关键的安全层面担忧在于:军方认为Claude的训练方式使其可能基于"道德判断"而拒绝执行某些任务。在战争场景下,如果一个AI模型出于种种原因"决定"不配合某项操作,这在国防部看来本身就是一种风险。这也是相关负责人Emile Michael的核心顾虑——他并不信任Claude的训练路径。
"价值观对齐"(Alignment)与"宪法AI"训练方法
Anthropic在业内以其独特的安全导向训练方法著称。该公司提出了"宪法AI"(Constitutional AI,CAI)框架:在模型训练阶段预先写入一套"宪法"原则,让模型依据这些原则对自身输出进行自我批判和修正,从而使Claude在遇到潜在有害请求时更倾向于拒绝或降级回应。这套方法的设计初衷是让AI在没有大量人工标注的情况下,仍能主动规避有害内容。
然而正是这种"主动拒绝"能力在国防场景下引发了结构性矛盾:军方需要的是一个在明确授权指令下能够无条件执行的工具,而不是一个会独立进行道德评估后再决定是否配合的系统。与此形成对比的是,OpenAI和xAI的公开安全政策相对更强调"可配置性"——允许企业/政府用户通过系统提示(System Prompt)大幅调整模型的拒绝边界,这在军方看来可能意味着更高的可控性。
政治因素之外:供应链多元化的现实考量
除了政治与安全层面的争议,报道还指出了一个相对技术中立的理由:供应链多元化。
Emile Michael此前曾表示,军方在今年之前一直只依赖Claude这一家技术方案,而这"本身就不是好的做法"。无论政治立场如何,在关键基础设施中引入多家技术合作伙伴、避免单点依赖,是普遍认可的工程与采购原则。
不过报道也坦承,这件事在很大程度上仍掺杂了政治因素。值得留意的是,Emile Michael并未对OpenAI或马斯克旗下的xAI提出同样的训练方式批评,这种选择性态度使得"纯粹技术考量"的说法显得不够充分。
对AI行业的信号意义
这起案件的意义远超Anthropic一家公司的得失。它揭示了AI模型的"价值观对齐"与"安全拒答"机制,在政府和军方采购场景中可能被视为负面因素——在消费级市场备受推崇的"拒绝执行有害任务"能力,到了国防语境下反而成了被质疑的风险点。
同时,这也是AI厂商与政府关系政治化的一个缩影。模型训练理念、公司高层立场,正越来越直接地影响到企业能否进入高价值的政府与国防市场。对于所有大模型厂商而言,如何在"安全可控"与"可被信任地执行指令"之间取得平衡,将成为争取政府订单时无法回避的课题。
"可信赖执行"(Trustworthy Execution)与"安全拒答"的双重标准困境
这一事件在更宏观的层面揭示了AI治理中尚未解决的根本性张力:民用安全框架与政府/国防需求之间的标准不兼容问题。在欧盟AI法案、美国NIST AI风险管理框架等监管体系中,模型能够拒绝有害指令被视为高安全等级的正面指标;而在国防采购逻辑中,同样的能力可能被定性为"不可预测的自主性",从而构成操作风险。
这一裂缝对整个大模型行业具有系统性影响:专门面向政府市场的AI产品线(GovAI)可能需要独立于消费级产品的训练流程与安全策略,以满足"执行优先"的需求。这意味着未来大型AI公司可能需要同时维护两套价值观对齐体系,而两套体系之间的协调本身将成为新的合规与伦理挑战。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。