免费白嫖顶级AI模型?聚合站点背后的安全风险揭秘

天上掉馅饼的AI站点
近期,B站等平台上涌现了大量宣传"免费使用全球顶级AI模型"的视频,声称通过某个"超强宝藏站点"就能零门槛、无限次免费使用ChatGPT、Claude、Gemini、Grok等所有主流大模型的满血版本。这类内容标题极具诱惑力,动辄标榜"GPT 5.5""Claude 4.7"等看起来非常前沿的模型版本号。
但事实真的如此美好吗?本文将从技术和安全角度,深入分析这类AI聚合站点的真实面目,帮你避开潜在的隐私和数据风险。
虚假版本号:第一个红旗信号
这类视频中最明显的问题,就是充斥着大量根本不存在的模型版本号。
以近期一个典型案例为例,视频中提到了"GPT 5.5 Syncing""Grok 4.2""Claude 4.7"等模型。然而截至目前:
- OpenAI最新发布的模型是GPT-4o和o3系列,并未发布所谓的"GPT 5.5"
- Anthropic的Claude最新版本为Claude 4(Sonnet/Opus),不存在"4.6"或"4.7"
- xAI的Grok最新版本为Grok 3/4,并无"4.2"这一版本
- Google的Gemini系列也没有"3.5"这个版本号
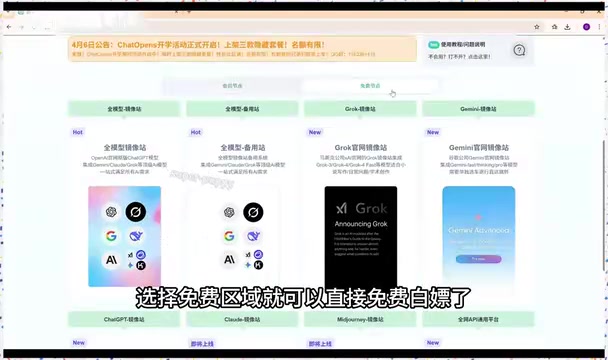
这些虚构的版本号本身就暴露了内容的不可靠性。创作者要么对AI行业完全不了解,要么就是故意编造高版本号来制造"前沿感",吸引不明真相的用户点击。
大模型版本命名的行业规范
要理解为什么这些版本号一眼就能看出是假的,需要了解主流AI公司的模型命名体系。OpenAI的命名从GPT-3到GPT-4,再到GPT-4o("o"代表omni,即全能)和o系列推理模型(o1、o3等),每个版本号都对应着底层架构的重大升级或能力的显著突破。Anthropic的Claude系列从Claude 1到Claude 4,中间经历了Claude 2、Claude 3(Haiku/Sonnet/Opus三个规格),每个版本的发布都伴随着官方技术报告和基准测试数据。
这些公司不会悄悄发布"半代"更新(如5.5或4.7),因为每次版本迭代都涉及巨大的训练成本——通常在数亿美元级别——以及严格的安全评估流程(包括红队测试、对齐评估等),必然伴随正式的公开发布活动和媒体报道。一个真正关注AI领域的人,绝不可能被这些凭空捏造的版本号所迷惑。
AI聚合站点的技术原理与本质
API代理与逆向工程
所谓的"直达官网"聚合站点,本质上通常是以下几种形式之一:
-
API代理站:站点运营者购买了各大模型的API密钥,然后通过自建前端界面提供服务。用户看到的并非真正的官网,而是一个模仿官网界面的第三方页面。
-
逆向代理:通过技术手段反向代理官方网站,用户的请求经过中间服务器转发。这意味着你的所有对话内容都会经过第三方服务器。
-
共享账号池:运营者维护一批付费账号,用户实际上是在轮流使用这些共享账号。
技术细节解析
API(Application Programming Interface,应用程序编程接口)是软件系统之间通信的标准化方式。以OpenAI为例,开发者可以通过购买API密钥,以编程方式调用GPT模型的能力,按照输入和输出的token数量计费。所谓token,是大语言模型处理文本的基本单位,一个token大约对应英文中的3/4个单词或中文中的1-2个字符。GPT-4级别模型的API调用成本大约在每百万输入token 2.5-10美元不等,这意味着运营一个供数千人免费使用的聚合站点,每月的API费用可能高达数千甚至数万美元。
逆向代理(Reverse Proxy)则是一种网络架构技术,原本广泛用于负载均衡、缓存加速和安全防护等正当用途,但在这类场景中被滥用为流量劫持工具——它在用户与目标服务器之间插入一个中间层,可以完整地读取、记录甚至篡改双向传输的所有数据。用户在浏览器中看到的界面可能与官网几乎一模一样,但实际上所有数据都在经过一个不受信任的第三方服务器中转。
免费的代价:你才是产品
天下没有免费的午餐。这些站点的运营成本并不低——GPT-4级别的API调用费用相当可观。那么"免费"的背后,用户付出的代价可能包括:
- 隐私泄露:你的对话内容、提问习惯、甚至输入的敏感信息都会经过第三方服务器,存在被记录和滥用的风险
- 数据收集:注册时提供的邮箱、手机号等个人信息可能被用于其他商业用途
- 引流变现:视频中典型的"关注+三连+评论"才能获取链接的模式,本质上是一种流量变现手段
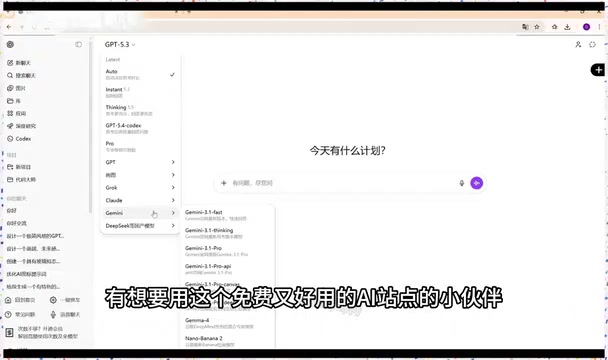
AI服务的真实成本
理解AI服务的成本结构有助于识别"免费"服务的不合理性。以OpenAI的GPT-4o为例,其API定价为每百万输入token约2.5美元、每百万输出token约10美元。一次普通对话可能消耗数千个token,而一个活跃用户每天可能进行数十次对话。按此计算,即使只有1000名活跃用户,月度API成本也可能达到数千美元。这还不包括服务器托管、带宽、前端开发和维护等运营成本。当一个站点声称完全免费提供这些服务时,其商业逻辑必然存在用户不可见的变现方式——而你的数据,很可能就是那个被变现的"产品"。
深层安全风险
当用户通过第三方聚合站点使用AI服务时,面临的安全风险远不止对话内容泄露。中间人攻击(Man-in-the-Middle Attack)是最典型的威胁之一:第三方服务器可以完整记录用户的IP地址、浏览器指纹、设备信息、访问时间模式等元数据,这些信息组合起来足以构建详细的用户画像。更严重的是,如果用户在对话中输入了代码片段、商业计划、个人健康信息或其他敏感内容,这些数据一旦被收集,可能被用于定向广告、社会工程攻击,甚至在暗网上交易。根据GDPR(欧盟通用数据保护条例)等数据保护法规,正规AI服务商必须明确告知数据处理方式并提供删除机制,而这些第三方站点通常完全不受此类法规约束,用户的数据权益毫无保障。
AI画图效果的真假辨析
视频中还展示了所谓的AI画图功能,声称效果"甩开其他大模型十万条街",并展示了诸如"马斯克代言老干妈"等趣味图片。
客观来说,当前主流的AI图像生成模型(如DALL-E 3、Midjourney V6、Flux等)确实已经能够生成非常逼真的图片。但需要注意以下几点:
- 视频中展示的图片效果无法验证是否真的来自该站点
- 即使效果真实,也不代表该站点本身是安全可靠的
- 同样的效果,通过官方渠道完全可以实现
图像生成技术的现状
当前主流的AI图像生成技术主要基于扩散模型(Diffusion Model)架构。其工作原理是先向图像中逐步添加噪声直至变为纯噪声,然后训练神经网络学会逆向这个过程——从噪声中逐步还原出清晰图像。DALL-E 3是OpenAI集成在ChatGPT中的图像生成模型,擅长精确理解复杂的文本指令;Midjourney V6以独特的艺术风格和美学表现力见长;而Black Forest Labs开发的Flux模型则在开源社区广受欢迎,允许用户在本地部署运行。
值得注意的是,图像生成的计算成本远高于文本生成——单张高质量图片的生成可能消耗相当于数百次文本对话的算力资源(涉及大量的GPU并行计算),这也是为什么图像生成功能通常有更严格的使用限制。一个声称可以无限免费生成高质量图片的站点,其背后的成本压力更加难以自圆其说。
如何安全地使用AI大模型
官方渠道始终是首选
| 模型 | 官方地址 | 免费额度 |
|---|---|---|
| ChatGPT | chat.openai.com | GPT-4o有免费额度 |
| Claude | claude.ai | 每日免费对话额度 |
| Gemini | gemini.google.com | 免费使用 |
| Grok | grok.com | 免费使用 |
实际上,各大AI模型的官方平台都提供了一定程度的免费使用额度。ChatGPT的GPT-4o模型、Claude Sonnet、Google Gemini、xAI Grok等都可以直接免费体验,完全没有必要冒着隐私风险去使用来路不明的第三方站点。
合规替代方案
如果你需要更高的使用额度或更多功能,以下是一些合规的选择:
- 官方订阅:ChatGPT Plus($20/月)、Claude Pro($20/月)等,价格透明且数据安全有保障。这些订阅服务受到完善的隐私政策和服务条款保护,用户对自己的数据拥有明确的知情权和控制权。
- API自建:通过官方API搭建自己的使用界面,按量付费,数据完全自控。这种方式适合有一定技术能力的用户或团队,可以使用开源的前端项目(如ChatGPT-Next-Web、LobeChat等)快速搭建私有化的AI对话界面,所有数据仅在自己的服务器上流转。
- 国内合规平台:如通义千问广告、文心一言、Kimi、DeepSeek广告等国产大模型,无需特殊网络环境即可使用,且符合国内数据安全法规要求。这些模型在中文理解和生成方面的表现已经非常出色,能够满足绝大多数日常使用场景。
总结:保持理性,拒绝诱惑
在AI工具日益普及的今天,"免费白嫖全球顶级AI"的诱惑确实很大。但作为理性的用户,我们需要认清以下几点:
- 虚假版本号是最直接的警示信号——连模型名称都在编造的内容,其可信度可想而知
- 免费的背后往往有隐性成本——你的数据和隐私可能就是真正的代价
- 官方渠道已经提供了充足的免费额度——大多数日常使用场景完全可以满足
与其追逐不靠谱的"白嫖"渠道,不如花时间学习如何更高效地使用官方工具。毕竟,在AI时代,提问的质量远比模型的版本号更重要。
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。