Milvus 2.6 实战:构建高性能 RAG 智能问答系统
解析 Milvus 2.6 云原生架构与高性能 RAG 系统的关键优化实践。
本文基于技术讲师李锦的分享,从向量检索原理出发介绍 Milvus 2.6 的核心特性与架构设计。文章首先说明向量数据库通过近似最近邻搜索解决非结构化数据的高维检索问题,并将 Milvus 在 AI 应用中的地位类比为 Java 开发中的 MySQL。随后解析 Milvus 2.6 的云原生分层架构,包括流式节点、查询节点、数据节点与协调器,以及 etcd、Kafka、对象存储等依赖组件,并厘清 Milvus 与商业版 Zilliz Cloud 的关系。部署部分介绍了 Lite 版与单机版的硬件要求。实战部分强调高性能 RAG 系统需关注水位线管理、预热字段、索引策略和分层存储驱逐策略四个优化维度,最后展望 2026 年 AI 大模型领域的技术焦点与就业交叉地带。
向量数据库正在成为 AI 应用的基础设施,而 Milvus 作为开源向量数据库的代表,其 2.6 版本在架构和性能上带来了不少值得关注的变化。本文基于技术讲师李锦的分享,从向量检索原理出发,梳理 Milvus 2.6 的核心特性,并探讨如何基于它搭建一个高性能的 RAG 智能问答系统。
为什么需要向量数据库?
传统关系型数据库擅长精确匹配和范围查询,比如查找某个字段等于特定值,或者用 LIKE 做模糊匹配。但面对「在几十亿张图片中快速找到一张特定的猫」这类需求,关系型数据库就力不从心了。
向量数据库的绝活是计算相似度。它把文本、图片等非结构化数据转化为高维向量,通过近似最近邻搜索在毫秒级时间内完成海量数据的相似性检索。Milvus 正是为高维向量检索而生的系统,在 AI 大模型应用中,它的角色类似于 Java 开发中的 MySQL——是底层数据存储与检索的关键组件。
据李锦介绍,Milvus 是目前全球最受欢迎的开源向量数据库之一,GitHub 星级达到大几万。相比收费方案,开源版本让开发者能够深入了解底层原理,而这对构建高性能 RAG 系统至关重要。
近似最近邻搜索(ANN) 是向量数据库的核心算法基础。精确的最近邻搜索需要将查询向量与库中所有向量逐一计算距离,复杂度为 O(N),在亿级数据上无法满足毫秒级响应。ANN 通过构建索引结构(如 HNSW、IVF、DiskANN 等)牺牲极小的召回率换取数量级的速度提升,通常能在召回率 95% 以上时把查询时间降到毫秒级。不同索引类型在内存占用、构建时间和查询精度上各有取舍,这也是后文「索引策略」优化点的由来。
高维向量与嵌入(Embedding):文本、图片等非结构化数据需先经嵌入模型转换为稠密向量(常见维度 384–1536),语义相近的内容在向量空间中距离更近。向量数据库存储的就是这些嵌入向量及其元数据,检索时计算查询向量与库内向量的距离(如余弦相似度、内积或欧氏距离)并返回 Top-K 结果。
Milvus 2.6 架构解析:云原生与分层设计
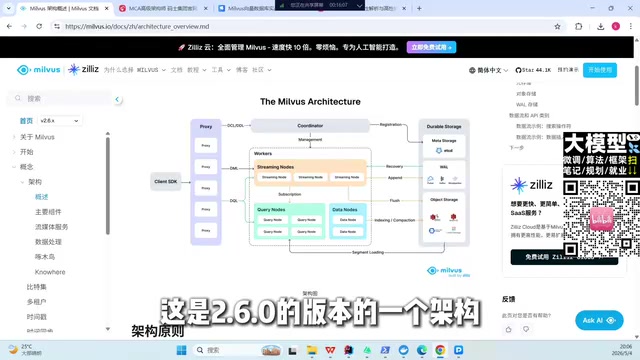
Milvus 2.6 的架构采用完全云原生的设计,支持从单机部署到云端集群的多种模式。从官方架构图可以看到,系统包含多种类型的节点:流式节点(Stream Node)、查询节点(Query Node)、数据节点(Data Node),以及协调器(Coordinator)负责针对不同操作将请求路由到对应节点。
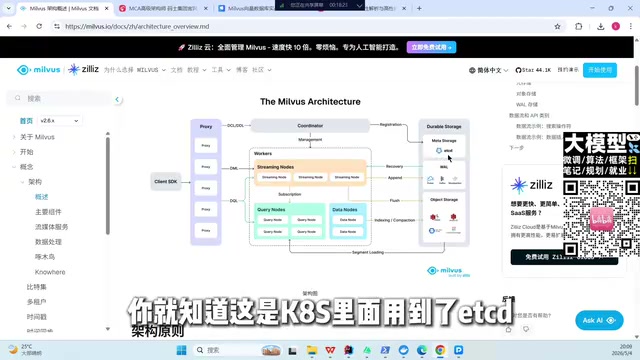
在依赖组件方面,Milvus 使用 etcd 作为元数据存储(这在 Kubernetes 生态中很常见),消息中间件支持 Kafka、Pulsar 以及 Warp 等,对象存储则兼容亚马逊对象存储、MinIO 和云存储服务。这种模块化设计让 Milvus 具备了良好的扩展性和部署灵活性。
开源与商业版的关系
需要厘清的是 Milvus 与 Zilliz 的关系。Zilliz 是一家公司,基于 Milvus 引擎推出了商业收费版本 Zilliz Cloud,提供在线云服务,免去了运维麻烦且速度更快。这层关系类似于 Linux 系统与红帽/CentOS 商业发行版——开源版本自由使用,商业版本提供企业级服务。
存算分离与消息队列的作用:Milvus 的云原生架构将计算与存储解耦——查询节点、数据节点负责计算,对象存储负责持久化数据,etcd 保存元数据,消息中间件(Kafka/Pulsar 等)则承担日志流(Log Broker)角色。写入请求先进入消息队列,由流式节点消费并保证顺序性,再异步落盘到对象存储,查询节点通过订阅消息队列实现数据的近实时可见。这种设计使各组件可独立扩缩容,也解释了为什么消息中间件是 Milvus 的必需依赖而非可选组件。
协调器(Coordinator)的职责:协调器是集群的大脑,分为 Root Coordinator(管理 DDL 与时间戳分配)、Query Coordinator(管理查询节点的负载均衡与分片分配)、Data Coordinator(管理数据节点的刷盘与压缩)等。它们本身不处理数据,只负责元数据调度和请求路由,从而避免单点成为数据瓶颈。
部署方式与硬件要求
Milvus 提供多种部署方式。最轻量的是 Python 的 Lite 版本,通过 pip 安装 pymilvus 库即可在本地启动并连接使用。单机版本则对硬件有一定要求:推荐至少 8GB 内存、英特尔第二代酷睿或更高版本的 CPU,并且强烈建议使用固态硬盘——李锦特别指出,非固态硬盘在 Milvus 上基本跑不好。
高性能 RAG 实战:关键优化点
课程的核心是一个基于 Milvus 的智能问答项目实战。李锦强调,搭建 RAG 系统不只是把向量存进去、查出来那么简单,真正决定性能的是以下几个优化维度:
- 水位线管理:控制数据写入和查询的负载均衡,避免单节点过载。
- 预热字段:对高频访问的字段提前加载到内存,减少查询延迟。
- 索引策略:选择合适的向量索引类型,在召回率和查询速度之间取得平衡。
- 分层存储与驱逐策略:Milvus 2.6 支持热冷数据分层,配合驱逐策略可以将不常访问的数据下沉,降低内存占用。
这些正是面试和实际项目中经常遇到的「蓝点」问题,也是区分普通使用者和架构设计者的关键。
RAG(检索增强生成) 的基本流程是:将用户问题经嵌入模型转为向量,在向量数据库中检索出最相关的若干文档片段,把这些片段作为上下文拼入提示词,再交给大语言模型生成答案。因此 RAG 系统的质量由「检索质量」和「生成质量」共同决定,而向量数据库直接决定前者。常见的检索优化手段包括混合检索(向量相似度 + 关键词 BM25)、重排序(Rerank)以及元数据过滤,这些都需要向量数据库在索引和查询层面提供支持。
水位线(Watermark)机制:在 Milvus 的流式写入链路中,水位线用于标记消息队列中已被持久化的位置。查询节点只处理水位线以下的数据,从而在保证数据可见性的同时避免读取未落盘的不稳定数据。水位线管理不当会导致查询延迟升高或数据可见性滞后,这正是把它列为关键优化维度的原因。
2026 年 AI 大模型的技术焦点
李锦在课程中提到,大模型持续火热,但要在这一领域立足,需要解决好几个核心问题:多智能体协作、RAG 优化、模型微调以及核心算法。而向量数据库作为 RAG 的存储底座,是这些能力的基础支撑。
从就业市场看,Java 架构师需要补 AI 知识,AI 工程师也需要理解工程架构,两者的交叉地带正是向量数据库、RAG 优化这类技术发挥作用的地方。掌握 Milvus 的深层机制,而不只是会调 API,才能在项目落地和面试中体现出差异化价值。
小结
Milvus 2.6 在云原生架构、分层存储和部署灵活性上做了不少功课。对于想构建企业级 RAG 系统的开发者来说,理解向量检索原理只是起点,水位线、预热、索引和驱逐策略这些工程细节才是决定系统能否扛住真实负载的关键。与其停留在安装入门,不如深入这些机制,让向量数据库真正成为 AI 应用的可靠底座。
相关推荐

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。

黄仁勋若卸任,英伟达AI帝国将何去何从?
英伟达的AI霸权是否过度依赖黄仁勋个人?本文分析硅谷对CEO的个人崇拜现象,探讨英伟达技术护城河与组织风险,以及AI产业为何需要摆脱救世主叙事。

2026科技诉讼风向标:立法者欲收紧AI与平台责任
2026年科技诉讼成为焦点:美国参议院司法小组委员会听证会推动限制在线平台强制仲裁,并加强对深度伪造创作者的追责,科技平台与AI工具面临责任重构。