MiniMax H3 实测:用超长提示词还原「桌面女孩」创意视频
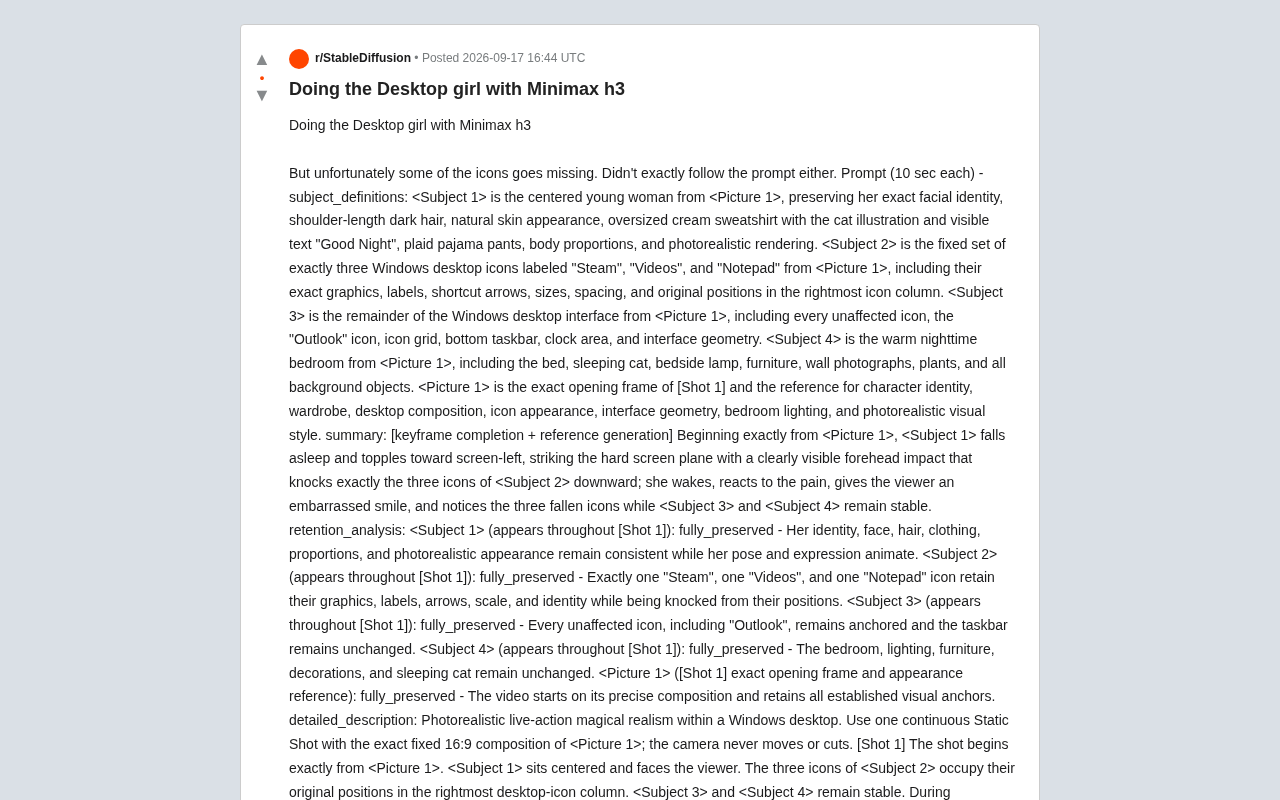
Reddit用户用结构化分镜提示词驱动MiniMax H3复刻「桌面女孩」,揭示AI视频精细控制的真实边界。
一位Reddit用户尝试用MiniMax H3视频模型复刻「桌面女孩」创意短片——女子打瞌睡撞上屏幕、图标散落再逐一归位。实验最大亮点是其提示词设计:将画面元素拆分为四个主体并逐一锁定,配以毫秒级动作时间轴和音效描述,接近专业电影分镜脚本。由于单段限制10秒,作者还采用分段续写策略拼接两段视频。最终结果喜忧参半:人物一致性基本可用,但桌面图标出现消失、变形等问题,且长提示词存在执行衰减。实验揭示了当前AI视频模型的两大核心短板:小物体多帧一致性差,以及精细约束条件越多、实际执行偏差越大。
一次充满野心的 AI 视频生成实验
近日,一位 Reddit 用户分享了使用 MiniMax H3 视频模型复刻「桌面女孩(Desktop girl)」创意的实验成果。这个创意本身颇具巧思:一位穿着印有「Good Night」字样奶油色卫衣的年轻女子,坐在电脑桌面前打瞌睡,头一歪撞上屏幕,把桌面上的几个图标「撞」了下来,随后她揉着额头、尴尬一笑,再一个个把图标拾起放回原位——一场发生在 Windows 桌面里的「魔幻现实主义」小剧场。
从作者的反馈来看,成果喜忧参半:整体效果基本还原了创意,但「有些图标中途消失了,而且也没有完全按照提示词执行」。这恰恰揭示了当前 AI 视频生成在精细化控制上的真实边界。
提示词工程:一份近乎「电影分镜脚本」的输入
这次实验最值得关注的,是作者所使用的提示词。它并非简单的一句话描述,而是一套结构化、接近专业分镜脚本的超长 prompt,每段视频时长仅 10 秒。整套提示词被拆分为多个模块:
主体定义(Subject Definitions)
作者把画面元素拆成四个「主体」并逐一锁定:
- Subject 1:居中的年轻女性,要求「保留其精确的面部身份、齐肩深色头发、奶油色猫咪图案卫衣、格纹睡裤、身体比例与照片级写实渲染」。
- Subject 2:恰好三个桌面图标——「Steam」「Videos」「Notepad」,明确要求保留图形、标签、快捷方式箭头、尺寸与间距。
- Subject 3:桌面其余不受影响的部分,包括「Outlook」图标、图标网格、任务栏与时钟区域。
- Subject 4:温暖的夜间卧室背景,含床、熟睡的猫、床头灯、墙上照片与植物。
这种「主体分层 + 保留清单(retention_analysis)」的写法,本质上是在告诉模型:什么必须变、什么绝对不能变。作者反复强调「fully_preserved(完全保留)」,试图用语言把每一个视觉锚点钉死。
这种「主体分层」写法借鉴了专业视觉特效(VFX)制作中的「图层分离」思维。在传统影视后期中,合成师会将前景角色、交互物件、背景环境分别处理,以便对每一层做精细控制而不干扰其他层。将这套逻辑迁移到提示词设计中,本质上是在用自然语言模拟「遮罩(mask)」与「锁定图层」的概念——强制要求模型在生成时区分「需要动」的元素与「必须静止」的元素。这对文本驱动的扩散模型来说是一种挑战,因为这类模型在训练时并没有显式的物体分层概念,它只能通过注意力机制(attention)去推断哪些 token 对应哪些像素,因此高度结构化的提示词实际上是在间接引导注意力的分布,而非真正「锁定」某个视觉区域。
逐帧时间轴控制
更极致的是,提示词精确到了毫秒级的动作时间轴。例如:
00:00.000–00:01.800:眨眼变慢、眼皮闭合、下巴下垂、进入睡眠;00:01.800–00:03.350:上半身向画面左侧倾倒,额头领先;00:03.350:额头撞击屏幕,界面抖动两三帧,恰好撞落三个图标;00:03.600–00:12.000:睁眼、揉额头、尴尬微笑、低头看图标。
作者甚至连音效都写进了 overall_soundscape:额头撞玻璃的低频闷响、三次图标脱落的清脆咔哒声、下落时的数字杂音与她受惊的吸气声。
分段续写:让两段 10 秒视频「无缝衔接」
由于单段时长限制在 10 秒,作者采用了分段续写的策略。第二段提示词中的 integrated_multimodal_description 明确要求:「从前一段视频自动继承的最后一秒无缝衔接,不要重置场景、不要重复跌倒、不要回放额头撞击、不要引入镜头切换。」
第二段的核心动作,是女子逐个把掉落的图标拾回原位——每次只移动一个图标,「Outlook」「Notepad」「Videos」「Steam」依次归位,还要用指尖做两次微调对齐,最后露出如释重负又略带尴尬的微笑。这种「拿起—放回—对齐」的连续动作,对模型的物体一致性追踪提出了极高要求。
分段续写(也称「视频外推」或「滚动生成」)是目前突破单次生成时长限制的常见工程手段。其核心思路是将上一段视频的最后几帧作为下一段的条件输入(conditioning frames),使模型在生成新内容时以已有画面为「锚点」,从而维持角色外观、场景光照与动作连贯性。然而这种方式存在「误差累积」风险:若第一段末尾已出现轻微的人物形变或场景偏移,第二段会将这些偏差当作「正确状态」继续生成,导致问题随段落增加而放大。此外,由于每段都需要重新理解提示词,模型有时会将「不要重置场景」的指令理解为允许做细微重置,因此作者在第二段提示词中不得不逐条列举禁止行为,本质上是一种防御性提示词写法(defensive prompting)。
为什么图标会「消失」?暴露的能力短板
作者提到的两个问题——图标消失、未完全遵循提示词——正是当前视频模型的典型痛点:
其一是小物体的一致性维持。 桌面图标属于画面中的小尺寸元素,模型在多帧渲染中很难持续「记住」它们的精确形态、标签文字与位置。当女子的头部运动、图标掉落等动态发生时,模型容易出现图标合并、变形乃至凭空消失的现象。作者在提示词里反复写「do not duplicate, merge, morph, disappear」,恰恰说明这些正是模型的高发错误。
其二是长提示词的执行衰减。 当一段提示词包含数十条精确约束时,模型往往无法逐条兑现。物理撞击的时机、界面抖动的帧数、音效的同步,这些细节越多,实际输出与文本描述的偏差就越大。换句话说,提示词写得越细,并不等于模型执行得越准。
从技术层面看,这两个问题根植于当前视频生成模型的底层架构特性。主流 AI 视频模型(包括基于扩散Transformer的架构)在生成连续帧时,并不维护一个显式的「场景状态图」——它无法像游戏引擎那样用一个对象列表来追踪「图标 A 当前在坐标 (x, y)」。每一帧的生成都依赖对前序帧的隐式理解,随着帧数增加,早期帧中的小物体细节容易在隐空间(latent space)中被逐渐「平滑掉」,导致图标在视觉上消融或消失。这被研究者称为「时序一致性衰减(temporal consistency degradation)」问题,是当前视频生成领域的核心挑战之一,也是 ControlNet、物体追踪引导等技术正在尝试解决的方向。
这次实验带来的启示
尽管结果不完美,这次实验仍具有相当的参考价值。它展示了一种「把提示词当剧本写」的思路:通过主体分层、保留清单、毫秒级时间轴和音效描述,尽可能压缩模型的自由发挥空间。对于追求精确控制的创作者来说,这套结构化写法值得借鉴。
同时它也提醒我们:现阶段的 AI 视频模型在照片级人物一致性(女子的面部、服装、动作)上已经相当可用,但在多个小物体的精确物理交互(图标被撞落再逐一归位)这类任务上,仍有明显不足。创意的完整落地,往往受制于这些看似微小、实则关键的细节。
对于想尝试类似创意的用户,一个务实的建议是:把复杂的物理交互拆解、简化,或降低对图标级别精确度的期待,先确保主体与场景稳定,再逐步加码细节。
相关推荐
Waymo重启圣安东尼奥测试:洪水5个月后卷土重来
Waymo在圣安东尼奥的Robotaxi被洪水冲走并暂停服务约5个月后重新恢复运营。本文回顾事件始末,并分析自动驾驶车辆在极端天气下面临的安全挑战与行业启示。
AIOps是什么?AI如何重塑IT运维
AIOps(面向IT运维的人工智能)通过AI和机器学习实现异常检测、告警降噪与根因分析,帮助企业从被动响应转向主动预测。本文解析AIOps的核心能力与应用价值。
CCC发出邀请:40C3黑客大会以"模范公民"为主题
CCC混沌通信大会宣布第40届(40C3)以"模范公民"为主题,向全球技术爱好者发出邀请。本文解读这一欧洲最大黑客盛会的背景、主题含义及社区反响。