MiniMax H3本地部署教程:ComfyUI搭建AI视频工作站

MiniMax H3开源视频模型本地部署全攻略,从硬件选型到ComfyUI工作流实操。
本文详细介绍了开源视频模型MiniMax H3的本地部署全流程。该模型8B参数,部分场景质量优于降质版C-Dance 2.0,本地部署后可零成本无限生成视频。文章从硬件门槛讲起:最低需8GB显存+32GB内存,推荐44GB显存+64GB内存可将出片时间压缩至几十秒。随后逐步指导驱动更新、ComfyUI环境准备(须30以上版本、全英文路径)、五个模型文件的下载与放置(两个int8主模型、千问省显存模型、两个VAE解码器)、工作流配置与视频生成实操,并补充了加速插件与提示词资源。最后以核心要点总结,为创作者提供了一条从零搭建工作站的清晰路径。
为什么MiniMax H3值得关注
AI视频生成领域最近有个名字频繁被提及——MiniMax H3。这是一个8B参数规模的开源视频模型,据B站教程UP主实测,其生成质量在部分场景下甚至略优于经过降质的C-Dance 2.0。
真正让创作者兴奋的是本地部署的可能性。一旦在ComfyUI中跑通完整工作流,只要有电,就能以接近零成本的方式高速产出AI视频。相比按次付费的云端方案,这对高频创作的用户意味着成本结构的彻底改变。
不过,本地部署的门槛并不低。从硬件配置到驱动更新,从模型下载到工作流调试,每个环节都有让新手翻车的细节。本文基于实操教程,梳理出一条从零搭建MiniMax H3工作站的完整路径。
硬件门槛:你的电脑能跑吗
本地部署MiniMax H3的核心约束在显存和系统内存。教程给出的参考标准是:显存方面,RTX 10系以上即可,8GB显存是最低门槛;系统内存则需要32GB起步。
需要留意的是,官方推荐配置为44GB显存加64GB系统内存。在这个配置下,生成一条视频大约只需一分钟甚至几十秒。而8GB显存的机器虽然理论上能装,但实际运行速度可能慢到几小时出一条,甚至直接卡死,体验非常糟糕。
成本方面,最低可跑的整机配置大约一万元左右,推荐配置在一万五到两万之间,二手的话一万元也能拿下。对于认真想跑本地AI视频的创作者,这个投入并不算夸张。
查看配置的方法很简单:按Win+X打开设备管理器,在“显卡适配器”中确认显卡型号;内存和系统版本则通过设置→系统→关于查看。
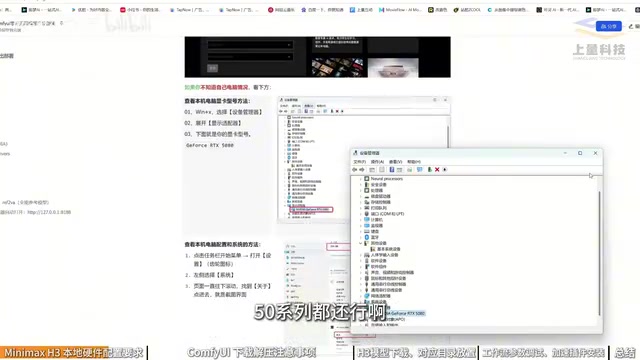
显存与系统内存的分工:显存(VRAM)主要承载模型权重和推理时的中间激活值,视频生成模型参数量虽只有8B,但由于需要处理连续多帧的高维张量,峰值显存占用远高于同规模语言模型。系统内存(RAM)则负责在显存不足时暂存模型分片、缓存潜空间数据以及供ComfyUI的Python进程调度使用。32GB内存起步是因为在加载多个模型文件和VAE解码器时,CPU侧需要足够的缓冲空间;若内存不足,系统会频繁使用虚拟内存(硬盘交换),导致生成速度断崖式下降甚至进程崩溃。因此,显存决定能否跑通,内存决定跑得是否稳定。
int8量化与fp4格式:int8指将模型权重从16位浮点数量化到8位整数,显存占用减半,推理速度提升,但会引入微小精度损失。教程强调int8效果优于其他量化版本,是因为int8在精度与效率之间平衡较好,而更激进的4位量化(如fp4)虽然进一步省显存,但可能造成画面细节丢失或运动连贯性下降。文中提到的“千问minimax-h3vfp4模型”正是采用4位浮点格式的文本编码器,用精度换显存,适合低显存设备。理解这些量化术语有助于在“能跑”和“跑得好”之间做出取舍。
驱动与ComfyUI环境准备
确认硬件达标后,第一步是更新NVIDIA显卡驱动。教程UP主特别提醒,不要使用网页上的“自动驱动更新”工具,因为装完后界面是英文的,卸载也很麻烦。更好的做法是手动输入显卡型号,在选项列表中选择对应版本。
选择驱动时有几个关键区分:带“Laptop”标记的是笔记本驱动,不带的是台式机驱动;再根据自己的系统版本选择Win10或Win11对应的驱动。安装类型选“图形驱动程序”,安装选项选“精简”即可。装完记得重启电脑。
接下来是下载ComfyUI。从GitHub官方仓库获取最新版本,教程强调必须使用30及以上版本,低于30的版本不支持H3模型。下载时注意区分显卡代际:RTX 10系及以上选NVIDIA版本,更老的显卡选CU126版本。
下载完成后解压到全英文路径,不能有中文、空格或特殊字符。打开ComfyUI目录下的Python文件,确认版本号大于等于30,环境就准备好了。
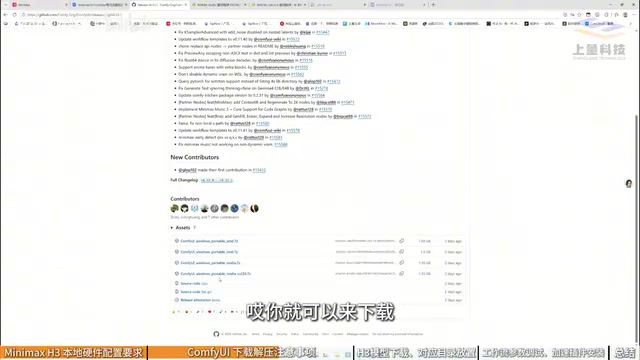
ComfyUI的版本号与CUDA关系:ComfyUI的版本号(如30、31)并非简单的迭代序号,而是与内置的PyTorch和CUDA运行时版本绑定。低于30的版本可能搭载较旧的CUDA版本,无法调用新显卡的Tensor Core指令集,也不支持H3模型所需的算子。RTX 10系及以上选NVIDIA版本,是因为官方为不同显卡代际预编译了对应的CUDA内核;老显卡选CU126版本,则指向CUDA 12.6运行时,兼容性更广但性能未必最优。若选错版本,轻则生成速度慢,重则直接报错无法加载模型。
模型文件的下载与放置
本地方案需要下载五个模型文件,这是整个部署中最容易出错的环节。
第一个是文生视频/图生视频的主模型h3f12t8,第二个是全能参考模型h3aef2vnt8,两个都选int8版本——教程明确表示int8的效果明显好于其他量化版本。第三个是千问的minimax-h3vfp4模型,主要作用是节省显存。剩下两个是视频和音频的VAE解码器。
这些模型可以从国内的ModelScope或Hugging Face下载,也可以直接通过UP主提供的网盘获取。下载后按目录结构放置:两个主模型放进ComfyUI/models/diffusion_models,千问模型放到text encoder目录,两个解码器放入vae目录。
放置完成后,在ComfyUI根目录运行脚本,浏览器会自动打开操作界面。
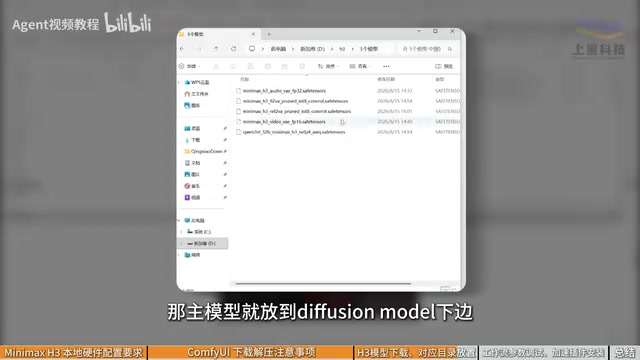
VAE解码器的作用:VAE(变分自编码器)负责将扩散模型生成的潜空间表示解码为肉眼可见的像素图像或视频帧。视频生成中通常需要两个VAE:一个用于视频帧,一个用于音频波形(若模型支持音频生成)。VAE的质量直接影响最终画面的色彩、细节和时序稳定性。若VAE文件缺失或版本不匹配,ComfyUI会在解码阶段报错,表现为黑屏或噪点。因此,将VAE文件准确放入ComfyUI/models/vae目录至关重要。
text encoder目录的用途:文本编码器将提示词转换为模型可理解的嵌入向量。千问模型作为文本编码器被放入ComfyUI/models/text_encoder(或类似名称的目录),其作用是将中英文提示词映射到与视频模型对齐的语义空间。若放错位置,工作流将找不到编码器,导致提示词无效或生成结果与描述无关。
工作流配置与视频生成实操
在ComfyUI中点击“所有模板”,找到MiniMax H3图生视频模板即可载入预设工作流。
实际操作时,上传一张参考图片(教程中用的是观音三视图),然后编写提示词。提示词可以借助豆包等工具进行中英翻译和润色。工作流中需要配置的参数包括:模型选择(图生视频选F12VA,全能参考选对应选项)、编码器和解码器(解码器通常自动匹配)。
分辨率设置方面,教程建议选择16:9宽屏比例。像素倍率0.4对应864×480,0.8对应1216×672。倍率越大生成越慢,800多的宽度已经够用。倍率参数设为32即可。
点击运行后,等待生成完成。教程演示的案例中,观音像配合台词“此地好生清净,灵气充沛,正是清修的宝地”,成功生成了视频画面。
像素倍率与分辨率的换算逻辑:像素倍率是ComfyUI中控制生成分辨率的缩放系数,通常基于模型训练时的基准分辨率(如512×512)进行倍增。倍率0.4对应864×480,意味着基准分辨率约为2160×1200除以某个系数,实际是模型预设的宽高比缩放。倍率越大,潜在空间尺寸越大,生成一帧所需的计算量呈平方级增长,因此0.8倍率下生成时间显著延长。倍率参数设为32,指的是潜在空间的下采样步长或块大小,影响VAE解码时的重叠区域,通常保持默认即可。理解这些参数有助于在画质和速度之间找到平衡点。
加速插件与提示词资源
生成速度的优化只需额外一步:从网盘下载加速模型,将三个文件复制到ComfyUI的castloader目录下,注意不能有嵌套的多层文件夹,文件必须直接放在该目录内。
提示词方面,官方提供了英文版和全能参考指南,可以作为模板参考。教程UP主也整理了经典提示词模板供评论区领取,对新手快速上手很有帮助。
本地部署只是第一步。据UP主介绍,后续还会推出云端部署课程,覆盖更多不同类型的视频生成方式,适合硬件不达标或想先低成本试水的用户。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。