MiniMax开源H3-Image:基于H3的开放权重图像模型
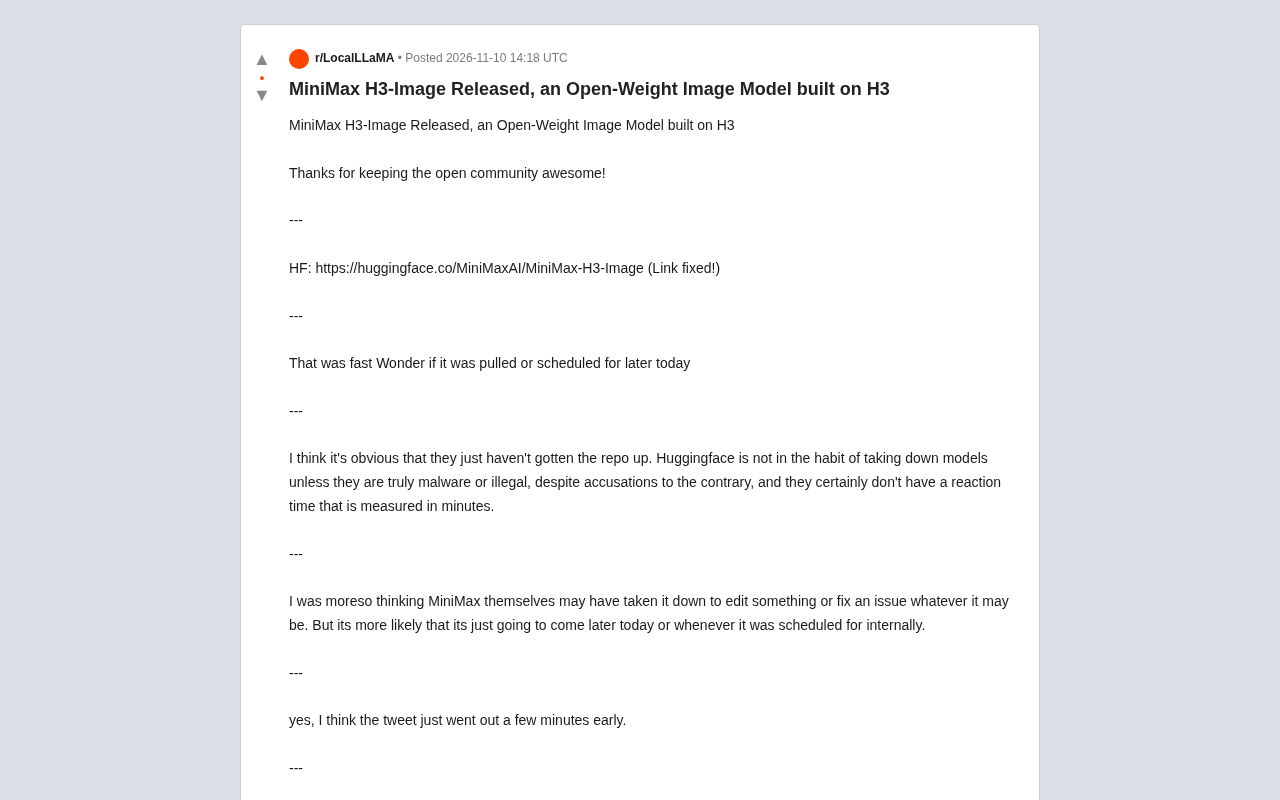
MiniMax在Hugging Face发布基于H3视频模型的开放权重图像生成模型H3-Image。
MiniMax 在 Hugging Face 发布开放权重图像模型 H3-Image,基于其 H3 视频模型构建,消息由 Reddit 社区曝出并引发热议。发布初期仓库链接短暂不可访问,社区判断是推文提前发出而非模型被撤下。据用户此前用 H3 视频模型生成单图的体验,其智能程度高于其他本地图像模型,但缺乏精细细节,且 32B 文本编码器负载沉重,因此社区期待 H3-Image 能补足这两点。开发者关注的重点集中在与 Qwen Image 2.1 的图像编辑能力对比,以及与 Moss Image、Krie 2 的文生图质量对比。开放权重有利于研究与定制,但 32B 文本编码器可能抬高消费级硬件部署门槛。
MiniMax近日在Hugging Face上发布了H3-Image,一个基于H3视频模型构建的开放权重图像生成模型。消息最早由Reddit社区曝出,随后引发开源AI社区的热议。
发布过程一波三折
根据Reddit讨论,H3-Image的Hugging Face仓库链接最初出现时无法访问,有用户猜测是模型被撤下或延迟发布。不过社区很快澄清:更可能是推文提前发出,而仓库尚未正式上线。
“Huggingface不会轻易撤下模型,除非是恶意软件或非法内容,而且他们的反应时间绝不是以分钟计的。”
多位用户认为这只是时间差问题——Tweet提前几分钟发布,仓库按内部计划稍后上线。这种“先声夺人”的发布节奏在开源社区并不罕见,但也说明MiniMax对此次发布的预热相当重视。
技术底座:站在H3的肩膀上
H3-Image的核心思路是复用H3视频模型的能力。据社区用户反馈,此前用H3视频模型配合fizgig节点生成单帧图像时,效果已经“比所有其他可用的本地图像模型都更聪明”,但存在两个明显短板:缺乏精细细节,以及32B文本编码器带来的沉重负载。
“我用H3视频配合fizgig节点做单图效果不错。它比其他本地图像模型聪明得多,但缺乏细节,而且因为32B文本编码器非常重。我高度期待这次发布能解决这两个问题。”
这段一手体验透露出关键信息:H3-Image并非从零训练,而是对H3视频生成能力的图像化延伸。如果MiniMax能在保持“聪明”的同时补足细节表现、优化推理负担,这个模型有望在开源图像生成领域占据独特位置。
开放权重(Open Weights) 指模型训练完成后,权重参数可公开下载、供任何人使用和微调,但不一定附带训练数据或完整训练代码。与完全开源的模型(如附带数据与训练脚本)相比,开放权重更侧重“可用性”而非“可复现性”。在图像生成领域,Stable Diffusion 系列是开放权重的典型代表,它催生了大量社区微调模型与工具链。对研究者而言,开放权重意味着可以在本地复现推理结果、做针对性微调;对企业而言,则需注意许可证对商用、再分发和衍生模型命名的限制。MiniMax 以开放权重形式发布 H3-Image,实质上是在可控的知识产权边界内换取社区生态与反馈速度。
文本编码器(Text Encoder) 是文生图/视频模型中将提示词转换为语义向量的组件,其规模直接影响显存占用与推理延迟。常见开源方案多用 CLIP(约 1.2 亿至 3.5 亿参数)或 T5-XXL(约 47 亿参数)。文中提到的 32B 文本编码器属于超大规格,单是加载该编码器就可能需要数十 GB 显存(取决于精度),远超多数消费级显卡(8–24 GB)的承载能力。这也是社区对 H3-Image 部署门槛的主要担忧:即便扩散主干本身不大,文本编码器也可能成为瓶颈。量化、CPU 卸载或更换轻量编码器是常见的缓解手段,但往往以牺牲语义理解为代价。
社区最关心的两件事
从讨论来看,开发者对H3-Image的期待集中在两个方向。
一是图像编辑能力。 有用户直接将其与Qwen Image 2.1对比,想知道H3-Image在编辑任务上能否匹敌。Qwen系列在图像编辑上积累了不错的口碑,H3-Image作为后来者需要证明自己。
二是文生图质量。 与Moss Image、Krie 2等模型的横向对比也被提及。此前H3视频工作流在文生图上表现不佳,用户好奇H3-Image是否能“ nail it”——即真正把文生图质量做上去。
这两个问题目前尚无定论,但反映出开源图像模型赛道的竞争已经细化到编辑、文生图、细节还原等具体维度。
图像编辑(Image Editing) 与文生图是两类不同任务:后者从噪声生成图像,前者在给定原图与指令(如“把天空换成黄昏”)下修改局部内容,要求模型同时理解视觉结构与文本意图,并保持未编辑区域的一致性。评测上常用 InstructPix2Pix、MagicBrush 等基准,关注指令遵循度、背景保真度和编辑区域的自然度。Qwen-Image-Edit 系列之所以口碑较好,部分得益于其底层多模态大模型对中英文指令和文字渲染的强理解。H3-Image 若要在编辑任务上匹敌,不仅需要生成质量,还需具备图像条件输入与区域感知能力,这与纯文生图的架构要求并不完全相同。
开放权重意味着什么
MiniMax选择以开放权重形式发布H3-Image,Reddit帖子中一句“感谢让开源社区保持精彩”道出了社区的情绪。在图像生成领域,开放权重模型的可复现性和可定制性对研究者与独立开发者尤为重要。
不过开放权重也带来现实挑战:32B文本编码器的体量摆在那里,本地部署的门槛不会低。H3-Image能否在消费级硬件上跑出可用的速度,将直接影响它的实际采用率。
消费级硬件部署 通常指在单张 8–24 GB 显存的消费级 GPU(如 RTX 3060/4070/4090)上运行模型。图像扩散模型的显存占用主要来自三部分:文本编码器、UNet/DiT 主干和 VAE 解码器。以 SDXL 为例,其文本编码器合计约 8 亿参数,在 FP16 下约占 1.6 GB,整模型可在 8 GB 显存上以优化方式运行。若文本编码器达到 32B 参数,即便采用 4-bit 量化也需约 16 GB 以上,加上主干和中间激活,实际需求会更高。因此社区常用的手段包括分阶段加载(先编码文本再卸载)、GGUF 量化、以及用轻量编码器替换,但这些方案都会增加配置复杂度并可能影响提示词遵循质量。
值得关注的信号
H3-Image的发布节奏和社区反应透露出一个趋势:视频模型与图像模型的边界正在模糊。用视频模型的能力反哺图像生成,是一条值得关注的技術路径。MiniMax此次把H3的“聪明”移植到图像侧,如果能同时解决细节与效率问题,开源图像模型的格局可能会多一个有力竞争者。
目前模型已在Hugging Face上线,实际表现有待社区大规模测试验证。
相关推荐

Claude Code进阶指南:10个技巧告别手动审批
基于The Benmore Brief的Claude Code进阶教程,整理10个实用技巧:从自动模式、努力等级、旁支聊天到手机远程控制和定时任务,帮助初学者摆脱逐项审批,让AI在你不在场时也能推进工作。

字节扣子为何突然失声?AI工作流过时与内部布局摇摆
字节扣子从AI必学工具到声音渐弱,B站UP主分析其工作流模式过时、编程转型不力,以及字节在Workbody竞争压力下对豆包、飞书、Tree Work的资源重新权衡,扣子团队或面临合并解散。
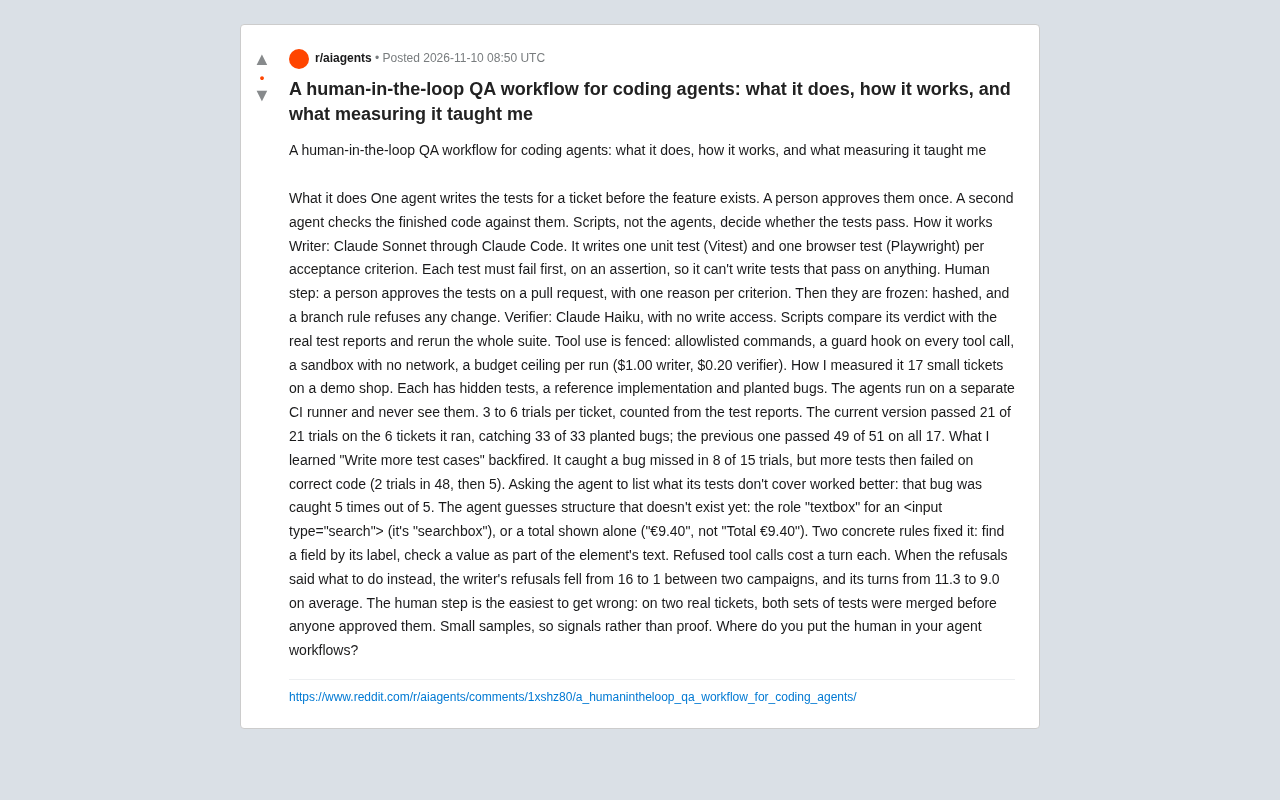
人类在环QA工作流:为编码智能体加上测试门禁
Reddit开发者分享编码智能体的人类在环QA工作流:智能体先写测试、人工审批冻结、脚本裁决结果。实测17个工单,发现多写测试反而增加误报,让智能体列出未覆盖范围更有效。