人类在环QA工作流:为编码智能体加上测试门禁
一套让智能体先写失败测试、人工冻结、脚本裁决的人类在环QA工作流及实测经验。
文章拆解了Reddit开发者提出的人类在环QA工作流:编写者智能体先为每个验收标准写出会失败的单元测试与浏览器测试,经人工在PR上批准并哈希冻结后,只读验证者智能体检查代码,最终由脚本重新运行测试套件做事实裁决。作者用17个带隐藏测试和预埋bug的工单测量效果,发现多写测试用例反而增加误报,让智能体列出未覆盖范围更有效;智能体会猜测不存在的UI结构,需用具体规则约束;拒绝工具调用时附带指引可显著减少轮次。结论是把确定性交给脚本、判断留给人、生成交给智能体,并确保人工闸门无法被绕过。
为什么编码智能体需要人类在环的QA流程
让AI智能体写代码已经不再是新鲜事,但如何确保它写出的代码真正符合需求,仍然是一个棘手的问题。Reddit上一位开发者分享了一套人类在环(human-in-the-loop)的QA工作流,试图用「先写测试、人工审批、再由脚本裁决」的方式,约束编码智能体的行为。这套流程的核心思路并不复杂:让智能体在功能存在之前先写出测试,由人类一次性批准,最后用脚本而非智能体来判断测试是否通过。
这篇文章将拆解这套工作流的具体设计、测量方法以及作者在实测中得到的经验教训,并讨论它对AI编程实践的启示。
工作流拆解:三个角色与一道人工闸门
写测试的智能体:先失败,再冻结
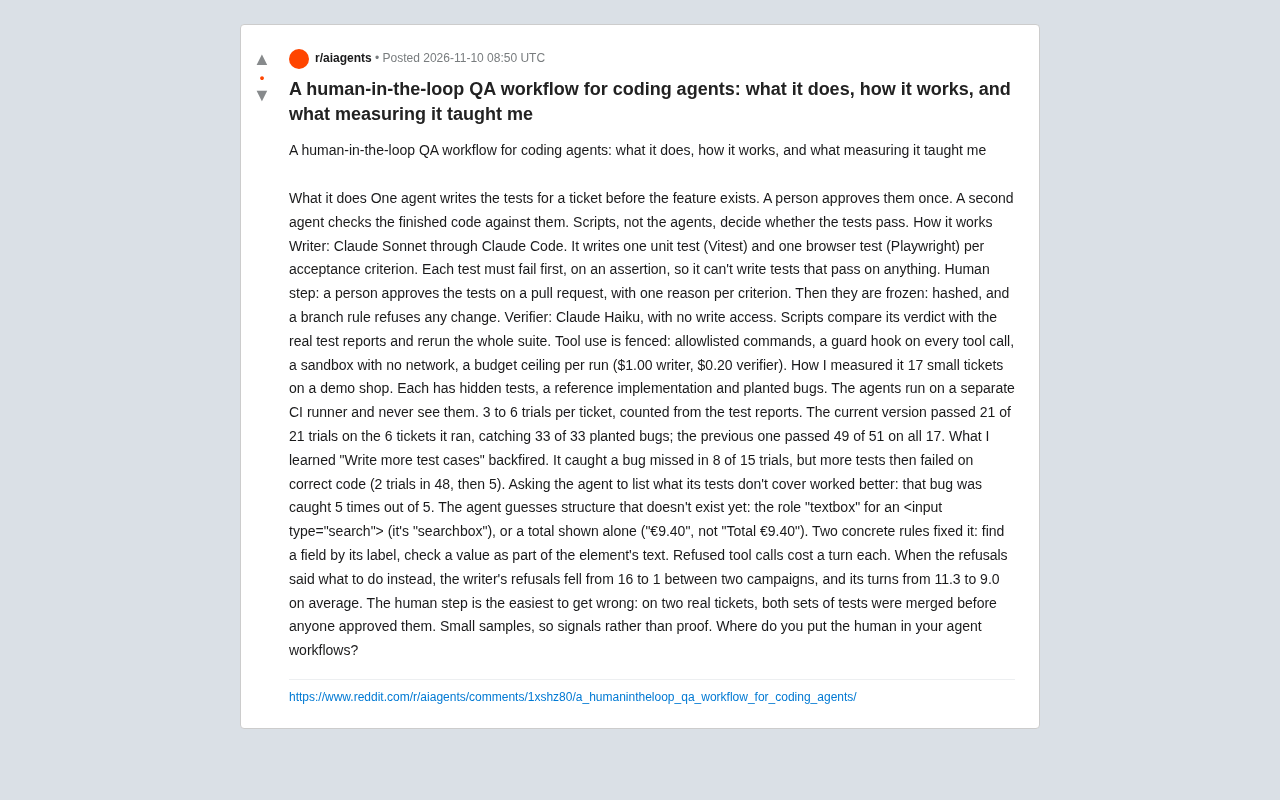
作者使用Claude Sonnet(通过Claude Code)担任「编写者」角色。针对每个验收标准,它需要写一个单元测试(Vitest)和一个浏览器测试(Playwright)。关键约束是:每个测试必须先在断言上失败,这样它就无法写出「无论代码怎样都能通过」的无效测试。
测试写完后进入人工环节:由一个人在Pull Request上批准这些测试,并且每个验收标准都要给出批准理由。一旦批准,测试即被冻结——计算哈希值,并通过分支规则拒绝任何后续修改。这相当于给测试本身加了一把锁,防止智能体在实现阶段回头篡改测试来「凑通过」。
Vitest 是基于 Vite 构建的 JavaScript/TypeScript 单元测试框架,特点是启动快、与 Vite 的模块解析和转换管线无缝集成,适合在 Node 环境或组件级别快速验证逻辑。Playwright 则是微软开源的端到端(E2E)浏览器测试工具,可驱动 Chromium、Firefox、WebKit 真实渲染页面,支持自动等待、多标签页、网络拦截等能力。二者组合的典型分工是:Vitest 覆盖纯函数、状态逻辑和组件契约,Playwright 覆盖真实浏览器中的交互与可访问性行为。文中「单元测试 + 浏览器测试」的双层设计,正是让智能体分别面对逻辑层和 UI 层的验收标准,避免只写一类测试而留下盲区。
测试冻结(test freezing) 指在测试被人工批准后,对其内容计算哈希值并记录,再通过 CI 的分支保护规则或钩子拒绝任何后续改动。其目的是切断智能体「改测试以凑通过」的捷径:如果测试可以被随意修改,智能体就可能把断言改松、删掉失败用例,从而让实现看起来正确。哈希值相当于测试版本的指纹,一旦提交的测试文件哈希与批准记录不符,流水线即失败。这一机制把「测试即契约」落到实处,使测试从可编辑的草稿变成受保护的验收基准。
验证者智能体:只读,不写
验证环节由Claude Haiku担任,它没有写权限,只负责根据已冻结的测试检查完成后的代码。但最终裁决权不在它手里:脚本会将它的判断与真实的测试报告进行比对,并重新运行整个测试套件。换句话说,智能体提供的是「意见」,脚本提供的是「事实」。
工具使用也被严格围栏化:允许列表命令、每次工具调用都有守卫钩子、无网络的沙箱环境,以及每次运行的预算上限(编写者1.00美元,验证者0.20美元)。
只读权限(read-only) 在智能体设计中是一种最小权限原则的体现:验证者只能读取代码、测试和报告,不能写文件、改配置或执行会改变仓库状态的命令。这样即使验证者产生错误判断,也无法污染代码库或篡改测试。配合沙箱环境(无网络、受限文件系统)和守卫钩子(对每次工具调用做允许列表检查),可以把智能体的行为限制在可审计的范围内。预算上限则从成本维度提供第二道保险,防止失控循环消耗资源。
人工闸门:最容易出错的一环
作者特别指出,人类环节是「最容易搞错的部分」。在两个真实工单上,两套测试都在任何人批准之前就被合并了。这个细节说明:流程设计得再好,如果人工审批没有被强制执行,整个门禁就会形同虚设。
测量方法:17个工单与隐藏测试
为了验证这套工作流的有效性,作者在一个演示商店项目上设置了17个小型工单。每个工单都有隐藏测试、参考实现和预埋的bug。智能体在独立的CI runner上运行,完全看不到这些隐藏测试。每个工单运行3到6次试验,结果从测试报告中统计得出。
数据显示:当前版本在其运行的6个工单上通过了21/21次试验,捕获了33/33个预埋bug;此前的版本在全部17个工单上通过了51次试验中的49次。作者也坦承样本量较小,这些是「信号而非证明」。
实测中的四条经验教训
「多写测试用例」适得其反
直觉上,写更多测试应该能捕获更多bug。但实测结果相反:增加测试数量确实捕获了一个在15次试验中漏掉8次的bug,但代价是更多正确代码被错误地判定为失败——48次试验中出现2次,之后上升到5次。测试越多,误报越多。
让智能体列出「未覆盖范围」更有效
相比堆砌测试数量,要求智能体明确列出它的测试没有覆盖什么效果更好:那个bug在5次试验中被捕获了5次。这让智能体主动暴露自己的盲区,而不是盲目扩大测试面。
测试覆盖率(coverage) 通常指代码行、分支或函数被测试执行到的比例,但它只说明「执行过」,不说明「断言过」。智能体很容易写出高覆盖率却低断言强度的测试,因此单纯追求覆盖率数字会误导。让智能体显式列出「未覆盖范围」,本质是要求它做一次覆盖缺口分析:说明哪些验收标准、边界条件、错误路径尚未被测试触及。这种自述式清单比覆盖率报告更贴近语义层面,也便于人类审批时判断测试是否足够,从而把盲区从隐性变为显性。
智能体会「猜」不存在的结构
编写者智能体会对尚未存在的UI结构做出错误假设。例如,它为<input type="search">猜了「textbox」角色(实际是「searchbox」),或者把带合计的文本写成孤立的「€9.40」而不是「Total €9.40」。作者用两条具体规则修复了这个问题:通过标签查找字段,将值作为元素文本的一部分来检查。
拒绝的工具调用消耗轮次
当工具调用被守卫拒绝时,每次都会消耗一个轮次。作者发现,如果拒绝信息中说明应该怎么做,编写者的拒绝次数在两个活动之间从16次降到1次,平均轮次从11.3降到9.0。拒绝不只是拦截,更应该是指引。
对AI编程实践的启示
这套工作流的价值不在于它用了多强的模型,而在于它把确定性的部分交给脚本,把判断性的部分留给人,把生成性的部分交给智能体。测试先行的约束、测试冻结的机制、验证者的只读权限,都是在用工程手段限制智能体的自由度。
作者最后抛出的问题值得每个使用编码智能体的人思考:你会把人类放在智能体工作流的哪个位置? 从这次实测来看,答案很可能是——放在测试被写出来之后、代码被写出来之前,并且确保这个位置无法被绕过。
相关推荐

Claude Code进阶指南:10个技巧告别手动审批
基于The Benmore Brief的Claude Code进阶教程,整理10个实用技巧:从自动模式、努力等级、旁支聊天到手机远程控制和定时任务,帮助初学者摆脱逐项审批,让AI在你不在场时也能推进工作。

字节扣子为何突然失声?AI工作流过时与内部布局摇摆
字节扣子从AI必学工具到声音渐弱,B站UP主分析其工作流模式过时、编程转型不力,以及字节在Workbody竞争压力下对豆包、飞书、Tree Work的资源重新权衡,扣子团队或面临合并解散。
MiniMax开源H3-Image:基于H3的开放权重图像模型
MiniMax发布开放权重图像模型H3-Image,基于H3视频模型构建。社区关注其图像编辑能力、文生图质量及32B文本编码器带来的部署负担,有望与Qwen Image 2.1等模型展开竞争。