Mistral Large 4测评:欧洲最强开源模型能否挑战中美?
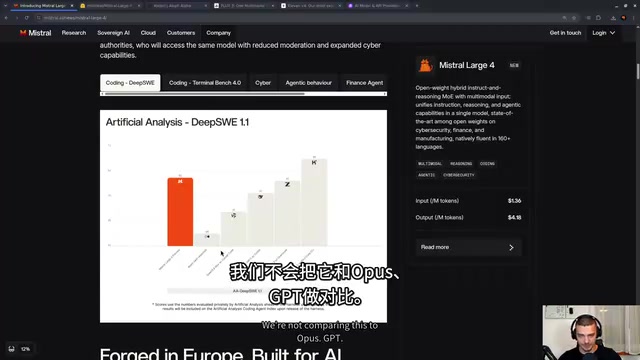
Mistral Large 4让欧洲首次拥有接近前沿的开源模型,但综合能力仍落后中美头部。
Mistral Large 4(代号L-Charm)是欧洲AI公司Mistral推出的万亿参数MoE开源模型,被视为非中国出品的最强开源模型。它采用稀疏激活架构,推理效率高,但定价在开源模型中偏高。基准测试显示其网络安全CTF能力突出(19题解18题且最快),软件工程却明显落后于Kimi K3,呈现偏科特征。综合智能排名未进前十,大致相当于OPS 48、Sonnet 46等水平。模型完全在欧洲数据中心训练,仅用3800块GPU,工程效率突出,主打主权AI与合规场景。自定义测试表明其回答简洁但AI套话频率高,ChatGPT克隆版实测存在语音输入与模型选择故障。总体定位是欧洲AI从缺席到在场的里程碑,而非改变格局的突破。
欧洲AI正在重新进入讨论范围。Mistral推出的Mistral Large 4(代号L-Charm)被不少观察者视为目前非中国出品的最强开源模型。这个定位听起来不错,但背后有一个更冷静的判断:最好的闭源模型仍在美国,最好的开源模型仍在中国。Mistral Large 4的意义不在于登顶,而在于让欧洲第一次有了接近前沿水准的本土替代方案。
万亿参数MoE架构:大而不笨
Mistral Large 4采用专家混合(MoE)架构,总参数达到万亿级别,但生成单个Token时只有一小部分参数活跃。这种设计让它在保持庞大知识容量的同时,推理速度远快于同等规模的密集型模型——加载占用空间大,但实际生成效率高。
模型目前尚未在Hugging Face开放下载,页面显示倒计时,预计在月底发布权重。开放权重模型的发布节奏通常如此:先公布基准和定价,再逐步放出权重。封面截图来自视频基准对比环节,博主在此处说明对比口径并不完全公平。
成本方面,百万输入Token约1美元出头,输出则要4美元多,在开源模型中不算低。结合性能来看,这一定价偏高,但考虑到它主打的是欧洲本土合规和主权AI场景,价格并非唯一决策因素。
专家混合(Mixture of Experts, MoE) 是一种稀疏激活的神经网络架构。与传统密集型模型每次推理都激活全部参数不同,MoE 模型将前馈层拆分为多个“专家”子网络,并通过一个可学习的路由门控网络,为每个输入 Token 动态选择少数几个专家参与计算。因此,尽管总参数量可达万亿级别,但单个 Token 的实际计算量(即活跃参数量)可能只有几百亿,从而在保持大容量知识存储的同时大幅降低推理成本。MoE 的挑战在于负载均衡与训练稳定性:路由容易坍缩到少数专家,需要辅助损失函数来鼓励专家利用率均匀。此外,MoE 模型对显存的需求较高,因为所有专家参数都需加载到内存或显存中,即使每次只用到一部分。Mistral Large 4 利用这一架构在有限算力下实现了接近前沿模型的性能,但高显存占用也解释了其相对较高的使用成本。
基准测试:网络安全亮眼,软件工程有差距
在网络安全CTF速通测试中,Mistral Large 4是表现最突出的模型之一:共19道挑战题,它解决了18道,速度也是最快的,是少数能与最先进闭源模型正面竞争的选手。在网络安全专项基准上,它与GRM 5.3 Flash水平相当。
但在深度软件工程测试中,它不如Kimi K3,差距明显;终端基准测试中高于Kimi K3但低于GRM 5.3。金融Agent表现与GRM 5.3大致相当,法律Agent和数据依托能力方面则是最强模型。这种“偏科”特征说明它在安全与专业领域有独特优势,通用编程任务则不是它的主战场。
博主特别提醒,企业选特定基准做对比往往带有营销目的,Mistral本身相对诚实、不伪造基准,但更中立的参考还是人工分析类的聚合评分。在人工分析智能项排名中,Mistral Large 4作为非中国开源模型排名靠前,但整体进不了前十或前十五。
CTF(Capture The Flag) 是网络安全领域的一种竞赛形式,参赛者需通过解决安全挑战(如逆向工程、漏洞利用、密码学、Web 安全等)来获取隐藏的“flag”。CTF 速通测试通常要求模型在限定时间内自动分析题目、编写利用脚本并获取 flag,综合考察模型的代码理解、推理与工具使用能力。由于题目类型多样且常需多步推理,CTF 成绩能较好反映模型在安全场景下的实战水平。Mistral Large 4 在 19 道挑战中解决 18 道且速度最快,说明其在安全领域的代码生成与逻辑推理能力突出,但这并不直接等价于通用软件工程能力,后者更强调大型代码库理解、架构设计与调试,因此两项基准出现分化是合理现象。
与中美模型的真实差距
据B站UP主的测试和Arena类平台数据交叉验证,Mistral Large 4在编程和网页开发维度的得分排名并不突出,大致相当于OPS 48、Sonnet 46或GPT 56 Terra X的水平。这个结果符合预期:它是一款成熟模型,但不是前沿核心模型。
这里存在一个需要如实呈现的分歧:基准数据显示它在部分安全测试中接近顶尖,但综合智能排名和实际编程体验又明显落后于中美头部模型。博主的结论是,即便用强化学习继续优化,它也进不了前十。两个信号并不矛盾——专项能力突出与综合能力平庸可以同时存在。
值得注意的细节是,目前测试的是Preview版本,训练尚未完成,仍在进行强化学习。理论上正式版分数还有提升空间。
人工分析智能指数(Artificial Analysis Intelligence Index) 是一个聚合多个独立基准(如 MMLU、HumanEval、GPQA 等)的第三方评测体系,旨在减少单一基准带来的偏差,提供更中立的模型能力排序。与厂商自行选取的基准不同,聚合评分通常覆盖推理、编程、数学、知识问答等多维度,并对各基准进行标准化加权。文章引用该指数说明 Mistral Large 4 在非中国开源模型中排名靠前,但整体未进前十或前十五,这一结论与专项测试的亮眼表现并不矛盾——专项能力(如网络安全)的突出无法掩盖综合智能水平与前沿模型的差距。读者在评估模型时,应区分“厂商宣传基准”与“中立聚合评分”的参考价值。
3800块GPU背后的工程实力
Mistral Large 4完全在欧洲数据中心训练,使用的是美国产NVIDIA硬件,但只用了3800块GPU。相比其他前沿实验室的算力投入,这个数字少得多,足以说明Mistral团队的工程效率。
这也是欧洲主权AI叙事的关键一环:监管更简单,合规路径更清晰,对处理敏感数据的企业来说,用欧洲训练的欧洲模型是更稳妥的选择。博主认为这是低轮融资支持路线图上的第一个里程碑,后续还有更多模型和算力投入。
主权 AI(Sovereign AI) 指一个国家或地区为保障数据安全、技术自主与监管合规,而推动建设本土化人工智能基础设施与模型能力的战略。其核心诉求包括:数据不出境、训练与推理过程受本地法律管辖、减少对国外技术供应商的依赖。对于处理金融、医疗、政务等敏感数据的企业,使用在本土数据中心训练、符合当地监管的模型,能显著降低合规风险。Mistral Large 4 完全在欧洲数据中心训练,正是主权 AI 叙事的典型实践——尽管硬件仍来自美国 NVIDIA,但训练数据、模型权重与运营主体均位于欧洲,为欧洲企业提供了介于“美国闭源 API”与“中国开源模型”之外的第三种选择。
自定义实测:简洁但啰嗦的AI腔
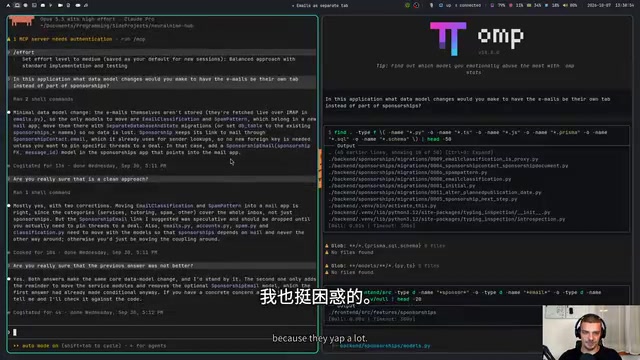
博主用自己的Nero Yap Benchmark做了补充测试,评估模型的啰嗦程度、AI套话频率和排版结构化程度。Mistral Large 4四项分数都偏低——分数越低代表表达越简洁。在长度控制上它属于测试中的顶尖水平,回答相当简练,也没有之前Mistral模型那么啰嗦。
问题出在AI套话上。它频繁使用“你有权反对”这类典型AI用语,用词冗长,博主认为这是个不好的信号,频率甚至高于DeepSeek广告 V-Flash和Sonnet 5。排版方面连字符和AI符号偏多,但还不算真正意义上的乱写。
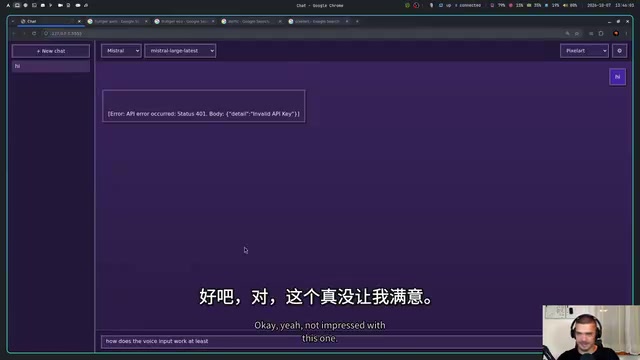
在ChatGPT克隆版的提示词实测中,要求包括多服务商下拉菜单、自动识别API密钥、设置界面、语音输入和多种主题。Mistral Large 4的界面细节丰富,主题切换基本可用,但语音输入和模型选择出现问题,博主一度无法正常使用。
对比之下,Kimi K3在该测试中生成结果最好,DeepSeek和GLM 5.3 Flash各有明显缺陷。博主强调这个基准仍处于早期版本,测试工具本身也可能影响结果,需要谨慎看待。
结论:欧洲重回牌桌的一步
Mistral Large 4不是改变格局的模型,但它证明欧洲可以在算力有限的情况下做出接近前沿水准的开源模型。对欧洲企业而言,合规、主权和本地数据中心的价值可能比基准分数更重要。博主对它的评价是“大胜”——不是对中美领先地位的胜利,而是对欧洲AI生态从缺席到在场的胜利。
后续值得关注的是技术报告发布和权重正式开放下载,以及Mistral在算力扩张后的下一步动作。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。