Naive RAG vs 高级混合RAG:检索增强生成的两种范式

本文对比Naive RAG与Advanced Hybrid RAG的架构差异,阐明多路召回与重排序如何提升检索质量。
RAG(检索增强生成)有两种典型实现路径。Naive RAG 仅执行一次向量相似度检索,将召回片段直接送入LLM,优点是实现简单、响应快,适合原型验证;缺点是无法精确匹配术语、缺乏过滤与重排,在大规模生产环境中答案质量有限。Advanced Hybrid RAG 则结合向量搜索(语义匹配)、BM25关键词检索(精确术语命中)、元数据过滤(结构化收窄)和交叉编码器重排序(精细打分)四个环节,以更高的工程复杂度换取显著更好的召回精度和答案可信度。两种架构并非替代关系,而是分别对应不同的项目阶段与需求层级:早期验证用Naive RAG快速跑通,进入生产后混合RAG几乎是必然选择。
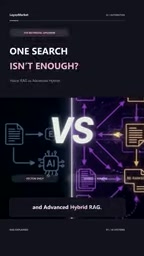
检索增强生成(RAG)已成为构建企业级大模型应用的核心技术,它让 LLM 能够基于外部知识库生成更准确、可溯源的答案。但在实际落地中,RAG 并非只有一种实现方式。一条 YouTube 技术教程清晰地拆解了两种典型架构的差异:Naive RAG(朴素RAG) 与 Advanced Hybrid RAG(高级混合RAG)。理解这两者的区别,是设计可靠检索管线的第一步。
Naive RAG:简单直接的单路检索
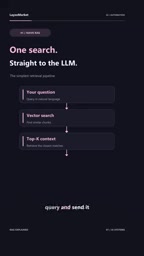
Naive RAG 的工作流程非常直白:用户提问后,系统将查询转换为向量,执行一次向量相似度搜索,取回最相关的若干片段,然后直接把这些上下文连同原始问题一起塞进 LLM,生成答案。
整条链路只有一个检索环节,没有额外的过滤或重排。原视频用了一个贴切的比喻:Naive RAG 就像让图书管理员仅凭书名快速扫一眼,就抓取书架上的第一本书。它的优势在于实现简单、响应快,非常适合原型验证和快速演示。
但这种简洁也带来明显短板。单一向量检索对语义相近但表述不同的查询友好,却容易忽略精确关键词匹配;没有元数据过滤意味着无法按时间、来源、权限等维度收窄范围;缺少重排序则导致召回结果的相关性排序不够精细。在知识库规模大、问题复杂的生产环境中,这些缺陷会直接拉低答案质量。
向量相似度搜索的底层依赖文本嵌入模型(Embedding Model),它将文本片段映射到高维稠密向量空间,语义相近的文本在该空间中距离更近。常用的距离度量包括余弦相似度和点积。为了在数百万级别的向量中实现毫秒级检索,实际系统通常采用近似最近邻(ANN)索引结构,如 HNSW 或 IVF,以少量精度损失换取大幅度的速度提升。这也意味着 Naive RAG 的召回质量上限,很大程度上取决于所选嵌入模型对领域文本的表征能力——若嵌入模型对特定专业领域的术语理解不足,即使检索逻辑完全正确,召回结果也会系统性偏差。
Advanced Hybrid RAG:多路召回与精排的组合拳
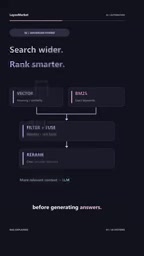
高级混合 RAG 的核心思路是:在生成答案之前,用多种检索策略叠加过滤,尽可能提升送入 LLM 的上下文质量。根据原视频的拆解,它通常整合以下几个环节:
- 向量搜索(Vector Search):捕捉语义层面的相关性
- 关键词检索(BM25):补足精确术语匹配能力
- 元数据过滤(Metadata Filtering):按结构化属性收窄候选集
- 交叉编码器重排序(Cross-Encoder Re-ranking):对候选片段做精细化打分排序

视频同样给出了形象的类比:如果说 Naive RAG 是一个人凭书名随手抓书,那么 Advanced Hybrid RAG 就像一支研究团队同时检索多个索引、过滤结果、再从中挑出 Top 3 经过验证的页面。两种方法在召回的广度、精度和可信度上,存在数量级的差距。
为什么混合检索能提升效果
向量搜索与 BM25 本质上互补:前者擅长理解“意思相近”,后者擅长命中“字面精确”。单独使用任何一种都会漏召回。把两者结果合并后,再用交叉编码器对每个候选做 query-document 联合打分,能有效把真正相关的片段排到前面。而元数据过滤则在检索前就排除了无关文档,既提升精度也降低了后续计算成本。
BM25(Best Match 25)是信息检索领域经典的词频统计算法,由 Okapi BM25 发展而来。它的核心思想是综合考量词项频率(TF)、逆文档频率(IDF)以及文档长度归一化,对查询关键词与文档的字面匹配程度打分。与向量嵌入不同,BM25 完全基于词汇重叠,不涉及语义理解——这恰恰是它的优势:对专有名词、产品型号、人名、代码函数名等精确术语的命中非常可靠,不会因为向量空间中的近似压缩而丢失关键信息。
交叉编码器(Cross-Encoder)则是重排序阶段的关键组件。它与向量检索中用于生成嵌入的双编码器(Bi-Encoder)不同:双编码器将查询和文档分别编码为独立向量,计算速度快但表达粒度有限;交叉编码器则将查询与候选文档拼接后一同输入模型,让注意力机制在两段文本之间充分交互,从而输出更精准的相关性分数。代价是无法预先缓存文档向量,只适合对候选集(通常 20-100 个)做精排,而非全量检索。
如何选择:场景决定架构
两种架构并非谁取代谁,而是服务于不同阶段和需求:
| 维度 | Naive RAG | Advanced Hybrid RAG |
|---|---|---|
| 实现复杂度 | 低 | 高 |
| 响应速度 | 快 | 相对较慢 |
| 召回精度 | 一般 | 高 |
| 适用场景 | 原型验证、小型知识库 | 生产环境、大规模高要求场景 |
对于早期验证想法、知识库较小的项目,Naive RAG 足以快速跑通闭环。当应用进入生产阶段、对答案准确性和可溯源性要求提高时,引入混合检索与重排序几乎是必然选择。
小结
Naive RAG 与 Advanced Hybrid RAG 的本质区别,在于检索环节的投入程度:前者用一次向量搜索换取速度,后者用多路召回加精排换取质量。理解这条光谱,开发者才能根据自身的数据规模、准确性要求和延迟预算,做出合理的工程取舍。随着 RAG 应用从 demo 走向生产,混合检索架构正逐渐成为高质量问答系统的标配。
相关推荐

小米MiMo-V2.6实测:登顶全球开源模型,价格仅为对手几十分之一
小米MiMo-V2.6全模态大模型发布实测:以46分登顶全球开源模型榜单,性能对标Claude、GPT顶级闭源旗舰,而算力成本仅为对手的二十到六十分之一,并同步开源训练环境与代码。本文梳理其跑分、价格、3D推理与开发者实测表现。

20多个孩子背后的代孕黑幕:一对夫妇被捕引发监管拷问
一对夫妇通过代孕生下超过20个孩子,因涉嫌虐童和恐吓证人被捕,保释金2000万美元。案件揭开美国代孕产业监管真空,代孕妈妈Kayla的发现成为关键转折点。

Claude Opus 5.5爆料隐测,直指GPT-6正面对决
Claude Opus 5.5被爆以Cloud Wafer为代号隐蔽测试,表现或超越GPT-6 Sol;同期Grok 4.7短暂上线、智谱ZCode开源整改、硅基流动SIM 4.0开放免费调用、签问Image 2.1许可澄清。本文梳理多条AI动态并厘清传闻与事实边界。