NaiveAI宣称每秒2100 Token,编码能力实测对标DeepSeek

NaiveAI宣称每秒2100 Token且编码质量比肩DeepSeek,速度与质量或可兼得。
文章围绕NaiveAI声称的每秒2100 Token输出速度展开分析。这一数字远高于主流模型几十到几百Token/秒的常规水平,若能在真实负载下稳定维持,将显著改善代码补全、多轮调试和批量生成等编码场景的体验。实测结论称其编码质量可与DeepSeek比较,暗示速度与质量的传统权衡可能被打破。但文章也指出,速度宣称需区分峰值与长上下文持续生成速度,原始素材未披露测试集和评分方式,结论应视为方向性判断。开发者采用前还需关注API稳定性、限流策略和输出合规性,并期待更多独立可复现的评测。
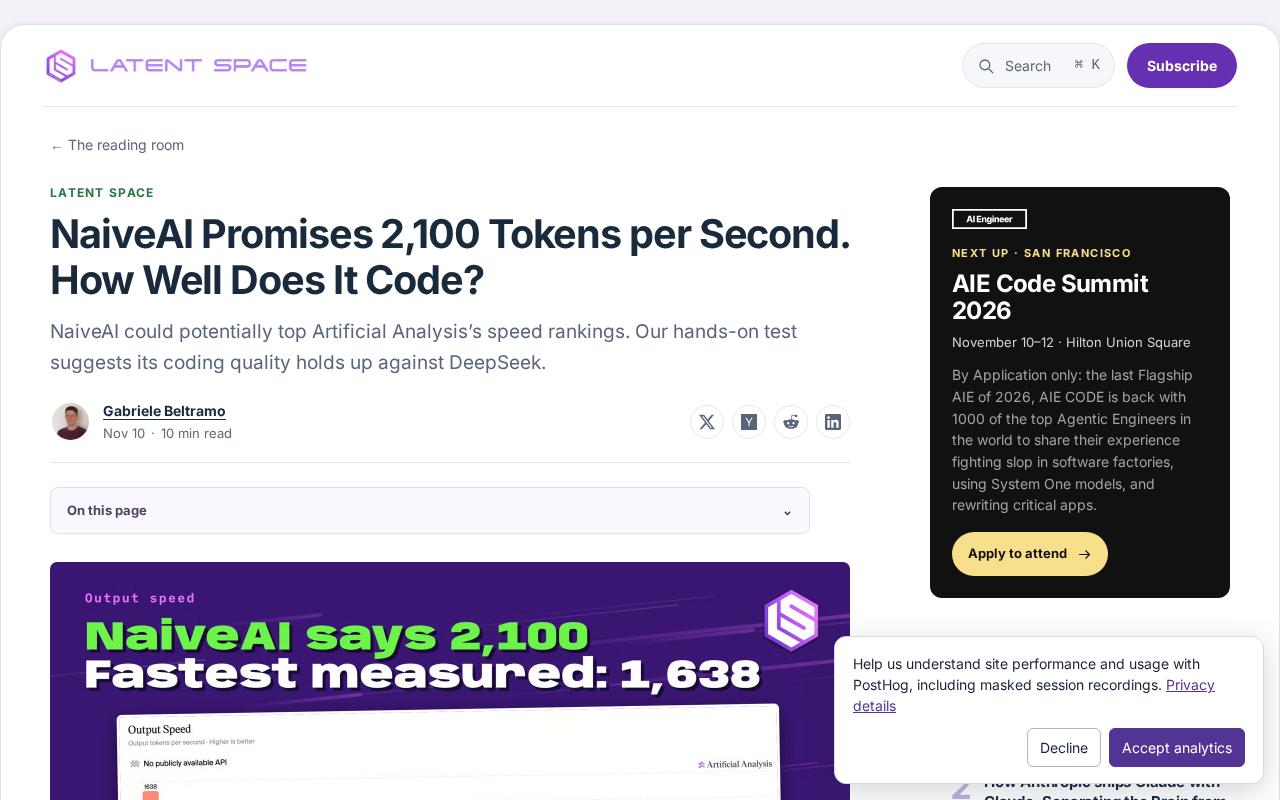
AI推理速度的竞赛正在进入一个新阶段。一家名为NaiveAI的公司声称其模型能够达到每秒2100个Token的输出速度,这一数字如果属实,将有可能登顶Artificial Analysis的速度排行榜。但速度之外,开发者更关心的是:它写代码到底行不行?
速度宣称背后的技术含义
每秒2100 Token是一个值得拆解的数字。作为参照,主流大模型在常规API调用中的输出速度通常在几十到几百Token每秒的区间,2100 Token/秒意味着输出效率可能达到数量级的提升。这种速度如果能在真实负载下稳定维持,对于需要频繁交互的编码场景——比如实时代码补全、多轮调试对话、大规模代码生成——会带来体验上的显著变化。
不过,速度宣称本身需要区分测试条件。峰值速度、短文本爆发速度与长上下文持续生成速度是三个不同的指标。NaiveAI能否在长代码文件生成时保持这一速率,是判断其实用价值的关键。
Token 是大语言模型处理文本的基本单位,可以理解为词片段:一个英文单词可能被切分为 1-3 个 Token,一个汉字通常对应 1-2 个 Token。因此「每秒 2100 Token」大致相当于每秒输出 1000-2000 个汉字或 1500 个左右英文单词,这比正常人的阅读速度快两个数量级以上。
Artificial Analysis 是一个独立的第三方模型评测与追踪平台,它维护多个排行榜,涵盖推理速度(输出 Token/秒)、首 Token 延迟、价格和综合质量指数等维度,被开发者和研究者广泛用作选型参考。其速度数据通常基于标准化 API 调用测得,不同厂商的部署环境和采样参数会影响结果,因此榜单排名需结合测试条件解读。
编码质量实测:与DeepSeek的对比
据原始素材的实测结论,NaiveAI的编码质量“经得起与DeepSeek广告的比较”。DeepSeek在开发者社区中以代码生成能力著称,被视为性价比基准之一。NaiveAI能在编码质量上与之对标,说明其并非单纯追求速度而牺牲输出质量。
这种“速度+质量”的组合如果成立,其意义在于改变了速度与质量之间的传统权衡。过去,超高速模型往往在复杂推理和代码正确性上打折扣;而高质量模型则难以做到极低延迟。NaiveAI的宣称指向一个不同的可能性:两者可以同时满足。
补充一点,实测的具体测试集、任务类型和评分方式在原始素材中并未详细披露,因此这一对比结论应理解为方向性判断,而非严格的基准评测结果。
DeepSeek 是中国 AI 公司深度求索推出的大模型系列,其 DeepSeek-Coder 和后续通用模型在代码生成、修复和补全任务上表现突出,且 API 定价较低,因此在开发者社区中被广泛用作编码能力的性价比基准。以 DeepSeek 作为对照,意味着比较的是「实用级」编码质量,而非与顶级闭源模型做绝对对标。
基准评测的严谨性依赖几个要素:固定测试集(如 HumanEval、MBPP 或更贴近真实工程的 SWE-bench)、可复现的提示词与采样参数、以及多人盲评或自动化单元测试通过率。缺少这些披露时,「可与 DeepSeek 比较」只能视为初步印象,尚不足以支撑严格的性能结论。
对开发者的实际意义
对于日常使用AI编码助手的开发者来说,速度提升的价值体现在几个具体环节。代码补全的等待时间从秒级压缩到近乎即时,会改变编写代码的节奏;多轮对话调试时,模型响应速度直接影响问题排查的效率;批量生成测试代码或重构建议时,吞吐量决定了工作流能否自动化。
如果NaiveAI真能兑现每秒2100 Token的承诺,并且编码质量稳定在DeepSeek水平附近,那么它在这些场景中会具备明显的吸引力。但开发者采用前仍需关注几个现实问题:API的稳定性与限流策略、长上下文下的速度衰减、以及代码许可证和输出合规性。
API 限流策略通常包括每分钟请求数(RPM)、每分钟 Token 数(TPM)和并发连接数上限。即使模型峰值速度很高,如果账户的 TPM 配额较低,实际吞吐仍会被平台侧限制,因此开发者在评估时需区分「模型能力」与「账户可用配额」。
长上下文速度衰减是推理服务的常见现象:随着上下文长度增加,注意力计算和 KV Cache 内存占用上升,输出速率往往下降。对于需要读取整个代码仓库或长文件的编码任务,短文本下的爆发速度参考价值有限,持续生成速率才是关键指标。
速度竞赛的下一步
Artificial Analysis的速度排行榜一直是模型能力比较的参考维度之一。NaiveAI若上榜并位居前列,会进一步推动行业对推理效率的关注。从趋势上看,模型厂商正在从单纯堆参数转向优化推理架构和部署效率,速度指标的重要性在上升。
但速度终究是手段而非目的。对编码场景而言,生成的代码能否一次通过编译、是否引入隐蔽bug、对复杂需求的理解是否准确,这些才是决定工具价值的核心。NaiveAI的宣称打开了一个值得关注的窗口,接下来需要看到更多独立、可复现的评测数据来验证其真实水平。
相关推荐

@ai-sdk/rsc 1.0.291 版本发布:修复补丁与依赖更新
@ai-sdk/rsc 发布 1.0.291 补丁版本,更新依赖至 ai@5.0.289。本文介绍该版本的变更内容、依赖关系与升级建议,帮助开发者了解 AI SDK 生态的版本维护节奏。

英伟达治理危机:公司治理专家为何集体围观
英伟达陷入令公司治理专家都感到罕见的危机,多位专家表示从未见过类似局面。本文分析这一治理危机为何引发专业围观,以及对AI芯片行业可能产生的影响。

Ollama保姆级教程:零基础本地部署AI大模型
零基础 Ollama 安装部署教程:讲解软件与模型分盘存放的三种安装方式、如何修改模型目录、装好后如何用命令运行模型,并按显存大小给出模型选择建议与思考模式关闭技巧。