NepKANUN:基于RAG的尼泊尔法律智能助手解析
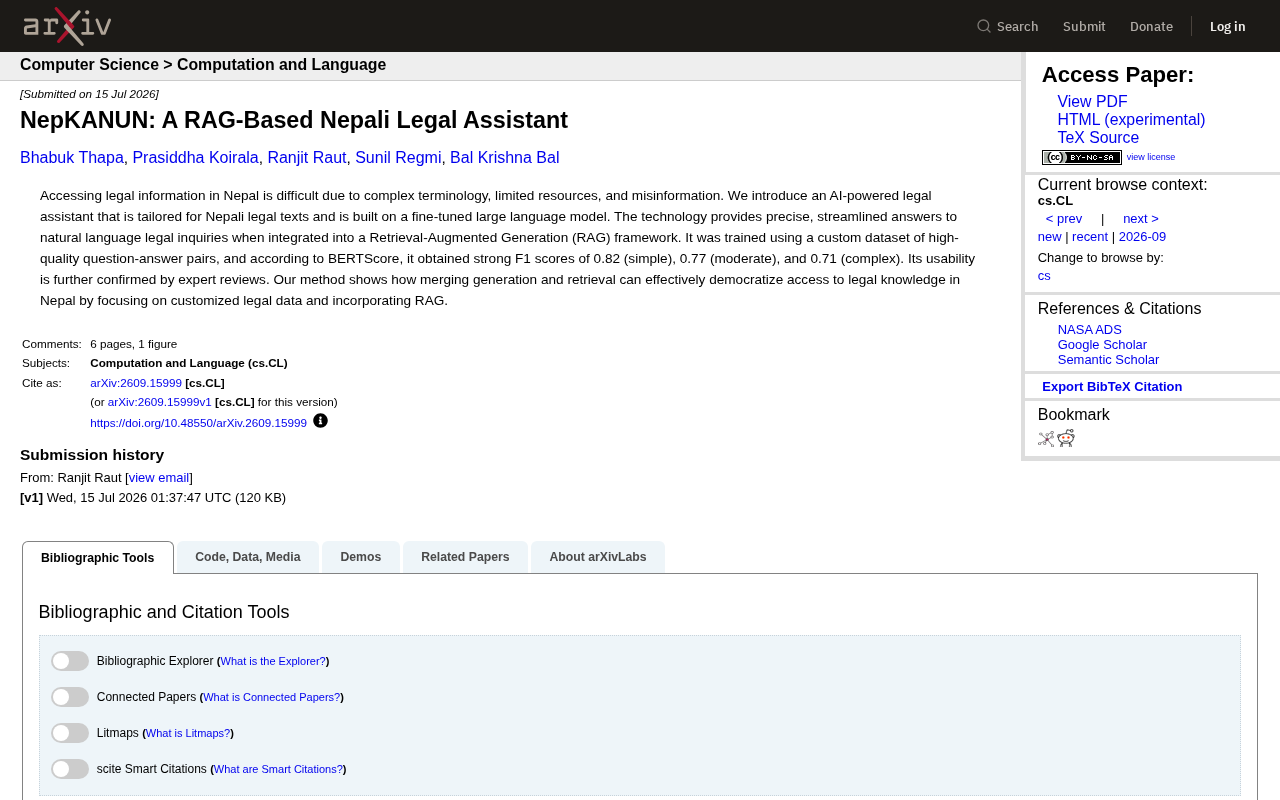
NepKANUN借助RAG框架与微调大模型,为资源匮乏的尼泊尔法律场景提供了平民化的AI法律问答方案。
NepKANUN是一款面向尼泊尔语法律文本的AI助手,通过将检索增强生成(RAG)框架与微调大语言模型结合,解决了小语种垂直领域法律问答的准确性难题。系统先从可靠法律语料库检索相关内容,再由模型生成易懂的回答,有效抑制了纯生成模型常见的"幻觉"问题。研究团队自建高质量尼泊尔法律问答数据集进行训练,BERTScore F1在简单、中等、复杂问题上分别达到0.82、0.77和0.71,并经专家评审验证实用性。NepKANUN的更大意义在于提供了一条可复制路径:通过定制数据集配合RAG架构,资源匮乏的小语种垂直领域同样能够构建出实用的专业AI助手。
一个针对小语种法律场景的AI实践
在法律信息获取这件事上,语言和地域的鸿沟往往被技术界忽略。大部分法律AI工具围绕英语等主流语言构建,而像尼泊尔这样法律术语复杂、资源有限、错误信息泛滥的地区,普通民众想要理解自己的合法权益,门槛相当高。
arXiv上一篇新论文提出的 NepKANUN 正是为解决这一痛点而生。它是一款专门面向尼泊尔法律文本的AI法律助手,底层建立在经过微调的大语言模型之上,并融合了检索增强生成(RAG)框架,目标是让法律知识的获取更加平民化。
RAG如何解决法律问答的准确性难题
法律问答对准确性的要求极高,稍有偏差就可能误导用户。纯粹依赖大模型生成答案容易出现「幻觉」——模型会编造看似合理实则错误的法律条文。NepKANUN 的思路是把生成能力与检索能力结合:当用户用自然语言提出法律咨询时,系统先从可靠的法律语料库中检索相关内容,再由微调后的语言模型生成精准、简洁的回答。
这种「检索+生成」的组合是当前专业领域AI应用的主流范式。检索环节保证了答案有据可依,减少凭空捏造;生成环节则负责把冗长晦涩的法律术语转化为普通人能听懂的表达。对于法律这种容错率极低的领域,RAG的价值尤为突出。
RAG(Retrieval-Augmented Generation,检索增强生成)的工作流程通常分为三个阶段:首先,将法律语料库(如法条、判例、法规全文)切分为文本块,并用向量嵌入模型将其编码为高维向量存入向量数据库;其次,当用户提问时,系统将问题同样编码为向量,通过相似度检索(如余弦相似度)快速找出最相关的若干文本片段;最后,将这些检索结果作为「上下文」拼入提示词,交给语言模型生成最终回答。这种架构的关键优势在于「知识外挂」——语言模型本身的参数权重无需存储所有专业知识,而是在推理时动态调用外部知识库,既减少了幻觉,也使知识更新变得容易(只需更新语料库而非重新训练模型)。对于法律这类知识高度时效性且错误代价极高的领域,RAG几乎已成为标配方案。
训练数据与性能表现
研究团队使用了一个自建的高质量问答对数据集来训练模型。数据质量对垂直领域AI的效果起决定性作用,尤其是在缺乏公开语料的小语种法律场景下,构建定制化数据集本身就是一项重要贡献。
在评估环节,团队采用 BERTScore 作为衡量指标,并按问题难度分级测试。结果显示:
- 简单问题:F1 得分 0.82
- 中等难度问题:F1 得分 0.77
- 复杂问题:F1 得分 0.71
可以看到,随着问题复杂度上升,模型表现逐步下降,这符合预期——越复杂的法律问题往往涉及多条款交叉、上下文推理,对检索和生成都是更大的考验。0.71的复杂问题得分表明系统在高难度场景仍有提升空间,但整体性能已属可用水平。
除了自动化指标,研究还通过专家评审进一步验证了系统的实用性,这为技术落地提供了额外的可信度背书。
BERTScore 是一种基于预训练语言模型(如BERT)的文本相似度评估指标,与传统的BLEU、ROUGE等基于词汇重叠的指标不同,它通过计算候选文本与参考文本在语义嵌入空间中的余弦相似度来衡量质量,因此对同义表达更具包容性。BERTScore 分别计算精确率(Precision)、召回率(Recall)和 F1 值,其中 F1 是综合性能的常用代表指标。在法律问答评估中使用 BERTScore 的好处是:法律回答往往存在多种合法的表述方式,语义层面的匹配比字面匹配更能反映答案的实际正确性。不过,BERTScore 也有局限——它衡量的是表述相似度而非事实准确性,这也是为何研究团队还额外引入了专家评审作为补充验证手段。
对小语种AI落地的启示
NepKANUN 的意义不仅在于一个尼泊尔法律工具本身,更在于它展示了一条可复制的路径:面对资源匮乏的小语种垂直领域,通过定制化数据集配合RAG框架,同样能够构建出实用的专业AI助手。
这对全球大量非主流语言地区都有借鉴价值。法律、医疗、政务等公共服务领域普遍存在信息不对称,而针对性的AI方案有望降低这种壁垒,让技术真正服务于普通人的日常需求。
当然,这类系统要真正投入实际使用,仍需在数据覆盖广度、复杂问题处理能力以及责任边界(AI建议不能替代专业律师意见)等方面持续打磨。但作为一次探索,NepKANUN 提供了一个值得关注的样本。
在自然语言处理领域,「低资源语言」(Low-resource Language)指缺乏大规模标注语料、预训练模型和基准数据集的语言,尼泊尔语即属此类。与英语等高资源语言相比,低资源语言面临的核心挑战包括:可用于预训练的文本数据量少、专业领域(如法律、医疗)的平行语料几乎空白、以及现有多语言模型(如mBERT、XLM-R)在这些语言上的表现远逊于英语。NepKANUN 的应对策略——自建垂直领域问答数据集结合针对性微调——代表了当前低资源场景下的一种务实路线:与其等待通用大模型覆盖所有语言,不如以较小的标注投入换取特定任务上的可用性能。这一思路对全球约7000种语言中绝大多数尚未被主流AI工具覆盖的语言社区,均具有参考意义。
相关推荐
Grist移除社区版SSO功能:开源软件的"SSO税"争议再起
Grist在v1.7.18版本更新中移除了社区版的SSO单点登录功能,将其锁定至付费层级,引发"SSO税"争议。本文分析该事件、开源软件商业化困境及对自托管用户的启示。
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。