你能分辨AI生成图像吗?辨识能力正在被算法超越
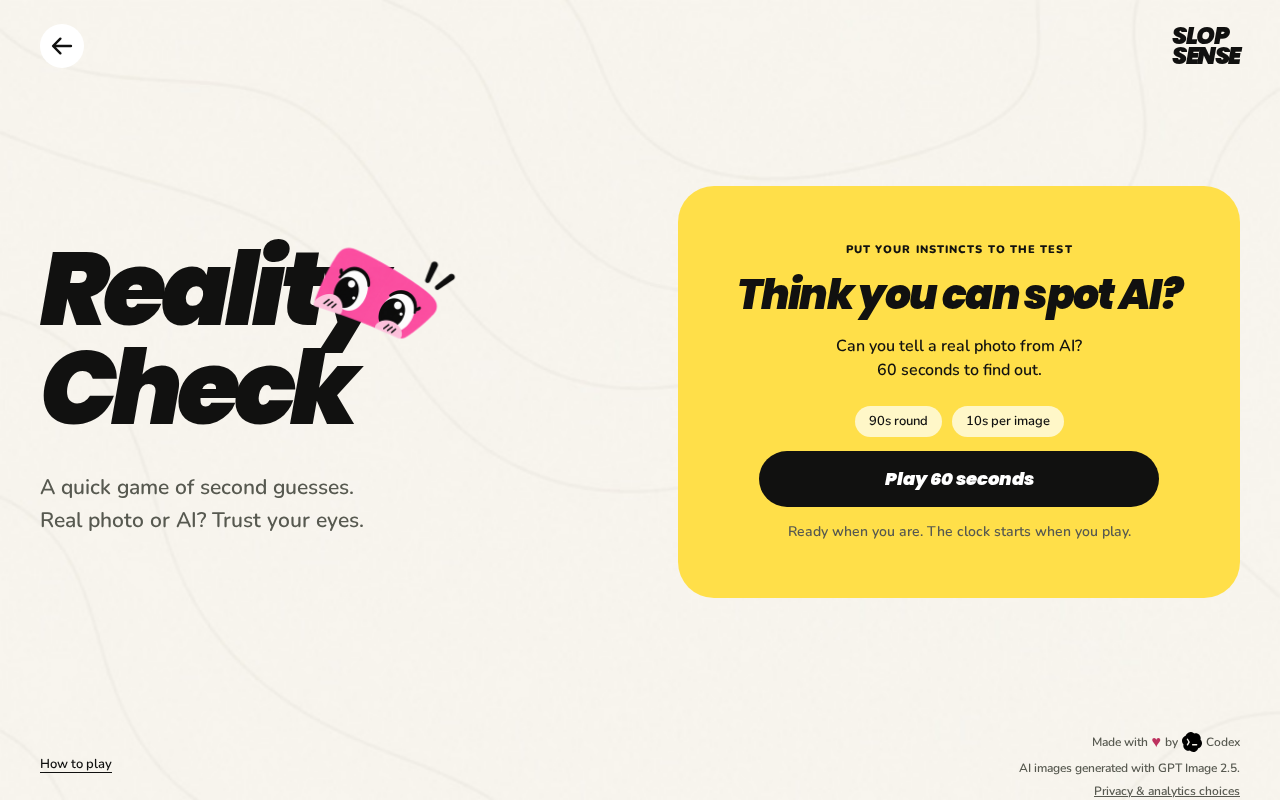
AI生成图像日益逼真,人眼辨识已近失效,重建视觉信任需转向来源验证而非感官判断。
随着扩散模型等生成技术快速迭代,AI合成图像的逼真程度已逼近人类辨识极限,普通人的判断准确率仅略高于随机猜测。传统辨识线索——扭曲的手指、异常的文字渲染、光影矛盾——正被新一代模型系统性修复。技术层面,C2PA内容溯源标准、隐形水印和AI检测器是主要应对方向,但各自存在局限:溯源元数据易在传播中丢失,检测器与生成模型处于持续的军备竞赛,难有一劳永逸的方案。文章认为,更可持续的出路是转变信任模型——不再依赖"能否看出",而是建立基于数字签名和可信发布渠道的来源验证体系,同时培养用户对视觉信息的健康怀疑态度。
一个越来越难回答的问题
"你能分辨哪些图像是AI生成的吗?"这个看似简单的问题,正在成为数字时代最棘手的挑战之一。随着生成式AI技术的快速迭代,机器合成图像的逼真程度已经逼近甚至在某些场景下超越了人类肉眼的辨识极限。
这个话题近期在Hacker News等技术社区引发讨论,反映出一个普遍的焦虑:当图像不再天然可信,我们该如何构建视觉信息的信任基础?
需要说明的是,本文基于的原始素材信息量有限(仅为一个社区讨论帖),以下内容更多是对这一话题背景与现状的延展分析,而非对具体测试结果的复述。
人类辨识能力的现实困境
多项公开研究已经表明,普通人在区分真实照片与AI生成图像时的准确率往往仅略高于随机猜测。早期的AI图像存在明显破绽——扭曲的手指、不合逻辑的文字、诡异的背景细节,这些都是常见的"露馅"信号。
但生成模型的进步速度惊人。当代的扩散模型(Diffusion Models)在处理光影一致性、纹理细节和面部特征方面已经相当成熟。曾经可靠的辨识线索正在快速失效,普通用户很难再凭借经验做出准确判断。
这种能力差距带来的直接后果是:视觉内容作为"证据"的传统地位正在动摇。一张照片不再能自动被当作事实的记录。
辨识线索为何逐渐失效
过去人们依赖的辨识技巧大致分为几类:解剖学错误(手指数量、牙齿形态)、物理规律违背(光源方向矛盾、倒影异常)、以及文字渲染缺陷。
随着训练数据规模扩大和模型架构优化,这些缺陷被系统性地修复。新一代模型在生成人脸、自然风景和日常物品时,几乎不再暴露这些初级破绽。
更深层的挑战在于,人类视觉系统本身容易被"看起来合理"的图像欺骗。我们的大脑倾向于接受符合预期的画面,而不会主动去审查每一个像素级的细节。这种认知特性让AI图像有了可乘之机。
扩散模型(Diffusion Models)是当前主流AI图像生成技术的核心架构。与早期的GAN(生成对抗网络)不同,扩散模型通过"逐步去噪"的方式生成图像:先向图像添加随机噪声直至完全随机,再训练神经网络学习逆过程——从噪声中一步步还原出清晰图像。这种机制使模型能够更精细地控制图像的局部细节,在光影、纹理和材质方面的表现远超前代技术。Stable Diffusion、Midjourney和DALL-E 3均基于类似原理。扩散模型的另一个特点是可以结合文本引导(通过CLIP等模型将文字与图像语义对齐),使得"按描述生成"成为可能,也使生成结果更符合人类对"合理画面"的预期,从而更难被直觉识破。
技术层面的应对方向
面对肉眼辨识的失效,行业正在探索几条技术路径。
内容溯源与水印
C2PA(内容来源与真实性联盟)等标准试图为图像添加不可篡改的元数据签名,记录其生成与编辑历史。部分AI生成工具也开始嵌入隐形水印,标记内容的机器来源。
C2PA(Coalition for Content Provenance and Authenticity,内容来源与真实性联盟)是由Adobe、微软、英特尔、BBC等机构于2021年联合发起的行业标准组织,旨在为数字内容建立可追溯的"出生证明"。其技术核心是在图像、视频等媒体文件中嵌入加密签名的元数据清单,记录内容的创建工具、创建时间、编辑历史及发布者身份。这些信息通过非对称加密技术绑定,理论上无法在不破坏签名的前提下被篡改。目前Leica、尼康等相机厂商已开始在硬件层面支持C2PA签名,部分手机厂商也跟进试点。然而C2PA面临的挑战在于:它只能证明"已签名的内容未被篡改",对于从未嵌入签名的图像(即绝大多数现存内容)无能为力,且元数据在图像被截图或重新上传后往往会丢失。
AI检测器
专门的检测模型试图通过分析图像的频域特征、噪声模式等机器指纹来识别AI生成内容。但这类检测器面临一个根本性矛盾:它们与生成模型处于持续的"军备竞赛"中,检测方法一旦公开,生成方就能针对性优化以规避检测。
AI图像检测器通常依赖两类特征:一是频域分析,AI生成图像在傅里叶变换后往往呈现出与相机拍摄照片不同的频率分布规律,因为传感器噪声、镜头畸变等物理过程会留下人工神经网络难以完全复现的统计指纹;二是语义一致性检测,模型学习识别画面中超出物理常识的细微矛盾,如背景焦外模糊方式异常、皮肤高光分布不自然等。然而这类检测器存在严重的泛化性问题:针对某一生成模型训练的检测器,在面对另一架构的生成图像时准确率会显著下降。更棘手的是,"对抗性微调"技术可以在肉眼不可见的前提下扰动图像像素,使检测器失效。这正是所谓军备竞赛的核心困境——检测方法的公开本身就成为生成方优化的靶标。
平台责任
社交媒体和内容平台开始要求对AI生成内容进行标注,但执行力度和覆盖范围仍参差不齐。
这场博弈没有终局
值得思考的是,辨识AI图像的难度只会越来越高,而非降低。指望通过训练"火眼金睛"来长期对抗生成技术并不现实——这是一场人类感官注定会落后的赛跑。
更可持续的思路或许是转变信任模型:不再默认视觉内容真实,而是建立基于来源验证、数字签名和可信发布渠道的信任体系。换句话说,问题的答案不应该依赖"你能不能看出来",而应该依赖"这张图能不能被验证"。
对普通用户而言,保持对视觉信息的健康怀疑、关注内容来源、避免轻信孤立的"眼见为实",可能是当下最实用的自我保护策略。
结语
"你能分辨AI生成图像吗?"这个问题的价值,或许不在于测试个人的辨识水平,而在于提醒我们:视觉真实性正在经历一场深刻的重构。在这个转折点上,技术手段、平台规则与用户素养需要共同进化,才能重新建立起数字视觉世界的信任基础。
相关推荐
厌倦手动调优RAG?开源工具Muffakir自动跑实验
开发者厌倦手动调优RAG流水线,打造开源实验运行器Muffakir。支持分块、嵌入、检索、重排序、top-k等组件的自动化组合实验,并用检索/生成指标、延迟和成本量化对比,可导出配置到Python。
ROCmFix与InferBench:AMD显卡本地大模型部署实测
ROCmFix 与 InferBench 项目聚焦 AMD 显卡本地大模型部署,简化 ROCm 环境配置并对比 Vulkan 与 HIP 两种推理后端的性能差异,为本地 LLM 用户提供实用参考。
AI落地评估难题:Accenture与嵌入式评估合作解析
解析AI技术团队与埃森哲合作开展嵌入式评估(Embedded Evaluation)的背景与意义,探讨企业级AI落地中的持续评估机制、技术要点及行业启示。