厌倦手动调优RAG?开源工具Muffakir自动跑实验
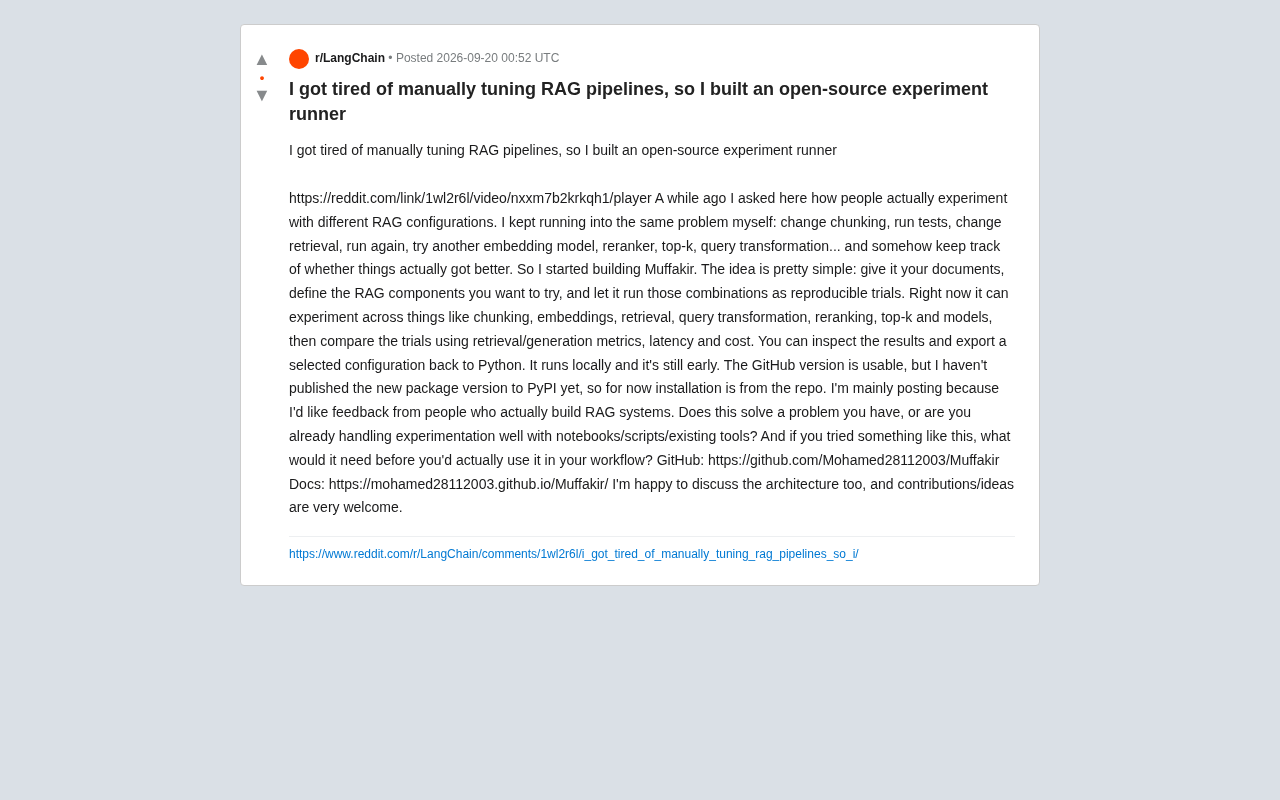
Muffakir是开源RAG实验运行器,自动跑分块/检索/重排等组合并多维度量化对比,帮助开发者摆脱手动调优困境。
Muffakir 是一位开发者因厌倦手动调优RAG流水线而构建的开源实验运行器。它将分块策略、嵌入模型、检索方式、查询变换、重排序、top-k参数和生成模型这七个关键维度纳入统一实验框架,自动执行各种组合并生成可复现的试验结果。评估维度涵盖检索指标、生成指标、延迟与成本,帮助开发者在效果与工程约束之间做出权衡。选定的最优配置可直接导出为Python代码用于生产。项目目前处于早期阶段,仅支持从GitHub仓库本地安装,作者主动征集真实RAG开发者反馈,以明确工具的演进方向。
手动调优RAG的痛点
构建检索增强生成(RAG)系统的开发者大概都经历过这样的循环:调整分块策略、跑一遍测试,再换检索方式、又跑一遍,接着尝试另一个嵌入模型、重排序器、top-k参数、查询变换……然后还要费力记录到底哪一次改动真的带来了效果提升。
一位开发者在 Reddit 上分享了他的解决方案。他坦言自己"厌倦了手动调优RAG流水线",此前曾在社区询问大家是如何实验不同 RAG 配置的,结果发现自己反复陷入同一个困境——组合太多、迭代太快,难以系统化地判断优劣。于是他动手做了一个开源的实验运行器,取名 Muffakir。
检索增强生成(RAG)是一种将外部知识库与大语言模型结合的架构模式:系统先从文档库中检索与用户查询最相关的片段,再将这些片段作为上下文连同问题一起输入生成模型,从而让模型能回答训练数据之外的特定领域问题。RAG 的效果高度依赖流水线中多个组件的协同表现——文档如何切分(分块策略)决定了信息粒度,嵌入模型决定了语义相似度的计算质量,检索方式(稠密、稀疏或混合)影响召回率,重排序器则在初步召回后进一步筛选最相关结果。这些组件之间存在复杂的交互效应,单独调好某一环节并不能保证整体效果提升,这也是为什么系统化实验对 RAG 开发至关重要。
Muffakir 是什么
这个工具的思路并不复杂:把你的文档交给它,定义好想要尝试的 RAG 组件,然后让它把各种组合作为**可复现的试验(trials)**自动跑起来。
从作者的介绍看,目前 Muffakir 支持在以下维度上进行实验对比:
- 分块(chunking):不同的切分策略
- 嵌入模型(embeddings):不同的向量化方案
- 检索(retrieval):不同的召回方式
- 查询变换(query transformation):对用户查询的改写与扩展
- 重排序(reranking):召回结果的二次排序
- top-k:召回数量参数
- 模型(models):不同的生成模型
换句话说,它把 RAG 流水线中最常见、也最影响效果的几个可调节点都纳入了实验框架,让开发者从"手动排列组合"中解放出来。
用指标说话的对比
Muffakir 不只是跑组合,更重要的是提供了量化的评估维度。它会用检索指标、生成指标、延迟(latency)和成本(cost) 来对比各个试验的结果。
这一点对实际落地很关键。RAG 优化从来不是单一维度的问题——一个配置可能召回效果更好,但延迟和 token 成本大幅上升。把效果、速度、花费放在同一张表里对比,才能帮助开发者根据自己的场景做出权衡。
跑完实验后,用户可以检视结果,并把选定的配置导出回 Python 代码,直接用于生产环境。这条从"实验"到"落地"的路径设计得比较务实。
RAG 评估中常用的检索指标包括命中率(Hit Rate)、平均倒数排名(MRR)和归一化折损累积增益(NDCG),用于衡量正确答案是否被召回以及排名是否靠前;生成指标则涵盖忠实度(Faithfulness,答案是否与检索到的上下文一致)、答案相关性(Answer Relevancy)等,常借助 RAGAS 等框架自动化计算。延迟和成本是工程落地时同等重要的约束——更强的重排序模型或更大的 top-k 值往往能提升召回质量,但会显著增加 API 调用费用和端到端响应时间。将这四个维度放在同一实验结果中对比,正是 Muffakir 区别于单纯效果评估脚本的关键设计意图。
本地运行,处于早期阶段
作者对项目的成熟度保持了诚实的态度。Muffakir 目前在本地运行,仍处于早期开发阶段。GitHub 上的版本已经可用,但新的包版本尚未发布到 PyPI,所以现阶段只能从仓库源码安装。
- GitHub 仓库:github.com/Mohamed28112003/Muffakir
- 文档:mohamed28112003.github.io/Muffakir
对于愿意尝鲜的开发者来说,这意味着安装门槛略高,但也意味着可以更早地参与到项目的塑造中——作者明确表示欢迎讨论架构、提交贡献和想法。
它解决的是真问题吗
作者发帖的主要目的其实是征集反馈。他直言想听听真正在构建 RAG 系统的人的意见:这是否解决了你遇到的问题?还是说你已经用 notebook、脚本或现有工具把实验管理得很好了?
这个问题值得展开。当前 RAG 实验管理确实存在两种典型做法:一种是靠 Jupyter notebook 和自写脚本手动记录,灵活但难以复现、容易失控;另一种是借助更通用的 ML 实验追踪工具,但它们大多并非为 RAG 的组件化实验专门设计。
Muffakir 的定位介于两者之间——它把 RAG 特有的调优维度(分块、检索、重排等)做成了一等公民,同时保留了可复现性和多维度对比。如果这套抽象足够贴合真实工作流,它确实有机会填补一块空白。
距离真正可用还差什么
作者也主动抛出了另一个关键问题:如果你尝试过类似工具,它还需要具备什么,你才会真正把它用进工作流?
这恰恰是许多开源开发者工具的共同挑战。一个实验运行器要被采纳,往往不仅取决于功能覆盖,还取决于安装便捷度(PyPI 发布)、与现有向量数据库/框架的集成、结果可视化的质量,以及文档的完善程度。作者目前的坦诚——承认工具尚早、征求真实需求——反而是这类项目健康发展的良好起点。
对于正被 RAG 调优折磨的团队,Muffakir 至少提供了一个值得关注的开源选项。它是否会成为你工具箱的一部分,可能取决于它能否在接下来的迭代中补齐这些落地细节。
相关推荐
《美丽心灵》背后:胰岛素休克疗法与精神病治疗的黑暗史
医学史学者Andrew Scull回顾20世纪精神病治疗黑暗史:胰岛素休克疗法如何以"奇迹疗法"之名施加伤害,《美丽心灵》原型约翰·纳什也曾是受害者。解析这些危险疗法的兴衰与科学验证的教训。
电击疗法的血腥起源:从屠宰场到精神科的百年争议
医学史学家Andrew Scull在与Lex Fridman的对谈中揭示电击疗法(ECT)从罗马屠宰场获得灵感的血腥起源,剖析其从惩罚工具到循证疗法的演变、脑损伤与记忆丧失争议,以及背后更深层的科学公信力危机。
弗洛伊德与荣格决裂内幕:精神分析之父的爱恨情仇
历史学家 Andrew Scull 在 Lex Fridman 播客中解析弗洛伊德与荣格从师徒盟友到彻底决裂的内幕,回顾精神分析起源、安娜·O 案例及弗洛伊德「伟大仇恨者」的性格。