Noam Brown:AI数学能力每年10倍跃升,超出预期

OpenAI研究员Brown发现AI数学推理能力每年提升约10倍,进展速度连一线研究者本人都感到意外。
OpenAI研究科学家Noam Brown提出了一种衡量AI推理能力进步的新视角:用「人类数学家完成同等任务所需时长」作为难度标尺。沿着这把尺子,AI攻克的数学题难度呈现出惊人的规律性——每年约提升10倍,从GSM8K小学题的5秒量级,到MATH基准的1分钟,再到数学奥林匹克资格赛的10分钟,直至2025年达到IMO金牌所需的约100分钟。按此趋势外推,千禧年大奖难题的攻克或需数年,但Brown坦承实际进展「比预期快得多」,原本认为2026-2028年才可能出现的能力,已提前兑现。这一框架的价值在于将模糊的「AI变强」具象化为可量化的趋势,但也需保持清醒:数学基准的进展未必能线性映射至所有领域,尤其是千禧年难题所要求的创造性洞察,与竞赛数学的快速求解在性质上存在本质差异。
OpenAI研究科学家Noam Brown在一次访谈中抛出了一个令人警醒的观察:AI模型的推理能力正以远超预期的速度进化。他用数学基准测试的进展作为标尺,勾勒出一条清晰的指数级增长曲线——而这条曲线的斜率,连身处一线的研究者本人都感到意外。
用「人类耗时」丈量AI的进步
Brown提出了一个巧妙的度量方式:不看AI能答对多少题,而是看它攻克的问题,需要一位人类数学家花多长时间才能解决。这个视角把抽象的能力提升转化为直观的时间尺度。
他梳理的时间线是这样的:最初模型攻克GSM8K(小学数学题),这类题目对人类数学家而言大约只需5秒;一年后,模型能解决MATH基准测试的题目,专家大约需要1分钟;再往后,是美国数学奥林匹克队资格赛级别的题目,优秀数学家大约需要10分钟。
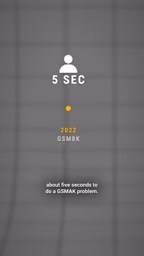
每跨越一个台阶,AI所能处理任务的「人类耗时」就放大约10倍。从5秒到1分钟,再到10分钟,这条趋势线异常规整。

GSM8K(Grade School Math)是由OpenAI于2021年发布的小学数学文字题基准,包含约8500道需要多步推理的算术应用题,曾长期被视为检验语言模型基础数学推理能力的标准测试。MATH基准则由Hendrycks等人发布,涵盖代数、几何、概率、数论等七个难度分级领域的12500道竞赛数学题,其中最难级别的题目已触及高中数学竞赛的边界。两个基准的核心区别不在于知识量,而在于推理链的长度与复杂度——MATH中的顶级题目往往需要多层嵌套的推理步骤,这正是Brown所说的「推理深度」的体现。值得注意的是,模型在GSM8K上接近满分之后,研究者几乎立刻需要引入更难的基准,这种「基准饱和」现象本身也印证了能力提升的速度超出了测试体系的设计预期。
从IMO金牌到千禧年难题的推演
沿着这条10倍/年的曲线,下一站顺理成章地指向国际数学奥林匹克(IMO)金牌水平。一道IMO题目,人类数学家大约需要100分钟——也就是一个半小时左右。Brown表示,模型在2025年拿下IMO Gold,「非常合理」,完全落在趋势线的预测之内。

真正引发思考的是他随后的外推:如果按每年10到15倍的速度继续,从IMO金牌(1.5小时量级)出发,一年后能处理约15小时量级的任务。但要攻克千禧年大奖难题(Millennium Prize Problem)这类顶尖数学猜想,15小时的量级显然远远不够。

千禧年大奖难题(Millennium Prize Problems)由克雷数学研究所于2000年设立,共七道题,每题悬赏100万美元,包括黎曼猜想、P vs NP问题、纳维-斯托克斯方程存在性与光滑性等。迄今为止,七题中仅有庞加莱猜想于2003年被格里戈里·佩雷尔曼解决。这些问题之所以被用作AI能力外推的终点坐标,在于它们代表了人类数学智识的当前边界——不仅需要极长时间的持续推理,更依赖对数学结构的创造性重构,通常需要数学家数年乃至数十年的专注研究。将其与IMO题目并置,揭示出一个关键张力:竞赛数学考验的是在已知框架内快速求解的能力,而千禧年难题要求的是开拓全新的概念框架,二者在难度性质上存在质的差异,而非仅仅是量的延伸。
「比我预期的快得多」
基于这套推演,Brown原本给出的时间判断相当保守:2026年不太可能出现能解千禧年难题级别的模型,2027年大概也不行,或许要到2028年。
但他坦承,实际进展「比我预期的快得多」(happened a lot faster than I expected)。IMO Gold的到来时间点,验证了指数曲线的存在,也让他对后续节奏的预判不得不重新校准。这种「一线研究者都被自家技术进度超越」的表态,本身就是当前AI发展态势的一个注脚。
这条曲线意味着什么
Brown的框架有几个值得咀嚼的地方。
其一,它把「AI变强」从模糊的感受变成了可量化的趋势。用人类完成任务所需时长作为难度标尺,比单纯的准确率更能捕捉推理深度的跃迁。
其二,指数曲线的可怕之处在于早期看起来平缓、后期陡然拉升。从5秒到10分钟或许还在直觉可接受的范围内,但一旦进入「小时」乃至「十小时」量级,每一步跨越所对应的绝对能力增量都极为惊人。
其三,也是需要冷静看待的一点:数学基准的进展未必能线性映射到所有领域。千禧年难题这类问题不仅需要长时间推理,更需要创造性的洞察,而「人类耗时」这个单一维度未必能完整刻画这种质变。Brown本人也承认对这类问题的耗时「没有很好的把握」,这条外推更多是一种趋势警示,而非精确预言。
无论如何,当一位OpenAI的核心研究者都对进度感到意外时,外界对AI能力上限的既有想象,恐怕都需要向上修正。
「指数增长早期平缓、后期陡升」这一特性在技术史上有充分记录,常被称为「直觉欺骗区」——因为人类直觉天然倾向于线性外推,导致系统性低估指数趋势的后段。具体到AI推理能力,从「5秒任务」到「10分钟任务」的跨越,绝对时间差仅约9分55秒,感知上仍属渐进;但从「10分钟」到「100分钟」乃至「15小时」,每一步跨越所对应的任务复杂度增量已远超日常经验的参照系。Brown的框架提供了一个将这种加速度可视化的锚点,但也内含一个方法论局限:它假设「人类完成任务所需时长」与「任务的认知复杂度」之间存在单调映射,而现实中,某些数学突破的关键往往不在于耗时,而在于某个无法用时间衡量的灵感时刻。这使得该框架在解释竞赛数学进展时颇具说服力,在推演至开放式研究问题时则需要额外谨慎。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。