NodeWright:破解 Kubernetes 节点集群运维难题

NVIDIA推出NodeWright,将Kubernetes集群的节点底层配置管理纳入声明式框架,自动纠正配置漂移。
Kubernetes 擅长管理工作负载,但节点本身的内核参数、软件包、存储布局与安全代理等底层配置长期游离于其原生能力之外,传统上依赖 Ansible、Puppet 等外部工具,与声明式管理哲学存在割裂。NVIDIA 推出的 NodeWright 旨在弥补这一空白,将节点级配置管理纳入 Kubernetes 的声明式框架,使系统能持续将实际状态收敛至期望状态,并自动纠正配置漂移。这对 GPU 密集型 AI 集群尤为关键——驱动版本、CUDA 组件与内核配置的细微不一致,都可能导致分布式训练任务性能波动甚至失败。NodeWright 代表了节点管理从「集群之外的附加工作」向「Kubernetes 原生体系一部分」演进的明确趋势。
Kubernetes 擅长管理运行在节点上的工作负载,但节点本身的管理却始终是一块硬骨头。内核参数、系统软件包、存储布局、安全代理——这些底层配置一旦规模化,就会成为运维团队的沉重负担。NVIDIA 推出的 NodeWright 正是为了应对这一挑战而生。
节点管理为何如此棘手
在典型的 Kubernetes 集群里,控制面负责调度 Pod、管理副本、维持期望状态。但这一切的前提,是底层节点已经处于正确、一致且安全的配置状态。而节点本身的配置管理往往游离在 Kubernetes 的原生能力之外。
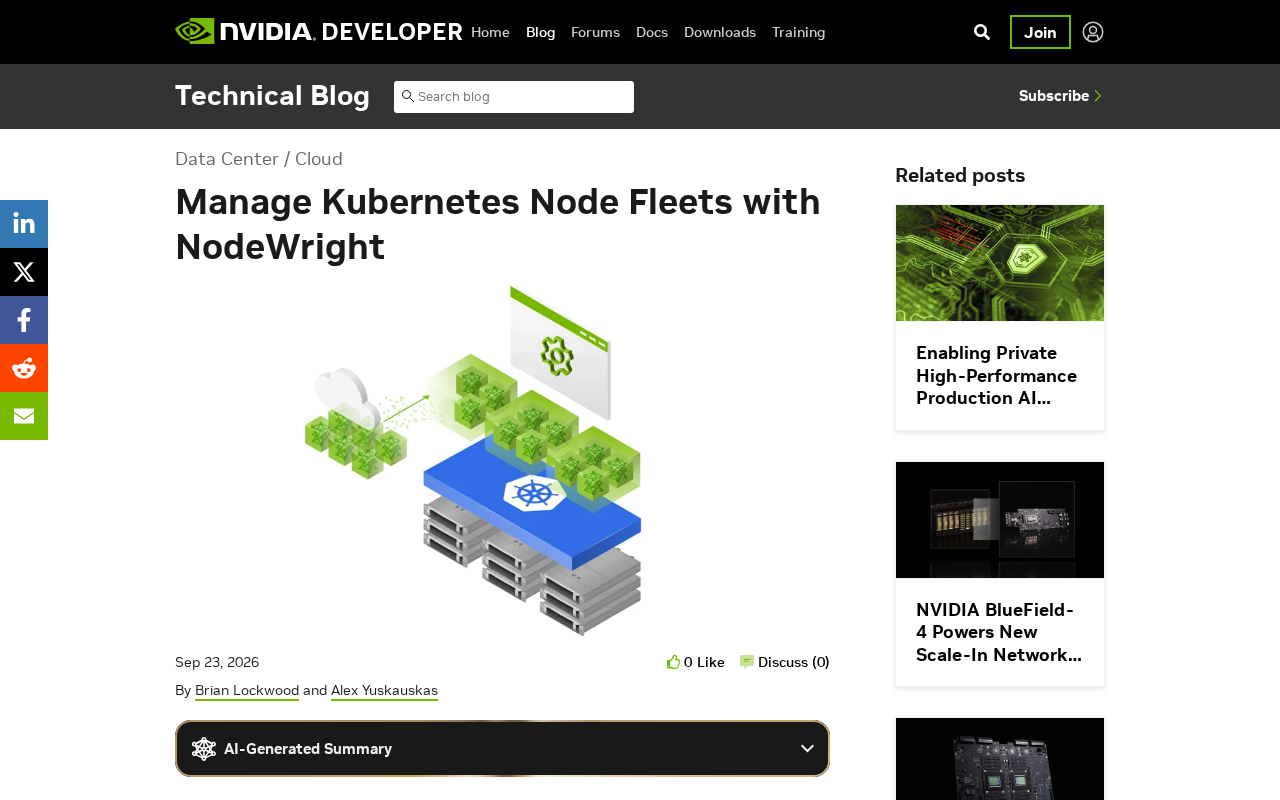
具体来说,运维团队需要处理内核参数调优(例如网络与内存相关的 sysctl 设置)、系统软件包的安装与升级、存储卷的布局规划,以及安全代理的部署。当集群规模从几个节点扩展到成百上千个节点时,任何配置漂移(configuration drift)都可能引发难以排查的故障。这类工作传统上依赖 Ansible、Puppet 等外部配置管理工具,或是手工维护的启动脚本,与 Kubernetes 声明式的管理哲学存在明显割裂。
NodeWright 的设计思路
NodeWright 的核心目标,是把节点级别的配置管理纳入到 Kubernetes 的声明式框架之中。与其在集群之外维护一套独立的配置流水线,不如让节点配置像其他 Kubernetes 资源一样,通过声明式的方式被定义、下发和持续校准。
这种思路带来的最大好处是一致性。运维人员只需声明节点应有的目标状态——需要哪些内核参数、装哪些软件包、如何布局存储——系统便会负责将实际状态收敛到期望状态,并在发生漂移时自动纠正。对于 GPU 密集型的 AI 工作负载而言,这一点尤为关键:驱动版本、CUDA 相关组件、以及硬件相关的内核配置都必须在整个节点集群中保持严格统一,否则训练与推理任务可能出现难以预测的性能波动甚至失败。
对 AI 基础设施的意义
NVIDIA 推出 NodeWright 的背景,与其在 AI 计算基础设施领域的布局密不可分。运行大规模 AI 训练和推理任务的集群,往往由大量配备高端 GPU 的节点组成,这些节点对底层系统配置的要求远高于普通 Web 服务集群。
节点集群的规模化管理直接影响到集群的可靠性与资源利用率。一个配置错误的节点可能拖慢整个分布式训练任务,或是在关键时刻因安全代理缺失而暴露风险。通过将节点管理声明化、自动化,NodeWright 有望降低大规模 AI 集群的运维复杂度,让基础设施团队把精力集中在更高价值的工作上,而不是反复处理配置漂移和手工修复。
在分布式 AI 训练场景中,节点配置的一致性对任务稳定性有直接影响。以 NCCL(NVIDIA Collective Communications Library)为例,其通信性能高度依赖节点间网络栈的内核参数设置(如 socket 缓冲区大小、RDMA 相关配置)。若集群中存在少量节点的这些参数与其他节点不一致,整个训练作业的吞吐量可能被这些「短板节点」拉低,表现为训练速度莫名下降或梯度同步超时。同样,CUDA 驱动版本若在节点间存在细微差异,可能在某些算子的数值精度上产生不可预期的偏差,给模型收敛带来隐患。这也解释了为何 NVIDIA 会将节点配置一致性作为 AI 基础设施管理的优先课题。
值得关注的方向
从公开信息来看,NodeWright 属于填补 Kubernetes 生态在节点层管理能力空白的一类工具。对于正在构建或运维 GPU 集群的团队,它提供了一条更贴合 Kubernetes 原生范式的路径。不过,实际落地效果仍取决于它与现有工具链的兼容性、社区生态的成熟度,以及在超大规模集群下的表现——这些都需要在真实环境中进一步验证。
对于关注云原生与 AI 基础设施的技术团队而言,NodeWright 代表了一个明确的趋势:节点管理正逐步从「集群之外的附加工作」演变为「Kubernetes 声明式体系的一部分」。
背景补充
配置漂移(configuration drift)是指系统的实际运行状态随时间推移逐渐偏离预期基线的现象。在节点规模较小时,漂移问题尚可通过人工巡检发现;但当集群扩展到数百乃至数千节点时,不同批次上线的节点可能安装了不同版本的内核模块,或因自动更新、手工介入而产生细微差异。这些差异单独来看不足为患,叠加在一起却可能导致同一个工作负载在不同节点上表现迥异,形成极难复现的「幽灵故障」。Ansible、Puppet 等工具虽然能在初始化阶段统一配置,但它们本质上是命令式的执行框架,难以持续监控并自动纠正运行时漂移,这正是与 Kubernetes 声明式哲学的根本性矛盾所在。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。