Nous Research 推出 Arete-27B: propaganda 率从22%降至0.9%
Nous Research 发布 Arete-27B,以“减法式”微调将 propaganda 输出率从 22% 降至 0.9%。
Nous Research 发布基于 Qwen3.8-27B 的 Apache 2.0 微调模型 Arete-27B,主打定向削弱 propaganda 类输出。在其自建的 803 条提示词评测中,该类回答占比从基座的 22% 降至 0.9%,而 Hermes Bench 得分保持 65.60% 不变,说明通用指令遵循能力未被牺牲。文章认为这种“只减不加”的微调思路在开源社区少见,其价值在于降低下游后处理成本、提升输出中立性。但评测集构成、propaganda 判定标准、训练数据与方法均未公开,可复现性与泛化能力有待第三方验证。
Nous Research 推出 Arete-27B: propaganda 率从22%降至0.9%
开源模型微调领域又出现一个值得关注的案例。Nous Research 近日发布了 Arete-27B,这是一个基于 Qwen3.8-27B 的 Apache 2.0 许可微调模型。其最引人注目的数据来自 Nous 自建的 803 条提示词评测: propaganda 类回答的占比从基座模型的 22% 降至 0.9%,而 Hermes Bench 得分则稳定在 65.60%,几乎未受影响。
一次“减法”式微调:砍掉 propaganda,保住通用能力
大模型微调通常追求能力增强——更强的推理、更长的上下文、更准的指令遵循。Arete-27B 走的却是另一条路:定向削弱某一类特定输出。
根据 Nous Research 公布的信息,在 803 条提示词的评测集上,基座模型 Qwen3.8-27B 有 22% 的回答被判定为 propaganda 性质;经过 Arete-27B 微调后,这一比例下降到 0.9%。话说回来,Hermes Bench 的得分从基座的 65.60% 保持不变,说明这次微调并没有以牺牲通用对话与指令遵循能力为代价。
这种“只减不加”的微调思路在开源社区并不多见。多数公开微调模型会同时报告多项 benchmark 提升,而 Arete-27B 的核心卖点是一个下降的指标。这恰恰说明 Nous Research 对“对齐”的理解:不是让模型更会说,而是让模型在该收敛的地方收敛。
参数高效微调(PEFT)是当前开源模型二次训练的主流手段,其中 LoRA(Low-Rank Adaptation)最具代表性。它的做法是冻结基座模型的全部原始权重,只在部分线性层旁并联一对低秩矩阵,训练时仅更新这对小矩阵。由于可训练参数量通常只占全模型的千分之一到百分之一,LoRA 对显存和算力的要求远低于全参数微调,产物也只是一个几十到几百 MB 的适配器权重,便于分发与叠加。代价是容量受限,对需要大幅改变模型行为的任务可能力不从心。与 LoRA 相对的是全参数微调(FFT),它更新所有权重,表达能力强但成本高、易遗忘基座能力。Arete-27B 未披露采用哪种路线,这正是其方法难以复现的关键缺口之一。
为什么 propaganda 指标值得单独关注
“ propaganda ”在模型评测中通常指带有强烈倾向性、煽动性、或为特定立场服务的输出。这类输出不一定违反安全政策,却可能影响模型作为信息工具的中立性。
对于需要模型做客观分析、事实梳理、或中立摘要的场景,22% 的 propaganda 回答率意味着接近四分之一的回答可能带有隐性立场偏移。将其压到 0.9%,对下游应用的价值很直接:减少后处理过滤成本,提升输出可信度。
需要注意的是,这个 22% 与 0.9% 均来自 Nous 自建的 803 条提示词评测,并非第三方独立基准。评测集的具体构成、判定 propaganda 的标准、以及标注者间一致性,原文均未展开。这意味着该数据更适合作为方向性参考,而非绝对性能承诺。
标注者间一致性(inter-annotator agreement)是衡量主观类评测可靠性的核心指标,常用 Cohen's kappa 或 Krippendorff's alpha 量化。当判定标准涉及“是否带有倾向性”这类主观判断时,不同标注者对同一回答的归类可能差异明显。若一致性偏低,22% 与 0.9% 之间的差距就可能部分来自标注噪声而非模型行为的真实变化。通常 kappa 高于 0.6 才算substantial agreement,高于 0.8 才算几乎一致。原文未披露该评测的标注人数、一致性系数与判定细则,因此读者在引用这组数字时应保留相应折扣。
Apache 2.0 许可与 Qwen 基座的选择
Arete-27B 采用 Apache 2.0 许可证,基座为 Qwen3.8-27B。这两个选择都值得留意。
Apache 2.0 允许商业使用、修改与再分发,对希望将模型集成进产品管线的团队较为友好。选择 Qwen3.8-27B 作为基座,则延续了开源社区用中等规模模型做定向微调的趋势——27B 参数量在推理成本与能力之间提供了折中,适合单机多卡或中等规模部署。
Nous Research 在开源模型社区以 Hermes 系列微调为人熟知,Hermes Bench 也是其自建评测体系。Arete-27B 的 Hermes Bench 得分与基座持平,说明微调数据与训练策略没有破坏基座原有的指令遵循分布。
Apache 2.0 与 GPL 类 copyleft 许可的关键区别在于,它不要求衍生作品以相同许可开源。使用者可以修改模型、闭源集成进商业产品,只需保留版权与许可声明、标明修改。但它不提供商标授权,也不含专利报复条款之外的额外保证。相比之下,Llama 系列采用的社区许可带有月活用户门槛等附加限制,而部分模型则限制商业用途。对希望把模型嵌入产品管线又不想受开源义务约束的团队,Apache 2.0 是限制最少的选项之一,这也是 Arete-27B 在许可层面较有吸引力的原因。
微调方法未公开:可复现性存疑
目前公开的信息止步于结果层面。Nous Research 没有披露 Arete-27B 的训练数据构成、微调方法(是全参数微调还是 LoRA 等参数高效方法)、训练步数、以及 propaganda 评测的具体判定流程。
对于想复现或在此基础上继续微调的开发者,这些信息的缺失会带来不确定性。Apache 2.0 许可赋予了使用自由,但“怎么做到的”仍然是一个黑盒。社区接下来的关注点,很可能集中在是否有第三方对 803 条评测集进行独立验证,以及 propaganda 率下降是否会在其他提示词分布上保持一致。
定向对齐或成开源微调新方向
Arete-27B 的案例提示了一种可能:开源微调不必总是追求 benchmark 全面上涨,针对单一行为维度做精准削减同样可以构成有价值的产品。
从 22% 到 0.9% 的降幅在数字上足够醒目,但真正的考验在于泛化——在 Nous 自建评测集之外,模型是否同样减少了倾向性输出,同时没有变得过度保守或拒答。Hermes Bench 持平是一个积极信号,但单一 benchmark 无法覆盖全部行为空间。
对开发者而言,Arete-27B 提供了一个可商用的、 propaganda 倾向显著更低的 27B 选项;对研究者而言,它提出了一个值得跟踪的问题:定向行为微调的边界在哪里,以及如何建立更透明的评测标准来验证这类“减法”效果。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
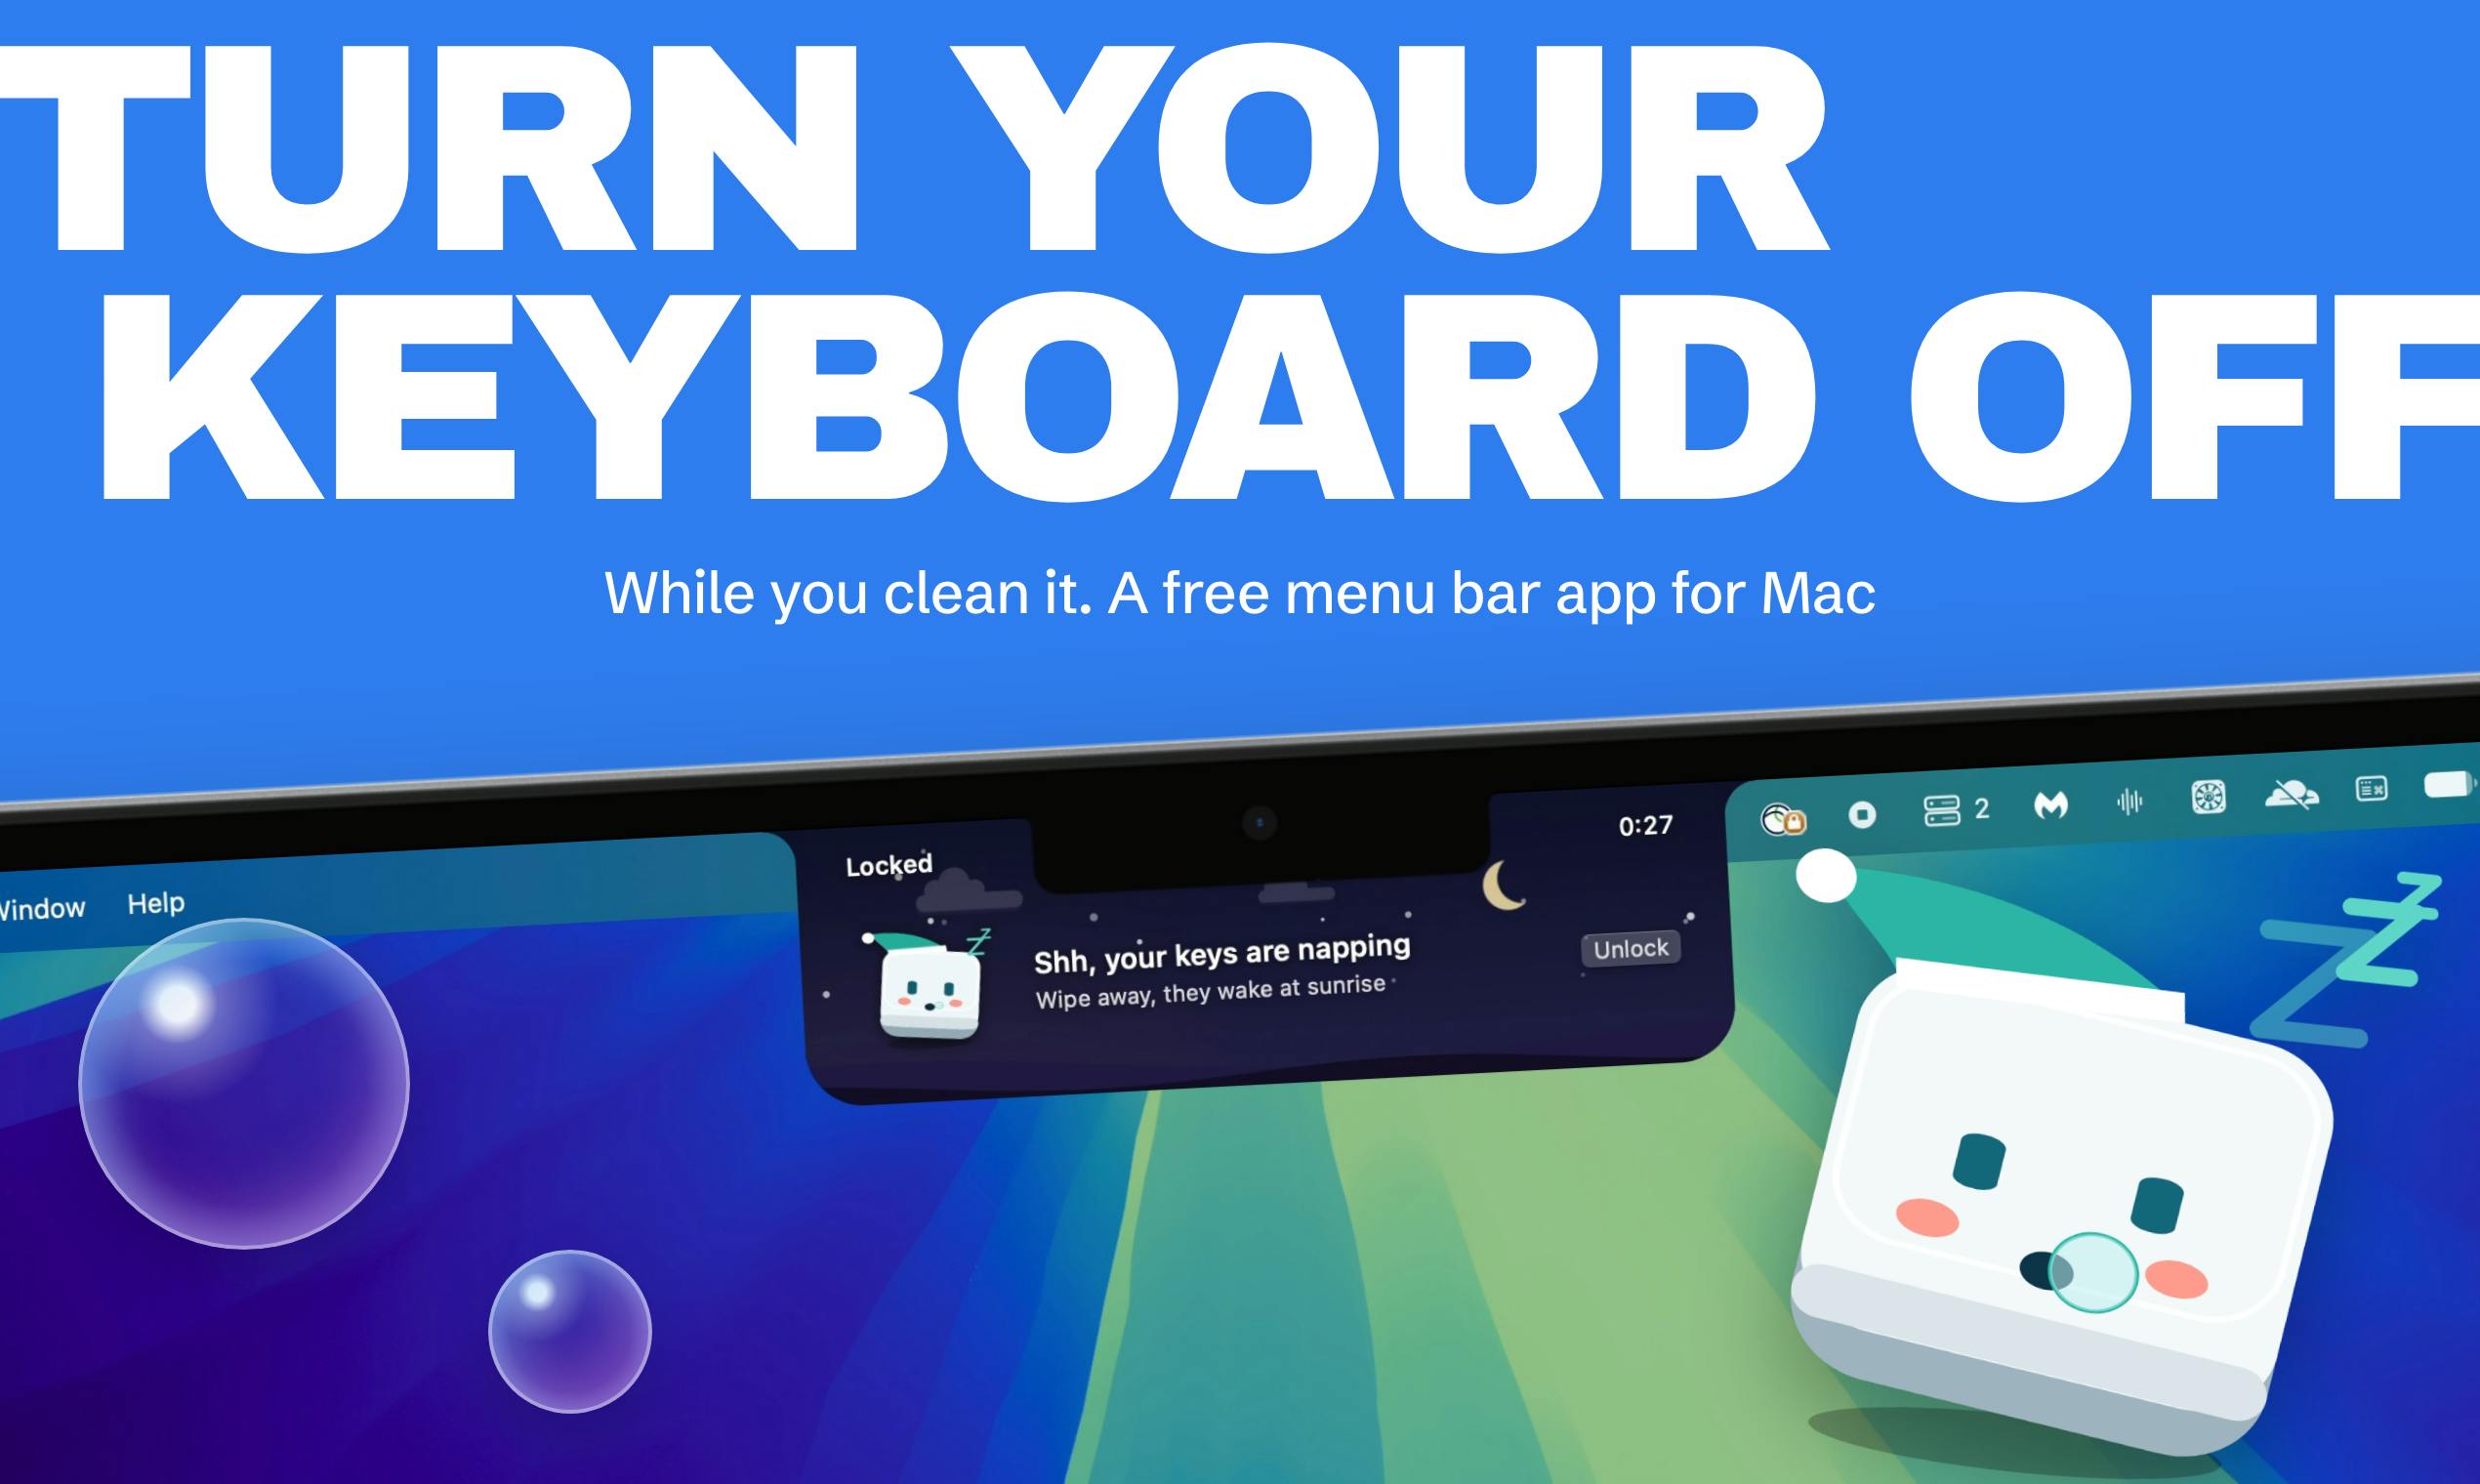
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。