NVIDIA cuPotential:分子动力学模拟的加速新范式

NVIDIA 推出 cuPotential 原语库,以准确且可组合的 GPU 原语加速分子动力学模拟。
NVIDIA 在开发者博客中介绍了 cuPotential,一套面向分子动力学(MD)模拟的 GPU 加速原语库。文章指出,MD 的核心计算循环高度规整但重复次数极多,是 GPU 加速的理想对象,然而通用 GPU 编程模型无法自动把力场计算、邻接表构建、短程与长程相互作用等模式抽象为高效实现。cuPotential 的定位是把这些反复出现的计算模式沉淀为准确且灵活的原语,兼顾数值精度与可组合性,回应 MD 社区在性能与精度之间的长期张力。其目标读者是科研软件开发者,意在降低将自有势函数移植到 GPU 的工程门槛,而非与成熟 MD 引擎正面竞争。不过 NVIDIA 尚未公布性能基准与精度对比数据,实际采纳仍待观察。
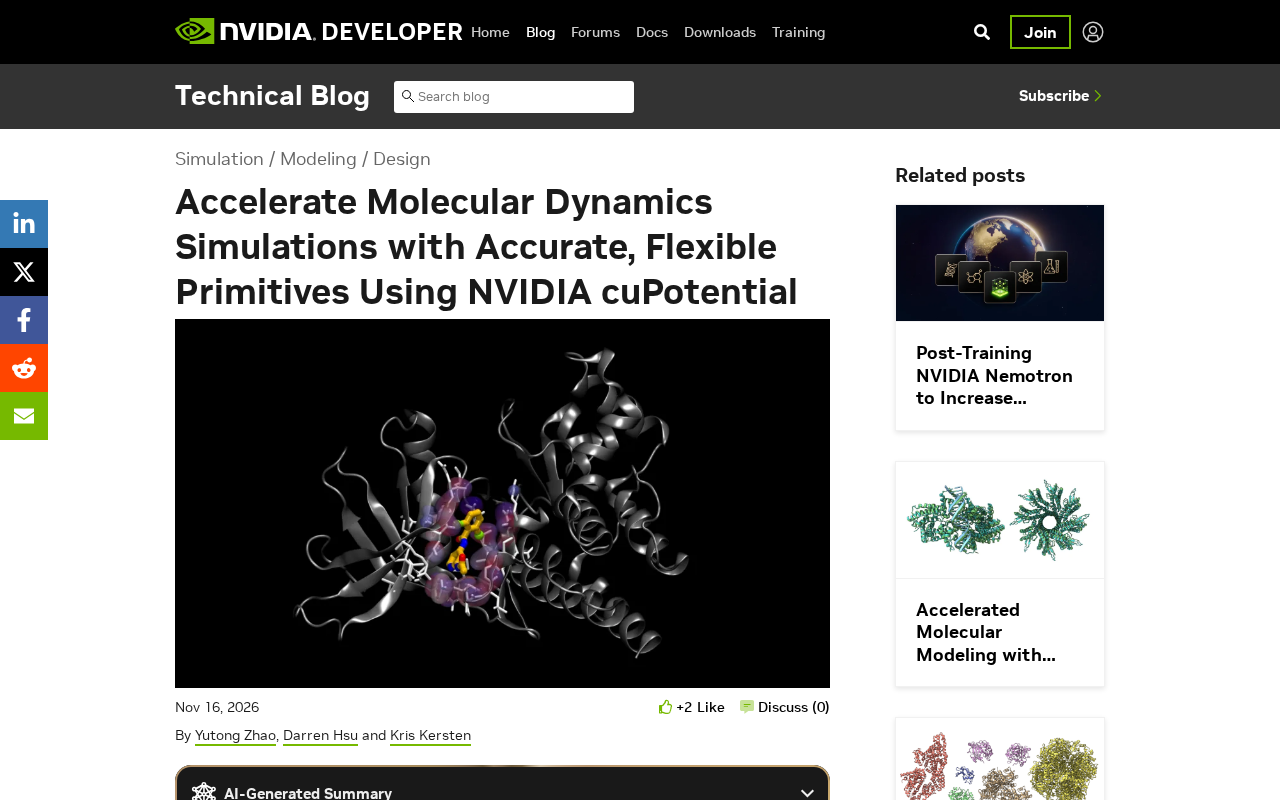
NVIDIA 在开发者博客中介绍了 cuPotential——一套面向分子动力学模拟的加速原语库。对于物理、化学、生物和材料科学领域的研究者来说,分子动力学(MD)是不可或缺的研究工具,而 cuPotential 试图从算术结构层面切入,为这一传统工作负载注入 GPU 加速能力。
分子动力学为何需要专用加速原语
分子动力学模拟的核心计算循环高度规整:每一步迭代都要为体系中每一个粒子计算受力,再据此更新位置与速度。这种「计算力—积分—再计算力」的循环会重复数百万乃至数十亿次,累积的浮点运算量极为可观。
NVIDIA 在博客中指出,正是 MD 的这种算术结构,使其成为 GPU 加速的理想候选。问题在于,通用 GPU 编程模型并不会自动把 MD 中反复出现的力场计算、邻接表构建、短程与长程相互作用等模式抽象成高效实现。研究者往往需要自己重写内核,既费时又容易牺牲精度。cuPotential 的定位,就是把这些反复出现的计算模式沉淀为准确且灵活的原语,让开发者不必从零构建。
力场(force field) 是分子动力学模拟中决定粒子间相互作用形式与参数的一套数学模型,通常由键合项(键伸缩、角弯曲、二面角扭转)和非键合项(范德华、静电)组成。势函数(potential function)则是力场的具体数学表达,粒子所受的力由势能对位置的负梯度给出。正因如此,MD 每一步迭代的核心计算量集中在对势能函数的求值与梯度计算上——这正是 cuPotential 试图用可复用原语覆盖的部分。力场的精度和形式直接决定模拟结果的物理可信度,因此原语库必须在提供 GPU 并行度的同时保持与参考实现对等的数值行为。
邻接表(neighbor list) 与 短程/长程相互作用 是 MD 加速中的两个经典结构性难点。短程力(如范德华作用)随距离迅速衰减,通常在截断半径内直接求和,因此需要为每个粒子维护一份近邻粒子列表,并周期性重建、配合 Verlet 皮肤半径避免每步都重建。长程静电相互作用则不能简单截断,常用 Ewald 求和及其网格化变体(如 PME)把计算拆分为实空间短程项与倒空间长程项。这两类计算模式在 GPU 上的高效实现差异很大,涉及不同的并行粒度、内存访问模式与归约策略,把它们抽象成通用原语正是 cuPotential 试图解决的核心工程问题。
cuPotential 提供了什么
从 NVIDIA 的描述看,cuPotential 的关键词是「准确」与「灵活」并重。这实际上回应了 MD 社区长期存在的一对张力:追求极致性能时,人们倾向于使用单精度甚至降低精度的近似算法;但分子体系对能量守恒和轨迹稳定性极为敏感,精度损失可能让长时间模拟彻底失去物理意义。
把可复用的计算原语做成库,好处是多方面的。研究者可以在保证数值准确性的前提下获得 GPU 并行度;同时原语是可组合的,不同力场、不同系综的模拟都能按需拼装,而不必被绑定在某个单一框架里。这种设计思路与近年来科学计算领域「可组合基础设施」的趋势一致。
对科研工作流的影响
对一线研究者而言,这类原语库降低的是工程门槛而非科学门槛。过去,一个材料科学课题组若想把自有势函数跑在 GPU 上,通常需要专门的并行编程人力;有了现成原语,团队可以把精力集中在势函数本身的物理正确性上。这也是 NVIDIA 选择在开发者博客而非产品发布渠道介绍它的原因——目标读者是那些会直接调用底层接口的科研软件开发者。
文中提到的「单精度甚至降低精度的近似算法」指向 MD 领域常见的 混合精度(mixed precision) 策略。GPU 在 FP32 上的吞吐通常远高于 FP64,而消费级 GPU 的 FP64 能力往往被大幅削减,因此研究者倾向用单精度或更低精度完成力计算以换取速度。但 MD 是长时间积分问题,力的微小舍入误差会逐步累积,可能破坏能量守恒、导致轨迹漂移甚至模拟「爆炸」。常见折中方案是力计算用低精度、积分与累积量用高精度,或在关键求和环节使用补偿求和(Kahan summation)与确定性归约顺序。cuPotential 强调「准确」与「灵活」并重,本质上就是在回应这一精度—性能权衡。
生态位置与值得关注的问题
需要客观看待的是,NVIDIA 此次披露的信息以能力概述为主,尚未给出具体的性能基准、精度对比或与既有 MD 引擎的集成方案。对于严肃的科学计算选型来说,这些数据才是决策依据。cuPotential 能否被主流 MD 软件采纳,还取决于接口设计的通用性以及社区的实际验证。
另一个值得观察的方向是它与 NVIDIA 既有科学计算栈的协同关系。MD 模拟通常不是孤立环节,前后往往衔接可视化、数据分析乃至机器学习势函数训练。原语库若能顺畅嵌入这条流水线,其价值会远超单纯的加速比数字。
小结
cuPotential 代表了一种务实的加速思路:不与成熟 MD 引擎正面竞争,而是把底层计算模式做成高质量积木。对追求精度与灵活性兼得的科研团队来说,这是一条值得关注的路径;但在具体性能承诺兑现之前,保持审慎的期待更为合适。
相关推荐

Claude Mythos 5.2 与 Fable 5.2 错误率异常升高
Claude Mythos 5.2 和 Claude Fable 5.2 出现请求错误率异常升高,官方状态页已标记为调查中。本文梳理事件概况、对开发者的实际影响及应对建议。

ReAct运行时上下文裁剪:Claude Code为何70%就动手
深入解析ReAct运行时的上下文裁剪机制:为什么Claude Code在上下文使用约70%时就触发压缩,工具调用为何占用最多、为何必须成组丢弃,以及代码库为何不需要RAG。基于B站小福哥《分币不掏,学习AI Agent开发》第17节整理。

AI Agent vs LLM:Cursor和Claude Code如何真正工作
深入解析AI Agent与LLM的本质区别:LLM生成代码建议,Agent则通过工具调用修改文件、运行测试。以Spring Boot Bug修复为例,拆解Cursor和Claude Code的工作流、权限控制与验证机制。