Ollama v0.34.4 发布:结构化输出提速,Apple Silicon 优化加强
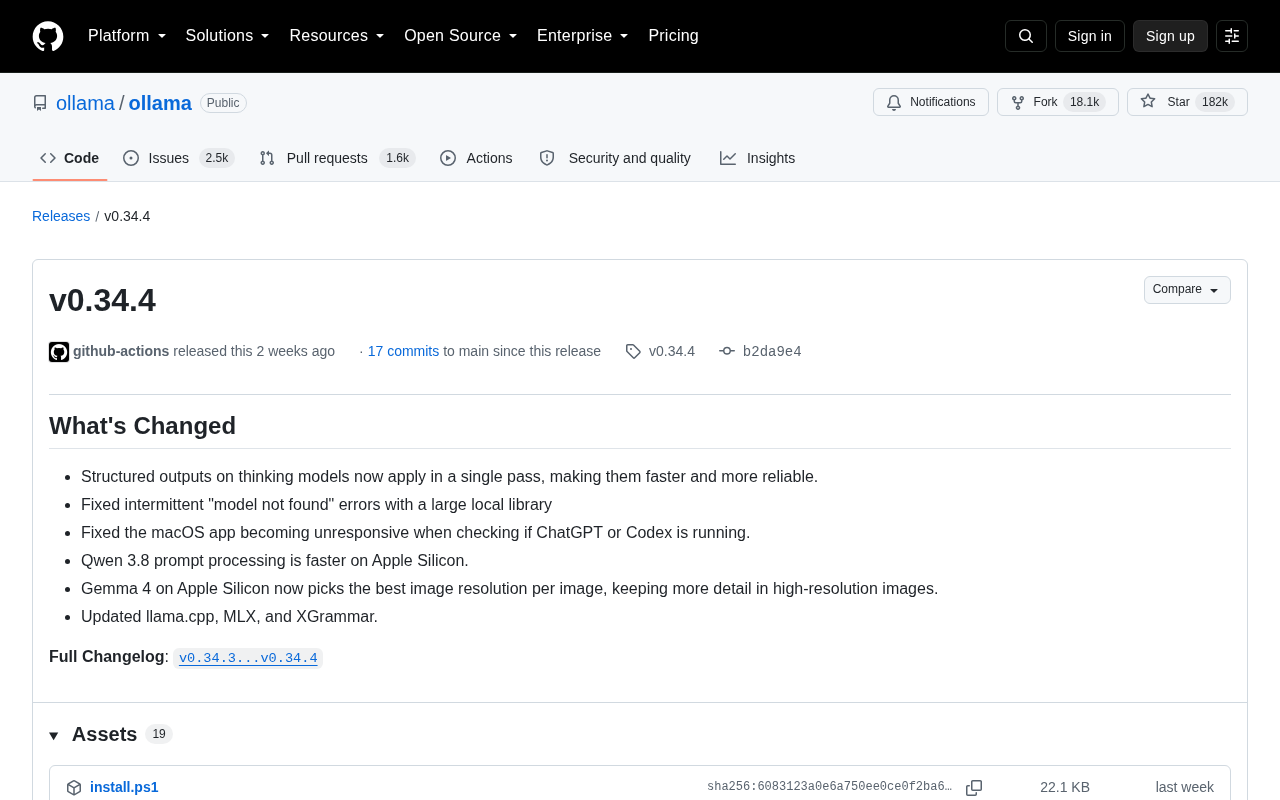
Ollama v0.34.4 重点优化结构化输出性能、修复稳定性问题并强化 Apple Silicon 支持。
Ollama v0.34.4 是一次以稳定性与性能打磨为核心的小版本更新。最显著的改进是将思考型模型的结构化输出由多次处理改为单次处理,使 JSON 等格式化输出更快且更可靠,直接提升 Agent 工作流和函数调用场景的可用性。稳定性层面,新版本修复了本地存储大量模型时偶发的「model not found」错误,以及 macOS 客户端因检测 ChatGPT/Codex 进程导致的应用无响应问题。Apple Silicon 用户同样受益:Qwen 3.8 的提示处理速度得到提升,Gemma 4 在处理图像时会自动选择最佳分辨率以保留更多细节。底层依赖方面,llama.cpp、MLX 和 XGrammar 均同步升级,确保 Ollama 持续吸收上游社区的最新进展。
Ollama 作为目前最流行的本地大模型运行工具之一,持续以高频率迭代更新。最新发布的 v0.34.4 版本虽然是一个小版本更新,但在推理性能、稳定性以及 Apple Silicon 平台适配方面带来了多项实用改进。对于依赖本地部署大模型的开发者和爱好者来说,这些优化直接关系到日常使用体验。
结构化输出的性能与可靠性提升
本次更新最值得关注的改动,是针对思考型模型(thinking models)的结构化输出(structured outputs)优化。此前,在推理模型上生成结构化输出可能需要多次处理,既影响速度也增加了不确定性。
v0.34.4 将这一过程调整为单次处理(single pass),使得结构化输出既更快也更可靠。对于需要模型返回 JSON 等固定格式数据的应用场景——比如函数调用、工具调用、数据提取等——这一改进能显著降低延迟并提升输出的稳定性,减少格式解析失败的情况。
随着越来越多应用将本地模型作为 Agent 工作流的组件,结构化输出的质量直接决定了下游流程的可用性。这类底层优化虽然不显眼,却是提升工程落地可靠性的关键。
**结构化输出(Structured Outputs)**是指强制要求语言模型按照预定义的格式(最常见的是 JSON Schema)生成响应,而非自由文本。其实现方式通常分为两类:一是在推理阶段通过语法约束(Grammar Constraint)动态过滤不合法的 token,确保每一步生成都符合目标格式;二是通过提示工程引导模型输出,再对结果进行解析和校验。**思考型模型(Thinking Models)**在生成最终答案之前会先输出一段内部推理过程(通常包裹在 <think> 标签中),这段「思考」内容并不需要符合结构化格式,只有最终答案部分需要约束。此前多次处理的方案意味着需要分阶段处理思考内容与答案内容,引入了额外的协调开销;单次处理(Single Pass)则将二者统一在同一次推理循环中完成,减少了中间状态转换,从而降低延迟并规避格式拼接时可能出现的边界错误。
修复关键稳定性问题
版本更新同时修复了两个影响使用体验的问题:
- 大型本地模型库下的「model not found」间歇性错误:当用户在本地存储了大量模型时,偶尔会出现找不到模型的报错。这一问题在本版本得到修复,对于管理众多模型的重度用户尤为重要。
- macOS 应用无响应问题:此前 macOS 客户端在检测 ChatGPT 或 Codex 是否正在运行时,可能导致应用卡死无响应。新版本解决了这一兼容性冲突,提升了桌面端的稳定性。
这两处修复都指向实际使用中的痛点,表明 Ollama 团队在功能迭代之外,也在持续打磨产品的稳定性细节。
针对 Apple Silicon 的专项优化
Apple Silicon(M 系列芯片)用户是 Ollama 的重要群体,本次更新为该平台带来了两项针对性优化:
Qwen 模型提示处理加速
在 Apple Silicon 上,Qwen 3.8 的提示处理(prompt processing)速度得到提升。提示处理是模型在生成回复前解析输入内容的阶段,加速这一环节意味着用户能更快获得首个 token,整体响应更流畅。
Gemma 多模态图像处理改进
Gemma 4 在 Apple Silicon 上现在会为每张图片自动选择最佳分辨率,从而在处理高分辨率图像时保留更多细节。对于涉及视觉理解的多模态任务,这意味着更准确的图像识别和更好的输出质量。
这些优化延续了 Ollama 对 Apple 生态的重视,让搭载 M 系列芯片的 Mac 成为运行本地大模型越来越有竞争力的平台。
底层依赖同步更新
除上述改进外,v0.34.4 还更新了多个核心底层依赖,包括 llama.cpp、MLX 和 XGrammar。
- llama.cpp 是 Ollama 的核心推理引擎,其更新通常带来性能提升和对新模型架构的支持;
- MLX 是 Apple 推出的机器学习框架,与前述 Apple Silicon 优化相呼应;
- XGrammar 则与结构化输出、语法约束生成密切相关,其更新也印证了本次结构化输出优化的技术路径。
这些依赖的同步升级,保证了 Ollama 能够及时吸收上游社区的最新进展。
llama.cpp 是由 Georgi Gerganov 发起的开源项目,使用纯 C/C++ 实现对大语言模型的高效推理,无需 GPU 也能在 CPU 上运行量化后的模型。它支持 GGUF 格式的模型文件,是目前本地推理生态的事实标准之一,Ollama 正是以其作为核心推理后端。MLX 是 Apple 专为 Apple Silicon 设计的机器学习框架,充分利用 M 系列芯片统一内存架构(Unified Memory)的特性,使 CPU 与 GPU 可以零拷贝共享张量数据,在边缘推理场景下有显著的内存效率优势。XGrammar 是专注于语法约束生成的库,能够将 JSON Schema 等结构化规范编译为高效的 token 掩码,在每一步解码时实时屏蔽不合法的候选 token,从而在不损失推理速度的前提下保证输出格式的合规性,是实现结构化输出的关键底层组件。
小结
整体来看,Ollama v0.34.4 是一次以「打磨」为主题的版本更新:没有颠覆性的新功能,但在结构化输出、稳定性和 Apple Silicon 性能三个维度都做了扎实的改进。对于使用推理模型构建应用、或在 Mac 上运行本地大模型的用户而言,升级到该版本能获得更快、更稳定的体验。建议相关用户关注官方发布页面并及时更新。
相关推荐
永生经济学:当时间不再稀缺,价值将如何重构?
SFIA 深度探讨永生经济学:当时间不再稀缺,生物永生、数字意识上传、冷冻复活如何重写劳动、财富与价值规则?从专利强制许可到意识复制的劳动力崩塌,再到意义成为新稀缺品,一场关于永生社会的硬核思想实验。
Claude存储架构大变动:本地与云端的界限正在重划
Anthropic正在调整Claude的数据存储架构。10月6日起Pro/Max新会话将仅支持云端存储,Claude Code保留本地选项,企业版存储位置仍由管理员决定。本文梳理本地与云端的最新界限及对不同用户的影响。
共同主导AI安全训练营:法律与治理从业者的实践启示
一位AI安全训练营的共同主导者分享面向法律与治理从业者的培训经验,探讨跨学科教学的挑战、概念翻译的必要性,以及AI治理人才能力建设对行业的深远意义。