Ollama v0.40.1 发布:云端API代理与Windows多项修复

Ollama v0.40.1 预发布版聚焦Windows兼容性修复、云端API代理及CLI流程简化。
Ollama v0.40.1 是一个维护性预发布版本,在 v0.40.0 基础上进行了针对性改进。核心变更包括:服务端新增对云端使用量与余额 API 的代理能力,为混合云场景和后续商业化功能铺路;修复了 Windows 平台上大模型加载时超过 2GiB 的读取越界问题,以及 manifest 处理中的符号链接权限问题;CLI 初次引导流程移除了账户注册步骤,降低新用户上手门槛。此外,本版本还清理了已被 MLX 上游合并的 metal residency 补丁,并修复了多处文档失效链接。三位新贡献者的首次提交也体现了项目社区的持续活跃。
版本概览
Ollama 近日发布了 v0.40.1 预发布版本(Pre-release),由 GitHub Actions 自动化流程于 10 月 7 日构建完成。作为紧随 v0.40.0 之后的维护性更新,这一版本并未引入重量级新特性,而是聚焦于云端能力补强、平台兼容性修复以及文档维护,属于典型的稳定性迭代。
对于依赖 Ollama 在本地运行大语言模型的开发者和爱好者而言,这类小版本更新往往容易被忽视,但它们恰恰是保证日常使用体验顺畅的关键环节。
核心变更解析
云端使用量与余额 API 代理
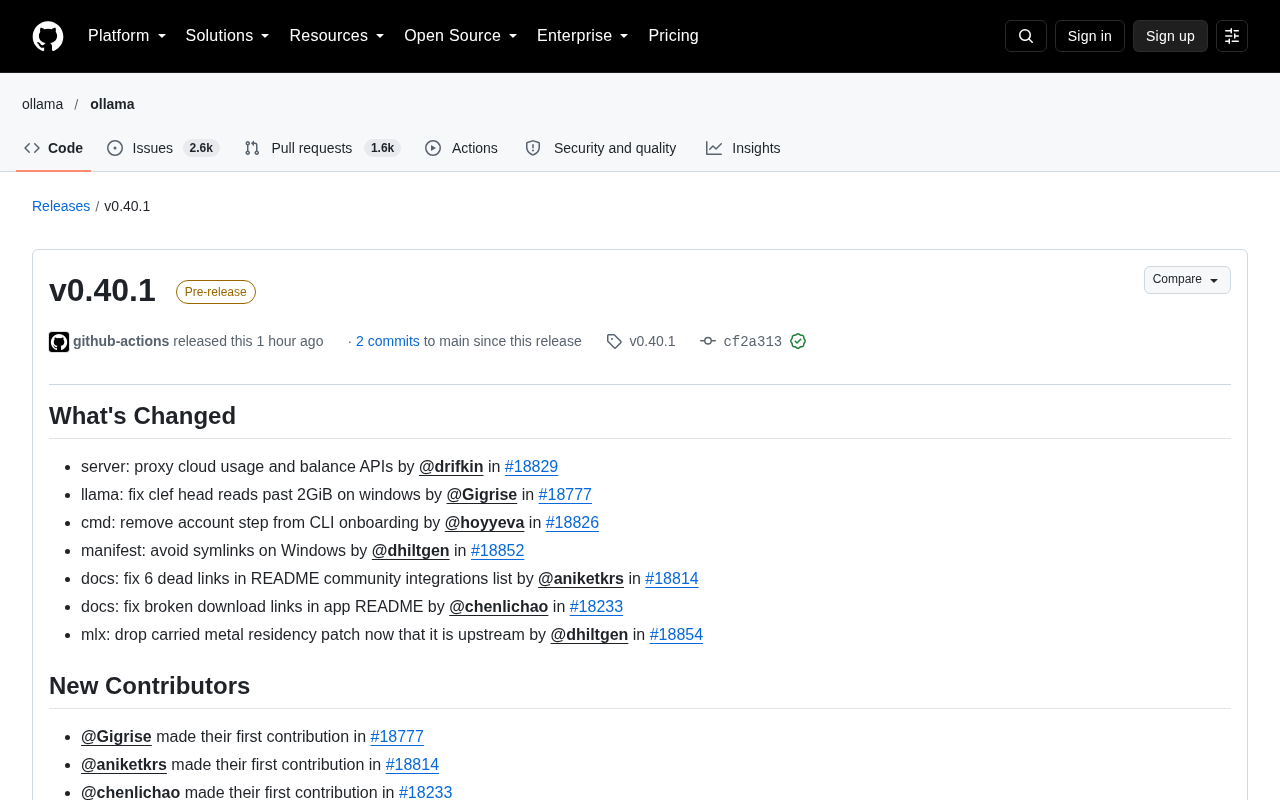
本次更新中最具方向性意义的改动,是由贡献者 drifkin 提交的 server: proxy cloud usage and balance APIs(#18829)。这一改动让 Ollama 服务端可以代理云端的使用量(usage)与余额(balance)查询接口。
从技术脉络看,这反映出 Ollama 正在逐步强化其云端服务的整合能力。随着本地推理与云端能力的边界越来越模糊,服务端作为中间层代理云端 API,既能统一管理入口,也为后续的计费、配额等商业化能力埋下伏笔。
所谓"代理云端 API",是指 Ollama 的本地服务端(server)作为中间层,将客户端对云端使用量和余额接口的请求转发给远程服务,再将响应返回给调用方。这种模式下,开发者无需在客户端代码中硬编码云端服务的地址或凭证,只需与本地的 Ollama 服务交互即可。这一架构对于构建私有化部署或混合云场景尤为重要——它允许团队在同一套 API 接口下,无缝切换本地推理与云端推理,而不必修改上层应用逻辑。余额(balance)与使用量(usage)的查询能力,也为后续实现用量上限控制、成本分摊等企业级功能提供了基础数据支撑。
Windows 平台的两项关键修复
本版本对 Windows 用户尤为友好,包含两项针对性修复:
- 大模型读取越界修复(#18777):由新贡献者 Gigrise 提交,解决了 llama 在 Windows 上读取 clef head 时超过 2GiB 边界的问题。这类涉及大文件内存访问的 Bug 往往只在加载较大模型时才会暴露,修复后能显著提升大模型在 Windows 上的加载稳定性。
- 避免使用符号链接(#18852):由 dhiltgen 提交,让 manifest 处理在 Windows 上规避 symlink。由于 Windows 对符号链接的权限要求与类 Unix 系统存在差异,绕开 symlink 能减少权限相关的部署故障。
2GiB(约 2,147,483,648 字节)是 32 位有符号整数所能表示的最大值,在文件 I/O 或内存映射场景中,若代码使用了有符号 32 位整型来描述偏移量或大小,当文件超过这一阈值时便会发生整数溢出,导致读取位置计算错误乃至程序崩溃。当前主流大语言模型的权重文件动辄数 GB 甚至数十 GB,这类边界问题在小模型测试时往往不会触发,却会在生产级别的较大模型加载时集中暴露。Windows 对符号链接(symlink)的处理与 Linux/macOS 存在本质差异:在 Windows 上创建符号链接通常需要管理员权限或开启"开发者模式",普通用户在标准安装环境下极易因权限不足导致 manifest 操作失败,绕过 symlink 可以消除这一平台特有的权限壁垒。
CLI 引导流程简化
贡献者 hoyyeva 移除了 CLI 初次引导(onboarding)中的账户步骤(#18826)。这一调整降低了新用户上手 Ollama 的门槛——无需在命令行阶段就被要求创建或登录账户,让"开箱即用"的本地体验更加纯粹。
文档与依赖维护
除了功能性改动,本版本还包含多项文档与底层维护工作:
- 修复了 README 社区集成列表中的 6 个失效链接(#18814,贡献者 aniketkrs)
- 修复了 app README 中损坏的下载链接(#18233,贡献者 chenlichao)
- 移除了 MLX 中已上游合并的 metal residency 补丁(#18854,贡献者 dhiltgen),减少了项目自行维护的 patch 负担
其中 MLX 补丁的清理值得关注——它意味着相关优化已被上游项目正式接纳,Ollama 不再需要单独维护这段代码,这是开源协作良性循环的体现。
MLX 是苹果公司开源的机器学习框架,专为 Apple Silicon(M 系列芯片)设计,利用统一内存架构(Unified Memory)实现 CPU 与 GPU 之间的零拷贝数据共享。metal residency 补丁涉及 Metal(苹果的 GPU 计算 API)对显存驻留(residency)的管理优化,能够减少模型推理时 GPU 内存的换入换出开销,提升在 Mac 设备上的推理吞吐量。此前 Ollama 需要在自己的代码库中单独维护这段补丁,以便在上游合并之前就能向用户提供该优化。现在补丁已被 MLX 上游正式接受,Ollama 可以直接通过依赖升级获得这一能力,不再承担额外的 patch 维护成本,也降低了未来版本合并冲突的风险。
对用户意味着什么
v0.40.1 虽是预发布版本,但传递出几个值得留意的信号。Windows 作为用户基数庞大的平台,连续获得针对性修复,说明官方正持续投入提升跨平台一致性体验。云端 API 代理的引入,则预示着 Ollama 在"本地优先"的定位之上,正搭建更完善的云端协同能力。
本次版本还迎来了三位新贡献者(Gigrise、aniketkrs、chenlichao)的首次提交,反映出这一开源项目仍保持着活跃的社区生态。对于普通用户,建议在稳定正式版发布后再升级生产环境;而希望尝鲜或受 Windows 大模型加载问题困扰的用户,则可以优先体验这一预发布版本。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。